Dokumentation
Dokumentation von den Kursen von sysops
- Kostenvergleich Lizenzierte vs. Freie Software
- Die 20 größten Exchange-Skandale, Ausfälle und Sicherheitslücken in 10 Jahren
- Proxmox Vergleich der Storage-Varianten vs. ZFS zu Fuß
- Proxmox 9 und iSCSI SAN mit Multipath
- OPNsense Migration Legacy zu Instance, ohne neues Ausrollen von Konfigurationen
- Backup und Replikation trojanersicher für Proxmox VE mit Miyagi Workflow
- Migration Univention Corporate Server & Kopano nach Zamba AD & Mailcow
- Proxmox Best Practice Setup für ZFS und / oder Ceph im Cluster für Einsteiger (Stand Dezember 2024)
- ZFS Grundlagen am Beispiel Proxmox VE(Stand Dezember 2025)
- Das Ende von Hetzner DNS Robot und ACME API - Stand Januar 2026
- Information zur Sicherung und Wiederherstellung von Windows 10/11-Systemen
- Stand der Technik nach DSGVO am Beispiel Kopano - Was sagt ChatGPT?
- Virtuelle Maschine mit Windows 10 Bios auf Proxmox zu Windows 11 mit UEFI umstellen
- ZFS Grundlagen am Beispiel Proxmox VE(Stand Januar 2025)
- Proxmox
- Verschlüsselung mit Proxmox, ZFS und Debian / Windows
Kostenvergleich Lizenzierte vs. Freie Software
IT-Kostenvergleich für 20 Mitarbeiter: Microsoft 365 Cloud-only vs. Proxmox, Mailcow und OPNsense
Stand: September 2026 · Alle Preise netto und gerundet · Kalkulatorischer Stundensatz: 100 € pro Stunde
Was kostet eine professionelle IT-Infrastruktur für einen Betrieb mit rund 20 Mitarbeitern tatsächlich? Der reine Vergleich einzelner Lizenzpreise reicht dafür nicht aus.
In dieser Analyse werden zwei IT-Modelle gegenübergestellt, die 2026 tatsächlich in kleinen und mittelständischen Unternehmen eingesetzt werden: ein weitgehend serverloses Microsoft-365-Cloud-Modell und eine selbst betriebene Proxmox- und Open-Source-Infrastruktur.
Betrachtet werden nacheinander die laufenden Lizenzkosten, Hardware- und Betriebskosten, Einrichtungskosten, Kosten späterer Versionswechsel sowie die Total Cost of Ownership über fünf Jahre.
Die beiden IT-Lösungen im Überblick
System 1: Microsoft 365 Cloud-only
- Microsoft Entra ID statt lokalem Active Directory
- SharePoint Online und OneDrive statt Fileserver
- Exchange Online
- Microsoft 365 Apps
- Intune
- Windows Autopilot
- Windows Autopatch
- Defender for Business
- Tactical RMM
- Hornetsecurity 365 Total Protection Plan 3
- optional Synology Active Backup for Microsoft 365
- OPNsense Business Edition
- Branchensoftware als SaaS
- keine lokale Virtualisierung
System 2: Proxmox und Open Source
- Proxmox VE Basic
- Samba Active Directory
- Samba Fileserver
- Mailcow Dockerized
- LibreOffice / OnlyOffice
- Tactical RMM mit Amidaware Code Signing
- Proxmox Backup Server
- Checkmk Raw
- Mailpiler für Mail-Archivierung
- OPNsense Business Edition
- Branchensoftware als VM auf Proxmox
Bei einem 20-Mitarbeiter-Betrieb überschneiden sich dabei zahlreiche Funktionen. Active Directory, Exchange, Endpoint-Schutz und Geräteverwaltung sind zumindest teilweise bereits über Microsoft 365 Business Premium abgedeckt.
Ein Vergleich gegen eine solche Doppelstruktur würde die Microsoft-Seite entsprechend verteuern.
1. Laufende Lizenz- und Subscriptionkosten
Grundlage sind 20 Benutzer und etwa 20 verwaltete Arbeitsplätze.
| Funktion | System 1: Cloud-only | Kosten / Jahr | System 2: Open Source | Kosten / Jahr |
|---|---|---|---|---|
| Summe wiederkehrend | ca. 6.900 € | mit kommerziellem EDR | ca. 1.600–1.900 € | |
| Identität, Fileserver, Mail, Office, Intune und Defender | Microsoft 365 Business Premium 20 × 19,06 € × 12 |
ca. 4.574 € | Samba AD, Samba Fileserver, Mailcow und LibreOffice | 0 € |
| Virtualisierung | keine | 0 € | Proxmox VE Basic, 1 Sockel | 370 € |
| Mail-Security, Archivierung und Backup | Hornetsecurity 365 Total Protection Plan 3 20 × 7 € × 12 |
ca. 1.680 € | Mailpiler + Proxmox Backup Server | 0 € Lizenzkosten |
| Fernwartung / RMM | Tactical RMM / Amidaware Tier 1 | ca. 515 € | Tactical RMM / Amidaware Tier 1 | ca. 515 € |
| Monitoring | Microsoft-Plattform und OPNsense-Bordmittel | 0 € | Checkmk Raw | 0 € |
| Firewall | OPNsense Business Edition | 149 € | OPNsense Business Edition | 149 € |
| Endpoint Security | Defender for Business in Business Premium | 0 € zusätzlich | separates EDR erforderlich | ca. 600–900 € |
Alternative: Microsoft 365 mit lokalem Synology-Backup
Wer Microsoft 365 lieber lokal sichert, kann beispielsweise eine Synology DS925+ mit Active Backup for Microsoft 365 einsetzen. Für Active Backup fallen keine zusätzlichen Benutzerlizenzen an.
Damit sinken die jährlichen Softwarekosten im Cloud-Modell auf ungefähr 5.450 Euro, sofern zusätzlich eine günstige Offsite-Kopie vorgesehen wird.
Lizenzkosten im direkten Vergleich
| Microsoft Cloud-only | Proxmox / Open Source | |
|---|---|---|
| Kosten pro Jahr | ca. 6.900 € mit Hornetsecurity ca. 5.450 € mit lokalem Synology-Backup |
ca. 1.035 € ohne EDR ca. 1.600–1.900 € mit EDR |
| Kosten pro Mitarbeiter / Monat | ca. 23–29 € | ca. 4–8 € |
Betrachtet man ausschließlich die Lizenz- und Subscriptionkosten, ist die selbst betriebene Open-Source-Infrastruktur deutlich günstiger. Dieser Vergleich bildet jedoch noch nicht die gesamten Betriebskosten ab.
2. Hardware, Strom und Infrastruktur
Beim Hardwarebedarf kehrt sich das Bild um: Das Cloud-Modell benötigt beim Kunden keinen klassischen Virtualisierungshost.
| Kostenblock | Microsoft Cloud-only | Proxmox / Open Source |
|---|---|---|
| Server / Virtualisierungshost | – | ca. 10.000–12.000 € |
| Backup-Ziel | optional Synology DS925+ mit HDDs: ca. 1.200 € | Proxmox Backup Server: ca. 3.000–5.000 € |
| Firewall-Appliance | ca. 500–900 € | ca. 500–900 € |
| Einmalige Hardwarekosten | ca. 500–2.100 € | ca. 15.500–18.000 € |
| Strom Server und Backup | 0 € | ca. 600–900 € / Jahr |
| USV, Klimatisierung, Serverschrank | 0 € | ca. 100–200 € / Jahr |
Über fünf Jahre werden für den Open-Source-Stack in dieser Kalkulation allein für Hardware, Strom und Infrastruktur ungefähr 19.000 bis 23.500 Euro angesetzt.
Das Cloud-Modell liegt in diesem Bereich bei ungefähr 500 bis 2.100 Euro.
3. Einrichtungskosten
Als kalkulatorischer Dienstleistungssatz werden 100 Euro netto pro Stunde verwendet.
Einrichtung Microsoft 365 Cloud-only
Eine Cloud-Migration ist kein reiner Kopiervorgang. Berechtigungsmodelle ändern sich, Geräte werden von klassischem Domain Join auf Entra Join umgestellt und der Microsoft-365-Tenant muss abgesichert werden.
| Komponente | Arbeitszeit | Kosten |
|---|---|---|
| Gesamt | ca. 33–47 Stunden | ca. 3.300–4.700 € |
| Tenant, Conditional Access, MFA und Admin-Konzept | 4–6 Stunden | 400–600 € |
| Intune-Baseline, Autopilot und Compliance | 6–8 Stunden | 600–800 € |
| SharePoint-Struktur und Datenmigration | 8–12 Stunden | 800–1.200 € |
| Mailmigration nach Exchange Online | 6–10 Stunden | 600–1.000 € |
| 20 Geräte auf Entra Join umstellen | 4–6 Stunden | 400–600 € |
| Hornetsecurity konfigurieren | ca. 2 Stunden | 200 € |
| Tactical RMM | ca. 1 Stunde | 100 € |
| OPNsense | ca. 2 Stunden | 200 € |
Einrichtung Proxmox und Open Source
Durch standardisierte Installationswege und vorbereitete Templates lässt sich die lokale Infrastruktur in dieser Kalkulation deutlich schneller bereitstellen.
| Komponente | Arbeitszeit | Kosten |
|---|---|---|
| Gesamt | ca. 15–17 Stunden | ca. 1.500–1.700 € |
| Proxmox VE inklusive Proxmox Backup Server | ca. 2 Stunden | 200 € |
| Samba DC und Fileserver inklusive Datenübernahme | ca. 3–4 Stunden | 300–400 € |
| Mailcow inklusive Datenübernahme | ca. 4 Stunden | 400 € |
| Checkmk Raw | ca. 1 Stunde | 100 € |
| Tactical RMM | ca. 1 Stunde | 100 € |
| OPNsense | ca. 2 Stunden | 200 € |
| Mail-Archivierung und EDR-Rollout | ca. 2–3 Stunden | 200–300 € |
Einrichtungskosten im direkten Vergleich
| Microsoft Cloud-only | Proxmox / Open Source | |
|---|---|---|
| Arbeitsaufwand | 33–47 Stunden | 15–17 Stunden |
| Einrichtungskosten | 3.300–4.700 € | 1.500–1.700 € |
4. Kosten von Generations- und Versionswechseln
Microsoft Cloud-only
Bei Exchange Online, SharePoint, Entra ID und Intune gibt es keinen klassischen Server-Generationswechsel beim Kunden mehr. Microsoft aktualisiert die Plattform fortlaufend.
| Komponente | Aufwand | Kosten |
|---|---|---|
| Gesamt pro Jahr | ca. 4–5 Stunden | ca. 400–500 € |
| Windows Feature Updates über Intune / Autopatch | ca. 2–3 Stunden / Jahr | 200–300 € |
| OPNsense Major Upgrade | ca. 1 Stunde | 100 € |
| Tactical RMM Upgrade | ca. 1 Stunde | 100 € |
| Neue Server- oder CAL-Lizenzen | – | 0 € |
Proxmox und Open Source
Versionswechsel erfolgen weitgehend über Paketverwaltung, dokumentierte Upgrade-Pfade oder Docker.
| Komponente | Aufwand | Kosten |
|---|---|---|
| Generationswechsel | max. 7 Stunden plus Client-Updates | max. 700 € plus 200–300 € / Jahr |
| Proxmox VE | max. 1 Stunde | 100 € |
| Proxmox Backup Server | max. 1 Stunde | 100 € |
| Samba DC / Fileserver | max. 1 Stunde | 100 € |
| Mailcow | max. 1 Stunde | 100 € |
| Checkmk Raw | max. 1 Stunde | 100 € |
| Tactical RMM | max. 1 Stunde | 100 € |
| OPNsense | max. 1 Stunde | 100 € |
| Windows Feature Updates auf Clients | ca. 2–3 Stunden / Jahr | 200–300 € |
5. Laufender Betrieb
Einer der wichtigsten Kostenblöcke ist der laufende Betrieb. In reinen Lizenzvergleichen wird dieser häufig nicht berücksichtigt.
| Tätigkeit | Microsoft Cloud-only | Proxmox / Open Source |
|---|---|---|
| Server-, Hypervisor- und Backup-Updates | – | ja |
| Mailserver-Pflege | – | ja |
| Defender, Intune, Entra und Hornetsecurity prüfen | ja | – |
| Firewall und Netzwerk | ja | ja |
| Hardware, RAID, Platten und USV überwachen | nur Firewall | ja |
| Geschätzter Aufwand ohne Anwendersupport | ca. 2–4 Stunden / Monat | ca. 6–10 Stunden / Monat |
| Kosten pro Jahr bei 100 €/h | ca. 2.400–4.800 € | ca. 7.200–12.000 € |
Anwendersupport ist in beiden Modellen nicht eingerechnet.
Gesamtkosten über fünf Jahre
| Kostenblock | Microsoft Cloud-only | Proxmox / Open Source |
|---|---|---|
| Gesamtkosten über 5 Jahre | ca. 53.000–68.000 € | ca. 67.000–96.000 € |
| pro Mitarbeiter / Monat | ca. 44–57 € | ca. 56–80 € |
| Lizenz- und Subscriptionkosten | ca. 34.500 € | ca. 8.800 € |
| Hardware, Strom und Infrastruktur | ca. 1.000–2.000 € | ca. 19.000–23.500 € |
| Einrichtung | ca. 3.300–4.700 € | ca. 1.500–1.700 € |
| Versions- und Generationswechsel | ca. 2.000–2.500 € | ca. 1.700–2.200 € |
| Betrieb ohne Anwendersupport | ca. 12.000–24.000 € | ca. 36.000–60.000 € |
Kaufmännische Kernaussage dieser Kalkulation
Betrachtet man ausschließlich Lizenzkosten, ist der Proxmox- und Open-Source-Stack deutlich günstiger.
Werden jedoch zusätzlich Serverhardware, Backup-Hardware, Strom, Infrastruktur und insbesondere laufende Betriebsstunden berücksichtigt, verschiebt sich die Rechnung.
In dieser Kalkulation liegt die Microsoft-365-Cloud-Lösung über fünf Jahre bei etwa 53.000 bis 68.000 Euro, der selbst betriebene Open-Source-Stack bei etwa 67.000 bis 96.000 Euro.
Dieser Unterschied basiert wesentlich auf den angesetzten Hardware- und Betriebsstunden und ist deshalb stark von der tatsächlichen Betriebsorganisation abhängig.
Was eine Microsoft-365-Cloud-only-Lösung voraussetzt
Ein serverloses Cloud-Konzept funktioniert nicht in jeder Umgebung. Vor einer Entscheidung sollten insbesondere folgende Punkte geprüft werden:
- Branchensoftware: Gibt es eine SaaS-Version oder benötigt die Anwendung weiterhin einen Server?
- Datenmengen: CAD-Daten, Videoarchive oder große Bildbestände eignen sich nicht immer ideal für SharePoint und OneDrive.
- Internetanbindung: Eine zweite Internetleitung oder LTE-/5G-Fallback sollte berücksichtigt werden.
- Drucker und Scanner: klassische Scan-to-Folder-Konzepte müssen gegebenenfalls ersetzt werden.
- WLAN-Authentifizierung: ohne lokalen NPS/RADIUS werden alternative Authentifizierungskonzepte benötigt.
- Telefonanlage: eine lokale PBX kann zum letzten lokalen Serversystem werden.
- Mail-Archivierung: Backup und revisionssichere Archivierung sind getrennte Anforderungen.
- Sicherheitskonfiguration: Conditional Access, MFA, Break-Glass-Konten und LAPS müssen aktiv konfiguriert werden.
- Datenschutz: Auftragsverarbeitung, Verfahrensverzeichnis und Datenstandorte müssen dokumentiert werden.
- Exit-Strategie: Unternehmen sollten bereits vor dem Einstieg festlegen, wie Daten und Identitäten später wieder exportiert werden können.
Fazit: Cloud oder Proxmox? Entscheidend ist die Gesamtrechnung
Wer ausschließlich Lizenzkosten betrachtet, sieht im Proxmox- und Open-Source-Stack einen erheblichen Kostenvorteil.
Eine vollständige Total-Cost-of-Ownership-Betrachtung umfasst jedoch auch Serverhardware, Backup-Systeme, Strom, USV, Infrastruktur, Einrichtung, Updates und den laufenden Administrationsaufwand.
In der hier dargestellten Kalkulation liegt das Microsoft-365-Cloud-Modell über fünf Jahre niedriger, weil zentrale Infrastruktur, Hardwarebetrieb und Plattformupdates an Microsoft beziehungsweise weitere Cloud-Anbieter ausgelagert werden.
Der Preis dafür ist eine stärkere Abhängigkeit von Cloud-Diensten und externen Anbietern.
Eine selbst betriebene Proxmox-, Samba-, Mailcow- und OPNsense-Umgebung kann dagegen sinnvoll sein, wenn Datenhoheit, lokale Branchensoftware, große Datenbestände oder Unabhängigkeit von Cloud-Plattformen wichtiger sind als eine möglichst geringe Betriebsverantwortung.
Entscheidend ist deshalb nicht der einzelne Lizenzpreis, sondern die Total Cost of Ownership über mehrere Jahre und die Frage, wer die technische Verantwortung übernehmen soll.
Häufige Fragen zum IT-Kostenvergleich
Was kostet Microsoft 365 Business Premium für 20 Mitarbeiter?
Bei einem angesetzten Preis von 19,06 Euro netto pro Benutzer und Monat ergeben sich für 20 Benutzer rund 4.574 Euro pro Jahr.
Muss Microsoft 365 zusätzlich gesichert werden?
Geschäftskritische Daten aus Exchange Online, OneDrive, SharePoint und Teams sollten unabhängig gesichert werden. Möglich sind beispielsweise Cloud-Backup-Dienste oder eine lokale Synology mit Active Backup for Microsoft 365.
Braucht ein Unternehmen mit 20 Mitarbeitern noch einen Server?
Das hängt insbesondere von der Branchensoftware und den Datenmengen ab. Wenn alle Anwendungen als SaaS verfügbar sind und Daten in Microsoft 365 abgelegt werden können, kann ein lokaler Server entfallen.
Ist Open Source für Unternehmen kostenlos?
Viele Open-Source-Produkte verursachen keine klassischen Lizenzkosten. Trotzdem entstehen Kosten für Hardware, Einrichtung, Administration, Backup, Strom, Monitoring, Endpoint-Security und gegebenenfalls Support.
Was kostet Proxmox VE für kleine Unternehmen?
In dieser Kalkulation wird für Proxmox VE Basic mit rund 370 Euro pro belegtem CPU-Sockel und Jahr gerechnet.
Was kostet OPNsense Business Edition?
In dieser Kalkulation werden rund 149 Euro pro Installation und Jahr angesetzt, jeweils zuzüglich Hardware.
Was kostet Tactical RMM mit Code Signing?
Für Amidaware Tier 1 werden hier rund 600 US-Dollar pro Jahr kalkuliert. Unterstützt werden bis zu 199 Endpunkte, Code Signing ist enthalten.
Warum ist die Cloud-Migration zunächst teurer?
Eine Migration zu Microsoft 365 verändert die Struktur: Fileserver-Berechtigungen müssen für SharePoint neu geplant, Geräte auf Entra Join umgestellt und Sicherheitsrichtlinien für Intune und Conditional Access eingerichtet werden.
Warum können Open-Source-Upgrades günstig sein?
Proxmox, Samba, Mailcow und andere Linux-basierte Systeme verfügen über Paketverwaltung, dokumentierte Upgradepfade oder Docker-basierte Aktualisierungen. Bei standardisierten Umgebungen kann der technische Aufwand deshalb gering bleiben.
Die 20 größten Exchange-Skandale, Ausfälle und Sicherheitslücken in 10 Jahren
Microsoft Exchange gehört seit Jahrzehnten zu den wichtigsten E-Mail-Plattformen für Unternehmen. Gleichzeitig war die Plattform immer wieder von kritischen Sicherheitslücken, erfolgreichen Angriffen und teilweise weltweiten Ausfällen betroffen.
Diese Übersicht zeigt die 20 bedeutendsten Vorfälle rund um Exchange Server On-Premises, Exchange-Hybridumgebungen und Exchange Online in Microsoft 365. Berücksichtigt werden bekannte Schwachstellen, tatsächliche Angriffe, Cloud-Ausfälle und organisatorische Versäumnisse. Stand der Übersicht: 17. September 2026.
Bewertung:
🔴 Kritische Sicherheitslücke oder erfolgreicher Angriff
🟠 Hohes Sicherheits- oder Verfügbarkeitsrisiko
🟡 Bedeutender Ausfall, Softwarefehler oder Governance-Vorfall
Exchange Server On-Premises und Hybrid
☐ 1. ProxyLogon und HAFNIUM: massenhafte Übernahme von Exchange-Servern
Zeitpunkt: März 2021
Einstufung: 🔴 Kritische Zero-Day-Angriffskette
Betroffen: Exchange Server 2010, 2013, 2016 und 2019
Die Schwachstellen CVE-2021-26855, CVE-2021-26857, CVE-2021-26858 und CVE-2021-27065 ermöglichten den Zugriff auf Exchange-Server ohne reguläre Anmeldung. Angreifer konnten Schadcode mit SYSTEM-Rechten ausführen, E-Mails entwenden und dauerhafte Webshells auf den Servern hinterlegen.
Besonders kritisch war, dass die spätere Installation der Updates bereits vorhandene Webshells nicht automatisch beseitigte. Ein gepatchter Server konnte daher weiterhin kompromittiert sein.
- Aktuelles Cumulative Update und sämtliche Security Updates installieren.
- IIS-, ECP-, OAB- und EWS-Protokolle forensisch untersuchen.
- Exchange-Verzeichnisse auf unbekannte ASPX-Webshells prüfen.
- Administrator- und Dienstkonten nach einer Kompromittierung ändern.
Quellen: Microsoft Incident Guidance | CISA Advisory AA21-062A
☐ 2. ProxyShell: vollständige Remoteübernahme
Zeitpunkt: 2021
Einstufung: 🔴 Aktiv ausgenutzte RCE-Angriffskette
CVE: CVE-2021-34473, CVE-2021-34523 und CVE-2021-31207
ProxyShell kombinierte drei Schwachstellen. Angreifer konnten die Exchange-Authentifizierung umgehen, Berechtigungen erweitern und schließlich Schadcode oder Webshells ausführen. Die Angriffskette wurde später unter anderem zur Verteilung von Ransomware und Kryptominern eingesetzt.
- OWA und ECP nicht unnötig direkt im Internet veröffentlichen.
- IIS-Protokolle auf ungewöhnliche Autodiscover- und ECP-Aufrufe prüfen.
- Exchange PowerShell auf erforderliche Systeme und Administratoren begrenzen.
Quellen: CVE-2021-34473 | CVE-2021-34523 | CVE-2021-31207
☐ 3. ProxyNotShell: erneut ausgenutzte Exchange-Zero-Days
Zeitpunkt: September 2022
Einstufung: 🔴 SSRF und Remote Code Execution
CVE: CVE-2022-41040 und CVE-2022-41082
Ein Angreifer mit gültigen Zugangsdaten konnte über Autodiscover und die Exchange-PowerShell Befehle auf dem Server ausführen. Microsoft stellte zunächst mehrfach angepasste URL-Rewrite-Regeln bereit, bevor vollständige Sicherheitsupdates verfügbar waren.
- Aktuelle Exchange-Sicherheitsupdates installieren.
- Frühere provisorische Rewrite-Regeln kontrollieren und dokumentieren.
- Exchange PowerShell nicht allgemein aus dem Internet erreichbar machen.
☐ 4. CVE-2025-53786: Vom lokalen Exchange in die Microsoft-Cloud
Zeitpunkt: August 2025
Einstufung: 🔴 Kritische Hybrid-Rechteausweitung
In bestimmten Hybridbereitstellungen konnte ein Angreifer mit administrativem Zugriff auf den lokalen Exchange-Server möglicherweise seine Berechtigungen auf Exchange Online ausweiten. Damit konnte die Kompromittierung eines On-Premises-Servers zum Sicherheitsvorfall in der Cloud werden.
- Aktuelle Exchange-Sicherheitsupdates installieren.
- Microsofts dedizierte Exchange-Hybridanwendung einrichten.
- Alte gemeinsam verwendete Service Principals entfernen.
- Entra- und Exchange-Auditlogs auf ungewöhnliche App-Zugriffe prüfen.
Quellen: Microsoft CVE-2025-53786 | CISA-Warnung
☐ 5. OWASSRF: Umgehung bisheriger ProxyNotShell-Schutzmaßnahmen
Zeitpunkt: Dezember 2022
Einstufung: 🔴 Remote Code Execution
CVE: CVE-2022-41080 und CVE-2022-41082
Die Angriffskette zeigte, dass die bisherigen URL-Filter und ProxyNotShell-Schutzmaßnahmen nicht alle Angriffswege beseitigten. Angreifer konnten über Outlook Web Access erneut die Exchange-PowerShell erreichen und Code ausführen.
Quellen: CVE-2022-41080 | CVE-2022-41082
☐ 6. CVE-2020-0688: statische kryptografische Schlüssel
Zeitpunkt: Februar 2020
Einstufung: 🔴 Remote Code Execution nach Anmeldung
Exchange verwendete bekannte statische Schlüssel zur Absicherung von ViewState-Daten. Ein Angreifer mit den Zugangsdaten eines beliebigen Postfachbenutzers konnte präparierte Daten erzeugen und unter Umständen Code mit SYSTEM-Rechten ausführen.
Quellen: Microsoft CVE-2020-0688 | Microsoft Security Update
☐ 7. PrivExchange: von Exchange zum Domain Admin
Zeitpunkt: 2018 und 2019
Einstufung: 🔴 NTLM Relay und Rechteausweitung
CVE: CVE-2018-8581
Durch weitreichende Exchange-Berechtigungen im Active Directory und einen NTLM-Relay-Angriff konnte die Kompromittierung des Exchange-Servers bis zur vollständigen Übernahme der Windows-Domäne führen.
- LDAP Signing und Channel Binding aktivieren.
- NTLM-Verwendung soweit möglich reduzieren.
- Exchange-Berechtigungen im Active Directory überprüfen.
Quelle: Microsoft CVE-2018-8581
☐ 8. CVE-2024-21410: NTLM-Leak und Rechteausweitung
Zeitpunkt: Februar 2024
Einstufung: 🔴 Kritische Rechteausweitung
CVSS: 9,8
Präparierte Nachrichten konnten die Weitergabe von NTLM-Informationen auslösen. Diese ließen sich möglicherweise für Relay-Angriffe verwenden. Microsoft aktivierte im Rahmen der Absicherung Extended Protection standardmäßig für aktuelle Exchange-Versionen.
- Extended Protection überprüfen.
- Ausgehende SMB-Verbindungen ins Internet blockieren.
- NTLM-Relay-Schutz für LDAP, IIS und weitere Dienste aktivieren.
Quelle: Microsoft CVE-2024-21410
☐ 9. Exchange-Y2K22: Mailtransport zum Jahreswechsel gestoppt
Zeitpunkt: 1. Januar 2022
Einstufung: 🟡 Schwerer Softwarefehler
Die Versionsnummer der Exchange-Malware-Scanning-Engine passte ab dem Jahr 2022 nicht mehr in den vorgesehenen Integer-Wert. Dadurch liefen Transportwarteschlangen voll und E-Mails wurden nicht mehr zugestellt.
- Transportwarteschlangen kontinuierlich überwachen.
- Nicht nur Port 25, sondern die tatsächliche Zustellung testen.
- Notfallverfahren für Probleme mit der Malware-Engine dokumentieren.
☐ 10. CVE-2026-42897: aktiv ausgenutzte OWA-Sicherheitslücke
Zeitpunkt: Mai bis Juli 2026
Einstufung: 🔴 Aktiv ausgenutzte Schwachstelle
CVSS: 8,1
Eine präparierte E-Mail konnte beim Öffnen in Outlook Web Access unter bestimmten Bedingungen JavaScript im Browserkontext des Benutzers ausführen. Betroffen waren Exchange 2016, Exchange 2019 und Exchange Server Subscription Edition.
- Juli-2026-Sicherheitsupdates installieren.
- Exchange Emergency Mitigation Service aktivieren.
- OWA nicht mit Internet Explorer oder IE-Modus verwenden.
Quellen: Microsoft CVE-2026-42897 | Exchange-Sicherheitsupdates 2026 | CISA KEV-Hinweis
Exchange Online und Microsoft 365
☐ 11. Storm-0558: gestohlener Microsoft-Schlüssel öffnet Behördenpostfächer
Zeitpunkt: Mai bis Juni 2023
Einstufung: 🔴 Cloud-Sicherheits- und Governance-Skandal
Ein chinesischer Angreifer verwendete einen erlangten Microsoft-Consumer-Signaturschlüssel und eine fehlerhafte Tokenprüfung. Damit wurden Tokens erzeugt, die den Zugriff auf Exchange Online und Outlook Web Access ermöglichten. Betroffen waren etwa 25 Organisationen, darunter westliche Regierungsstellen.
- Unified Audit Log und MailItemsAccessed aktivieren.
- Ausreichende Aufbewahrungsdauer für Auditdaten konfigurieren.
- Ungewöhnliche OWA-, Graph- und EWS-Zugriffe überwachen.
Quelle: Microsofts Storm-0558-Bericht
☐ 12. Midnight Blizzard kompromittiert Microsofts eigene E-Mail-Umgebung
Zeitpunkt: November 2023 bis Januar 2024
Einstufung: 🔴 Sicherheits- und Governance-Skandal
Russische Angreifer kompromittierten per Password Spray ein altes Microsoft-Testkonto ohne MFA. Anschließend missbrauchten sie privilegierte OAuth-Anwendungen und erhielten Zugriff auf Exchange-Online-Postfächer von Führungskräften sowie Mitarbeitern aus Sicherheits- und Rechtsabteilungen.
- MFA ausnahmslos auch für Test- und Dienstkonten erzwingen.
- Ungenutzte Mandanten und Service Principals entfernen.
- ApplicationImpersonation und full_access_as_app kontrollieren.
- OAuth-Anwendungen mit Zugriff auf EWS oder Microsoft Graph überwachen.
Quellen: Microsoft Incident Guidance | Bericht zum Angriff
☐ 13. Weltweite Outlook- und Exchange-Störung EX1464935
Zeitpunkt: September 2026
Einstufung: 🟡 Weltweiter Cloud-Ausfall
Anwender konnten sich nicht anmelden, Postfächer synchronisierten nicht und Nachrichten ließen sich teilweise weder versenden noch empfangen. Die Störung betraf eine zentrale Komponente der Exchange-Online-Infrastruktur.
- Incident EX1464935 für SLA- und Risikonachweise archivieren.
- Notfallkommunikation unabhängig von Microsoft 365 bereithalten.
- Anwender vor dem mehrfachen Versand wartender E-Mails warnen.
☐ 14. Exchange Online und Outlook fallen weltweit aus
Zeitpunkt: 25. und 26. November 2024
Einstufung: 🟡 Großer Cloud-Ausfall
Eine Änderung in Microsofts Infrastruktur beeinträchtigte Exchange Online, Outlook und die Kalenderfunktionen von Teams. Die Wiederherstellung dauerte deutlich länger als ursprünglich erwartet.
- Kritische Kontaktdaten außerhalb von Exchange speichern.
- Alternative Kommunikationswege regelmäßig testen.
- Service-Health-Meldungen für mögliche SLA-Ansprüche archivieren.
☐ 15. Fehlerhafte Codeänderung legt Microsoft 365 lahm
Zeitpunkt: 1. März 2025
Einstufung: 🟡 Globaler Cloud-Ausfall
Incident: MO1020913
Outlook, Exchange und weitere Microsoft-365-Dienste waren über mehrere Stunden nicht erreichbar. Microsoft führte den Vorfall auf eine problematische Codeänderung zurück und stellte die Dienste durch einen Rollback wieder her.
Quelle: Analyse zu MO1020913
☐ 16. 14-stündiger Exchange-Online-Ausfall
Zeitpunkt: 11. und 12. September 2025
Einstufung: 🟡 Regionaler Großausfall
Incident: EX1151485
Anmeldung, Mailboxzugriff, Kalender und Mailzustellung waren vor allem in Nordamerika beeinträchtigt. Als Ursache wurde eine unerwartet hohe CPU-Auslastung in Teilen der Exchange-Online-Infrastruktur genannt.
Quelle: Bericht zu EX1151485
☐ 17. Exchange Online durch Layer-7-DDoS beeinträchtigt
Zeitpunkt: Juni 2023
Einstufung: 🟠 Angriff auf die Verfügbarkeit
Die Gruppe Storm-1359 führte HTTP-Flood-, Cache-Bypass- und Slowloris-Angriffe gegen Microsoft-Dienste durch. Microsoft bestätigte zeitweise Einschränkungen der Verfügbarkeit, sah jedoch keine Hinweise auf den Zugriff auf Kundendaten.
Quelle: Microsofts DDoS-Stellungnahme
☐ 18. Infrastrukturfehler bei Exchange Online im Januar 2026
Zeitpunkt: 22. Januar 2026
Einstufung: 🟡 Großer regionaler Ausfall
Teile der nordamerikanischen Infrastruktur verarbeiteten den Datenverkehr nicht mehr korrekt. Benutzer erhielten unter anderem den temporären SMTP-Fehler 451 4.3.2. Microsoft musste den Verkehr auf funktionsfähige Infrastruktur umleiten.
- Eigene Systeme müssen temporäre SMTP-Fehler automatisch wiederholen.
- Monitoring muss 4xx-Verzögerungen von endgültigen 5xx-Fehlern unterscheiden.
- Bei Cloud-Ausfällen nicht vorschnell lokale Outlook-Profile löschen.
Quelle: Bericht zum Ausfall
☐ 19. Exchange Online verschiebt legitime E-Mails in Quarantäne
Zeitpunkt: Februar 2026
Einstufung: 🟡 Fehlkonfiguration der Filter
Eine aktualisierte URL-Erkennungsregel stufte legitime Links und Nachrichten fälschlicherweise als Phishing ein. Dadurch wurden geschäftliche E-Mails weltweit in die Quarantäne verschoben.
- Quarantänevolumen und plötzliche Ausschläge überwachen.
- Freigaben von Nachrichten revisionssicher dokumentieren.
- Automatische Klassifizierungen regelmäßig durch Stichproben prüfen.
Quelle: Bericht zur Fehlklassifizierung
☐ 20. Unzureichende Transparenz bei Exchange-Online-Ausfällen
Zeitraum: fortlaufend
Einstufung: 🟡 Governance- und Cloudrisiko
Detaillierte Ursachen, Incident-IDs und Abschlussberichte sind häufig nur im tenantbezogenen Microsoft-365-Admin-Center sichtbar. Öffentliche Statusseiten bieten oftmals keine dauerhaft verfügbare und vollständige Historie. Das erschwert unabhängige Ursachenanalysen, SLA-Nachweise und langfristige Risikobewertungen.
- Service-Health-Meldungen automatisiert archivieren.
- Incident-ID, Beginn, Ende und geschäftliche Auswirkung dokumentieren.
- Eigene externe Verfügbarkeitsmessungen einsetzen.
- Mögliche SLA-Gutschriften fristgerecht beantragen.
Weiterführende Informationen: Microsoft 365 Service Health | Microsoft Graph Service Communications API
Was zeigen die Exchange-Sicherheitsvorfälle?
Die Vorfälle belegen nicht, dass grundsätzlich nur eine Betriebsform sicher oder unsicher ist. Vielmehr verschieben sich die Verantwortlichkeiten und Risiken:
- Exchange On-Premises: Das größte Risiko ist ein ungepatchter und direkt aus dem Internet erreichbarer Server.
- Exchange Hybrid: Eine lokale Kompromittierung kann über Vertrauensstellungen auch die Cloud gefährden.
- Exchange Online: Microsoft übernimmt Plattformbetrieb und Updates, nicht jedoch alle Risiken durch Identitäten, OAuth-Apps, Fehlkonfigurationen und kompromittierte Benutzerkonten.
- Cloudabhängigkeit: Bei einer zentralen Störung können Kunden die Fehlerbehebung kaum beeinflussen und sind auf Microsofts Kommunikation angewiesen.
Kompakte Exchange-Sicherheitscheckliste
☐ Unterstützte Exchange-Version und aktuelles CU verwenden
☐ Security Updates zeitnah installieren
☐ Exchange Health Checker regelmäßig ausführen
☐ OWA und ECP nicht unnötig direkt veröffentlichen
☐ MFA für Administratoren und Benutzer erzwingen
☐ Alte Konten, Test-Tenants und OAuth-Anwendungen entfernen
☐ ApplicationImpersonation und App-only-Berechtigungen kontrollieren
☐ Extended Protection aktivieren und überprüfen
☐ IIS-, Exchange-, Entra- und Unified-Audit-Logs zentral sichern
☐ Mailfluss und Transportwarteschlangen aktiv überwachen
☐ Notfallkommunikation außerhalb von Microsoft 365 vorhalten
☐ Service-Health-Vorfälle und SLA-relevante Ausfälle archivieren
Häufige Fragen zu Exchange-Sicherheit und Ausfällen
Ist Exchange Online sicherer als ein eigener Exchange-Server?
Exchange Online reduziert das Risiko ungepatchter Server und nimmt dem Unternehmen einen großen Teil des Plattformbetriebs ab. Dafür entstehen neue Abhängigkeiten von Microsoft, der Cloudidentität und der Verfügbarkeit der Microsoft-365-Infrastruktur. Automatisch sicher ist Exchange Online daher nicht.
Ist ein aktueller Exchange-Server noch direkt angreifbar?
Jede öffentlich erreichbare Anwendung kann neue Schwachstellen enthalten. Exchange sollte deshalb vollständig aktualisiert, überwacht und möglichst durch zusätzliche Zugriffsschutzmaßnahmen abgesichert werden.
Reicht es, Exchange-Sicherheitsupdates zu installieren?
Nein. Wurde eine Schwachstelle bereits ausgenutzt, beseitigt das Update möglicherweise die Sicherheitslücke, aber nicht automatisch Webshells, gestohlene Zugangsdaten oder andere Hintertüren. In diesem Fall ist eine forensische Untersuchung erforderlich.
Kann ein lokaler Exchange die Microsoft-Cloud gefährden?
Ja. Besonders in Hybridumgebungen existieren Vertrauensstellungen zwischen lokalem Exchange, Entra ID und Exchange Online. CVE-2025-53786 zeigte, dass eine lokale Kompromittierung unter bestimmten Voraussetzungen bis in die Cloud reichen kann.
Was passiert bei einem Exchange-Online-Ausfall?
Kunden können die eigentliche Störung nicht selbst reparieren. Wichtig sind deshalb alternative Kommunikationswege, ein lokaler Outlook-Cache, dokumentierte Notfallverfahren und die Archivierung der Microsoft- Service-Health-Meldungen.
Proxmox Vergleich der Storage-Varianten vs. ZFS zu Fuß
Proxmox VE Storage im Vergleich: Ceph, ZFS, SAN/iSCSI und sichere ZFS-Replikation
Stand: 31. August 2026
Hier der anschliessende YouTube Check zum Artikel
Welche Storage-Lösung passt zu Proxmox VE: Ceph RBD, lokales ZFS oder ein SAN mit iSCSI und klassischem LVM? Dieser Praxisvergleich erklärt die wichtigsten Unterschiede bei Hochverfügbarkeit, Snapshots, Live-Migration, Thin Provisioning und Wiederherstellung. Anschließend zeigen wir, wie automatische ZFS-Snapshots, Pull-Replikation mit zsync, GUID-Kontrolle mit checkzfs.py und der Miyagi-Workflow eine mehrstufige Backup- und Replikationsstrategie bilden.
Kurzantwort: Ceph, ZFS oder iSCSI?
- Lokales ZFS eignet sich besonders für einzelne Proxmox-Server und kleinere Cluster. Es bietet Prüfsummen, Snapshots, Clones und eine einfache Replikation zwischen ZFS-Systemen.
- Ceph RBD ist für verteilten, hochverfügbaren Shared Storage in größeren Proxmox-Clustern gedacht. Ceph repliziert Daten intern und vermeidet einen einzelnen Storage-Kopf.
- iSCSI mit LVM thick ist sinnvoll, wenn bereits ein professionelles SAN vorhanden ist. Der Storage ist gemeinsam nutzbar, die eigentliche Redundanz und Hochverfügbarkeit liefert jedoch das SAN.
- ZFS per Script ersetzt die Proxmox-Oberfläche nicht. Es erweitert sie um feinere Snapshot-Aufbewahrung, Pull-Replikation, unabhängige Kontrolle und automatisierte Wiederherstellungswege.
Inhalt
- Ceph, ZFS und iSCSI im Vergleich
- Proxmox-Funktionen und Storage-Abhängigkeiten
- Proxmox GUI versus ZFS-Kommandozeile
- Automatische ZFS-Snapshots
- Snapshots, Rollbacks, Clones und Snapdirs
- Replace und RAIDZ-Expansion
- Spares, L2ARC, SLOG und Special Devices
- ZFS Pull-Replikation mit zsync
- Replikation mit checkzfs.py kontrollieren
- Trojanerresistenter Miyagi-Workflow
- Häufige Fragen
Proxmox Storage: Ceph RBD, lokales ZFS und iSCSI/LVM im Vergleich
| Funktion oder Eigenschaft | Ceph RBD | Lokales ZFS | iSCSI + LVM thick |
|---|---|---|---|
| Gemeinsamer Cluster-Storage | Ja | Nein | Ja |
| Verteilte Speicherung | Ja | Nein | Nur wenn das SAN sie bereitstellt |
| Kein einzelner Storage-Kopf | Ja, bei korrektem Clusteraufbau | Nein | Abhängig vom SAN |
| Thin Provisioning | Ja | Optional mit sparse |
Nein |
| Feste Platzreservierung | Steuerbar | Über ZFS-Reservation | Standard |
| Snapshots | Ja | Ja | Für VMs ab Proxmox VE 9 über Volume Chains |
| Linked Clones | Ja | Ja | Nein |
| Full Clones | Ja | Ja | Ja |
| VM- und LXC-Datenträger | Ja | Ja | Ja, über LVM |
| Live-Migration ohne Kopieren der VM-Disk | Ja | Nein | Ja |
| Migration mit Storage-Kopie | Ja | Ja | Ja |
| Storage-Replikation | Ceph-intern | Asynchron zwischen ZFS-Systemen | Üblicherweise SAN-intern |
| Selbstheilung | Verteilt im Ceph-Cluster | Lokal innerhalb des ZFS-Pools | Aufgabe des SAN |
| Prüfsummen gegen stille Datenfehler | Ceph-intern | Nativ durch ZFS | Abhängig vom SAN |
| Typischer Einsatz | Größerer HA-Cluster | Einzelserver oder kleiner Cluster | Vorhandenes zentrales SAN |
Ceph RBD ist ein verteilter Block-Storage mit Thin Provisioning, Redundanz, Snapshots und Clones. Lokales ZFS bietet ebenfalls Snapshots und Clones, ist jedoch kein Shared Storage. Reines iSCSI stellt LUNs bereit, definiert aber keine allgemeine Speicherplatzverwaltung. Deshalb wird häufig eine große gemeinsame iSCSI-LUN mit klassischem LVM kombiniert. Weitere Details enthält die offizielle Proxmox-VE-Storage-Dokumentation.
Direktes iSCSI, iSCSI mit LVM und ZFS over iSCSI
- Direktes iSCSI: Das SAN stellt fertige LUNs bereit. Der Storage ist shared, bietet über das Proxmox-iSCSI-Backend aber keine nativen Snapshot- oder Clone-Funktionen.
- iSCSI + klassisches LVM: Eine große gemeinsame LUN enthält eine von Proxmox verwaltete Volume Group. Speicher wird thick zugeteilt; Proxmox übernimmt das clusterweite Locking.
- ZFS over iSCSI: ZFS läuft auf einem entfernten Storage-System. Proxmox erzeugt dort per SSH ZVOLs und exportiert sie als iSCSI-LUNs. Ohne redundanten Storage-Kopf kann dieses System zum Single Point of Failure werden.
Welche Proxmox-Funktionen hängen vom Storage ab?
| Proxmox-Funktion | Ceph | Lokales ZFS | iSCSI thick |
|---|---|---|---|
| KVM-VMs und LXC-Container | Ja | Ja | Ja |
| HA-Neustart auf einem anderen Node | Ja | Nur mit Replikat oder Storage-Wiederherstellung | Ja |
| Live-Migration | Ohne Disk-Kopie | Mit Disk-Kopie | Ohne Disk-Kopie |
| VM-Snapshot inklusive RAM-Zustand | Ja | Ja | Versions- und Konfigurationsabhängig |
| Templates und Linked Clones | Ja | Ja | Keine Linked Clones |
| Backup mit Proxmox Backup Server | Ja | Ja | Ja |
| Online-Vergrößerung einer VM-Disk | Ja | Ja | Ja |
| Automatische Replikation | Ceph-intern | pvesr oder zfs send/receive |
SAN-intern |
Proxmox GUI versus ZFS-Kommandozeile
Die Proxmox-Oberfläche verwaltet VMs, Container, Cluster-Locks und Storage-Zuordnungen. Die ZFS-Kommandozeile administriert dagegen den darunterliegenden Pool. Beide Ebenen ergänzen sich, dürfen aber nicht miteinander verwechselt werden.
| Aufgabe | Proxmox VE | ZFS-Kommandozeile |
|---|---|---|
| Pools anzeigen | Node → Disks → ZFS | zpool list |
| Poolzustand prüfen | ZFS-Übersicht | zpool status -v |
| Speicherbelegung anzeigen | Storage Summary | zfs list -o space |
| I/O beobachten | PVE-Metriken | zpool iostat -v 2 |
| Dataset anlegen | Storage-Konfiguration | zfs create tank/vmdata |
| ZVOL anlegen | VM-Disk hinzufügen | zfs create -V 100G tank/vmdata/test |
| Kompression aktivieren | Meist CLI | zfs set compression=lz4 tank/vmdata |
| VM-Snapshot erstellen | qm snapshot 100 snap1 |
zfs snapshot tank/vmdata/vm-100-disk-0@snap1 |
| Snapshot zurückrollen | PVE-Snapshot-Menü | zfs rollback …@snap1 |
| Clone erzeugen | qm clone 100 200 |
zfs clone …@snap1 … |
| VM-Disk vergrößern | qm resize 100 scsi0 +20G |
zfs set volsize=120G … |
| Replikation | PVE Replication Job | zfs send … | ssh … zfs receive … |
| Datenintegrität prüfen | Tasks und Status | zpool scrub tank |
| Defekte Platte ersetzen | Disks/ZFS beziehungsweise CLI | zpool replace tank alt neu |
| TRIM starten | Zeitplan oder CLI | zpool trim tank |
Praxisregel für Proxmox-VMs auf ZFS
Proxmox-eigene VM-Datenträger sollten nicht unkontrolliert direkt mit zfs snapshot, zfs clone, zfs rollback, zfs rename oder zfs destroy verändert werden. Proxmox kennt diese Änderungen sonst nicht. Für VM-Operationen sind deshalb Weboberfläche, API, qm, pct und pvesm die erste Wahl. Die ZFS-CLI eignet sich besonders für Poolzustand, Scrubs, Plattentausch, Kompression, Kapazitätsanalyse und geplante externe Replikation.
Automatische ZFS-Snapshots für Proxmox einrichten
Für die relevanten ZFS-Datasets und ZVOLs verwenden wir eine gestaffelte Snapshot-Aufbewahrung. Sie bietet engmaschige Wiederherstellungspunkte für aktuelle Fehler und ein gröberes Raster für ältere Stände.
| Intervall | Aufbewahrung | Maximale Anzahl | Zweck |
|---|---|---|---|
| Alle 15 Minuten | 3 Stunden | 12 | Schnelle Hilfe bei aktuellen Fehlern |
| Stündlich | 96 Stunden | 96 | Vier Tage inklusive langer Wochenenden |
| Täglich | 14 Tage | 14 | Zwei Wochen Tageshistorie |
| Wöchentlich | 6 Wochen | 6 | Mittelfristige Wiederherstellung |
| Monatlich | 3 Monate | 3 | Spät erkannte Fehler |
Das ergibt maximal ungefähr 131 automatische Snapshots pro Dataset oder ZVOL. Durch zeitliche Überschneidungen und das Verhalten der verwendeten Snapshot-Engine kann die tatsächliche Zahl abweichen.
Wie viel Speicher benötigen ZFS-Snapshots?
Ein ZFS-Snapshot ist keine vollständige Kopie. Beim Erstellen wird lediglich ein neuer Referenzpunkt im Blockbaum angelegt. Zusätzlicher Platz wird benötigt, sobald Daten im Live-Dataset überschrieben oder gelöscht werden und der Snapshot die alten Blöcke weiterhin referenziert. Der Speicherbedarf hängt deshalb von der Änderungsrate ab, nicht allein von der Anzahl der Snapshots.
zfs list -o name,used,available,usedbysnapshots
zfs list -t snapshot -o name,creation,used
zpool listSnapshots auf demselben Pool sind kein vollständiges Backup. Fällt der gesamte Pool aus oder wird er zerstört, sind auch seine Snapshots verloren. Für längere Aufbewahrung und getrennte Kopien verwenden wir ZFS-Replikation und Proxmox Backup Server.
ZFS-Snapshots, Rollbacks, Clones und Snapdirs erklärt
ZFS-Snapshot erstellen
zfs snapshot rpool/data@vor-update
zfs snapshot -r rpool/data@vor-updateSnapshots entstehen nahezu sofort. Ein nativer Snapshot außerhalb von Proxmox ist jedoch zunächst nur crash-konsistent. Für Datenbanken oder VMs mit mehreren Disks können QEMU Guest Agent, Freeze/Thaw oder eine anwendungsspezifische Vorbereitung erforderlich sein.
Einzelne Dateien aus einem Snapshot wiederherstellen
cp /daten/.zfs/snapshot/daily-2026-08-31/datei /daten/dateiEine einzelne Datei zu kopieren ist meist sicherer als ein Rollback des gesamten Datasets, weil alle anderen aktuellen Änderungen erhalten bleiben.
Snapdir sichtbar machen
zfs set snapdir=visible pool/datensnapdir gilt für ZFS-Dateisysteme. Proxmox-VM-Disks sind üblicherweise ZVOLs und besitzen kein durchsuchbares Dateiverzeichnis. Für ZVOL-Snapshot-Geräte existiert stattdessen snapdev. Siehe OpenZFS-Dokumentation zu Snapshots, Clones und Snapdir.
ZFS-Rollback
zfs rollback pool/daten@vor-updateEin Rollback verwirft alle Änderungen nach dem gewählten Snapshot. Standardmäßig ist nur der neueste Snapshot zulässig. zfs rollback -r kann neuere Snapshots löschen; -R kann zusätzlich abhängige Clones betreffen. Vor einem Rollback sollte der aktuelle Zustand deshalb separat gesichert werden.
ZFS-Clone
zfs clone pool/daten@vor-update pool/testEin Clone ist eine sofort beschreibbare Kopie eines Snapshots. Anfangs teilen sich Snapshot und Clone die unveränderten Blöcke. Neue Schreibvorgänge benötigen zusätzlichen Platz. Typische Anwendungen sind Tests, Updates, Datenrettung und isolierte Kopien. Der Clone bleibt von seinem Ursprungssnapshot abhängig, bis die Beziehung gegebenenfalls mit zfs promote umgekehrt wird.
ZFS-Platte schnell ersetzen und RAIDZ erweitern
Defekte ZFS-Platte mit Replace austauschen
zpool replace tank alte-platte neue-platte
zpool status tankZFS rekonstruiert die benötigten Blöcke aus den verbliebenen Geräten und schreibt sie auf die neue Platte. Ist die alte Platte noch lesbar, sollte die neue möglichst zuerst angeschlossen und der Replace kontrolliert gestartet werden. So bleibt die vorhandene Redundanz länger erhalten. Bei Mirrors kann zpool replace -s eine sequenzielle Rekonstruktion starten; für RAIDZ ist diese Option nicht verfügbar. Details stehen in der OpenZFS-Referenz zu zpool replace.
RAIDZ-Expansion: RAIDZ um eine Platte erweitern
zpool attach tank raidz2-0 neue-platteMit aktuellen OpenZFS-Versionen kann ein bestehendes RAIDZ-vdev schrittweise um einzelne Platten verbreitert werden. Die Feature-Flag raidz_expansion muss vorhanden und aktiviert sein. Die neue Platte muss mindestens so groß wie die kleinste vorhandene Platte sein.
- RAIDZ1, RAIDZ2 oder RAIDZ3 behalten ihr jeweiliges Paritätsniveau.
- Die Anzahl tolerierbarer Plattenausfälle steigt durch die Expansion nicht.
- ZFS liest die belegten Daten und verteilt sie über die verbreiterte Gruppe.
zpool statuszeigt den Fortschritt.- Bei einem Plattenfehler pausiert die Expansion, bis das vdev wieder gesund ist.
- Alte Blöcke behalten ihr ursprüngliches Daten-Paritäts-Verhältnis; neue Blöcke nutzen die breitere Geometrie vollständig.
Weitere technische Hintergründe bietet die OpenZFS-Dokumentation zur Änderung des Pool-Layouts.
ZFS Spares, L2ARC, SLOG und Special Devices richtig einsetzen
| Gerätetyp | Aufgabe | Was passiert bei Verlust? |
|---|---|---|
| Hot Spare | Ersatzplatte bereithalten | Die normale Pool-Redundanz entscheidet |
| Cache/L2ARC | Häufig gelesene Daten zusätzlich cachen | Unkritisch, da nur Kopien gespeichert werden |
| Log/SLOG | Synchrone Schreibvorgänge beschleunigen | Risiko für die jüngsten noch nicht übernommenen Sync-Schreibvorgänge |
| Special vdev | Metadaten und optional kleine Blöcke dauerhaft speichern | Der Verlust kann den gesamten Pool zerstören |
Hot Spare
zpool add tank spare /dev/disk/by-id/...Ein Hot Spare verkürzt die Zeit im degradierten Zustand, erhöht aber nicht die Fehlertoleranz. Ein RAIDZ2 bleibt trotz Spare ein RAIDZ2. Die ausgefallene Platte muss dauerhaft ersetzt werden.
L2ARC als ZFS-Lesecache
zpool add tank cache /dev/nvme0n1Der primäre ZFS-Cache ist der ARC im RAM. L2ARC auf SSD oder NVMe ist nur die zweite Stufe. Er lohnt sich vor allem bei wiederkehrenden zufälligen Lesezugriffen und einem Arbeitsdatensatz, der nicht vollständig in den RAM passt. L2ARC beschleunigt keine Schreibvorgänge; mehr RAM ist häufig die bessere erste Maßnahme.
SLOG für synchrone Schreibvorgänge
zpool add tank log mirror /dev/nvme0n1 /dev/nvme1n1Ein SLOG ist kein allgemeiner Schreibcache. Es beschleunigt nur synchrone Schreibvorgänge, etwa bei NFS, Datenbanken oder VM-Storage mit häufigem fsync(). Geeignete Geräte benötigen geringe Latenz und Power-Loss-Protection. Wichtige SLOGs sollten gespiegelt werden. sync=disabled ist kein pauschaler Tuningtrick, weil dabei zugesagte Schreibsicherheit verloren geht.
Special vdev für Metadaten und kleine Blöcke
zpool add tank special mirror /dev/nvme0n1 /dev/nvme1n1
zfs set special_small_blocks=32K tank/datenEin Special vdev speichert Metadaten, indirekte Blöcke, gegebenenfalls Dedup-Tabellen und optional kleine Datenblöcke dauerhaft. Es ist kein Cache. Deshalb muss es mindestens so redundant wie der normale Pool aufgebaut werden. Geht das vollständige Special vdev verloren, kann der gesamte Pool verloren sein. Siehe OpenZFS-Dokumentation zu Special vdevs.
ZFS Pull-Replikation mit bashclub zsync
zsync läuft auf dem Zielserver und holt markierte ZFS-Dateisysteme und ZVOLs über SSH von der Quelle. Das Ziel initiiert also die Replikation:
ZFS-Quelle ── SSH und zfs send ──▶ ZFS-Ziel
▲
│
Ziel startet PullDieses Pull-Modell reduziert die Rechte der Quelle auf dem Sicherungsziel. Ein kompromittierter Proxmox-Server soll weder ältere Replikate löschen noch die Retention auf dem Ziel verändern können.
Datasets mit dem ZFS-Attribut bashclub:zsync markieren
zfs set bashclub:zsync=all rpool/dataall: Dataset und untergeordnete Datasets beziehungsweise ZVOLs einbeziehensubvols: nur untergeordnete Datasets und ZVOLs einbeziehenexclude: den markierten Zweig ausschließen
Der Attributname kann geändert werden. Dadurch lassen sich verschiedene Replikationsziele mit unterschiedlichen Tags steuern.
Ablauf der zsync-Replikation
zsyncstartet auf dem Zielserver.- Das Ziel verbindet sich per SSH mit der ZFS-Quelle.
- Die ZFS-Attribute bestimmen die zu replizierenden Datasets und ZVOLs.
- Optional wird vor der Replikation ein Snapshot erzeugt.
- Quelle und Ziel suchen den neuesten gemeinsamen Snapshot.
- Der erste Lauf sendet einen vollständigen Stream; Folgeläufe übertragen nur geänderte Blöcke.
- Das Ziel erzeugt den vollständigen Dataset-Pfad automatisch.
com.sun:auto-snapshot=falseverhindert ungewollte lokale Auto-Snapshots auf dem Replikationsziel.- Der Mountpoint wird übernommen und
canmount=noautoverhindert ein unbeabsichtigtes Mounten. snapshot_filterbestimmt, welche vorhandenen Snapshots mitgenommen werden.- Raw Replication kann verschlüsselte Blöcke ohne Entschlüsselung auf dem Ziel übertragen.
source=root@pve01
target=backup/repl/pve01
tag=bashclub:zsync
snapshot_filter=hourly|daily|weekly|monthly
min_keep=3
zfs_auto_snapshot_keep=14
zfs_auto_snapshot_label=zsyncZFS-Replikation per Snapshot-GUID mit checkzfs.py überwachen
Eine erfolgreiche Script-Ausgabe beweist noch nicht, dass ein aktuelles und brauchbares Replikat existiert. checkzfs.py vergleicht deshalb die Snapshots auf Quelle und Ziel anhand ihrer ZFS-GUID. Gleiche Snapshot-Namen reichen als Nachweis nicht aus.
Die Prüfung kann unter anderem folgende Fehler erkennen:
- kein Replikat gefunden,
- letzter gemeinsamer Snapshot zu alt,
- Snapshot auf dem Ziel nicht vorhanden,
- Rollback auf einen älteren Snapshot,
- zu viele Snapshots,
- unerwünschte Auto-Snapshots auf dem Replikationsziel,
- SSH- oder Abfragefehler.
Wunschalter der Replikation festlegen
threshold: 1500,2000Im Beispiel wird nach 1.500 Minuten gewarnt und nach 2.000 Minuten ein kritischer Zustand gemeldet. Zusätzlich lassen sich maximale Snapshotzahlen, Dataset-Filter, Snapshot-Filter, SSH-Key und Servicename definieren.
source: pve01
remote: backup01
filter: rpool/data
replicafilter: backup/repl/pve01
snapshotfilter: zsync|daily|weekly|monthly
threshold: 1500,2000
maxsnapshots: 140,160
prefix: REPLICADie Ausgabe eignet sich unter anderem für Tabellen, JSON, CSV, E-Mail und lokale Checkmk-Checks. Der Quellcode von checkzfs.py zeigt die verfügbaren Parameter und Prüfungen.
Wichtig: Ein GUID-Vergleich bestätigt die gemeinsame Snapshot-Identität. Er ersetzt weder den regelmäßigen ZFS-Scrub noch einen getesteten Restore.
Trojanerresistentes Proxmox-Backup mit dem Miyagi-Workflow
Der Miyagi-Workflow verbindet zwei unterschiedliche Sicherungsmethoden auf einem getrennten System:
- Proxmox Backup Server: deduplizierte und längerfristige VM- und LXC-Backups
- Native ZFS-Replikation: unmittelbar vorhandene Datasets und ZVOLs für einen schnellen Wiederanlauf
Das Ziel sind mindestens drei Datenkopien, zwei Standorte, zwei Sicherungsmethoden, automatische Kontrolle und eine möglichst kurze Netzwerk-Erreichbarkeit des Sicherungsservers.
Typischer Ablauf des Miyagi-Servers
Miyagi-Server startet
│
├─ Updates und Zustandsprüfung
├─ ZFS-Replikation per Pull
├─ PBS-Backup koordinieren
├─ Verify, Wartung und Monitoring
├─ GUID und Alter der Replikate prüfen
└─ Sicherungsserver herunterfahrenDas ZFS-Replikat kann einen schnellen Wiederanlauf ermöglichen, weil Datasets und ZVOLs bereits auf dem Ziel liegen. Das PBS-Backup bietet die längere, deduplizierte Historie, benötigt für die produktive Nutzung aber einen Restore.
Wann ist der Workflow gegen Ransomware und Trojaner widerstandsfähig?
„Trojanersicher“ ist keine einzelne Produkteigenschaft. Die Schutzwirkung entsteht durch technische Trennung und minimale Berechtigungen:
- Das Ziel startet die Pull-Replikation.
- Die Quelle besitzt keine administrativen Schreib- oder Löschrechte auf dem Ziel.
- SSH-Zugriffe werden auf notwendige Befehle und Datasets begrenzt.
- Der PBS-API-Key erhält nur die erforderlichen Backup- und Restore-Rechte.
- SSH-Passwortlogin wird deaktiviert und interaktive Konten werden mit 2FA geschützt.
- Snapshot-Löschung und Retention werden ausschließlich vom Ziel kontrolliert.
- Der Miyagi-Server hat häufig nur definierte Routen und kein Default Gateway.
- Außerhalb des Sicherungsfensters ist der Server ausgeschaltet oder wirksam isoliert.
- Scrubs, Verify-Jobs und Wiederherstellungstests werden regelmäßig durchgeführt.
- Mindestens eine Kopie befindet sich an einem anderen Standort.
Der dokumentierte Workflow kombiniert Backups, startfähige ZFS-Replikate, Monitoring, Wartung und automatisches Herunterfahren. Die vollständige Einrichtung beschreibt die Anleitung Backup und Replikation für Proxmox VE mit dem Miyagi-Workflow.
Welche Proxmox-Storage-Lösung ist die richtige?
- Ein bis zwei Nodes: Lokales ZFS ist meist die einfachste und robusteste Lösung.
- Drei oder mehr geeignete Nodes mit echtem Storage-HA: Ceph RBD ist der typische Ansatz.
- Vorhandenes professionelles SAN: iSCSI mit klassischem LVM nutzt die bestehende zentrale Infrastruktur.
- Thin Provisioning und schnelle Linked Clones: Ceph oder ZFS.
- Vorhersehbare feste Platzbelegung: iSCSI mit LVM thick.
- Schneller lokaler Restore plus getrennte Kopie: ZFS-Snapshots mit Pull-Replikation und PBS kombinieren.
Häufige Fragen zu Proxmox, ZFS, Ceph und Replikation
Ist ein ZFS-Snapshot bereits ein Backup?
Nein. Ein Snapshot liegt normalerweise auf demselben ZFS-Pool wie die produktiven Daten. Er schützt gut vor versehentlichem Löschen oder unerwünschten Änderungen, aber nicht vor dem vollständigen Verlust oder der Zerstörung des Pools.
Was ist für Proxmox besser: Ceph oder ZFS?
Für einzelne Server und kleine Cluster ist lokales ZFS meist einfacher. Ceph eignet sich für mehrere Nodes, verteilten Shared Storage und hohe Verfügbarkeit ohne einzelnen Storage-Kopf. Ceph benötigt dafür mehr Hardware, Netzwerkleistung und Betriebsaufwand.
Kann Proxmox mit lokalem ZFS live migrieren?
Ja, eine laufende VM kann migriert werden. Da lokales ZFS kein Shared Storage ist, muss der VM-Datenträger dabei jedoch auf den Ziel-Node kopiert werden. Bei Ceph oder gemeinsamem iSCSI-Storage entfällt diese Storage-Kopie in der Regel.
Was ist der Unterschied zwischen ZFS-Replikation und Proxmox Backup Server?
ZFS-Replikation überträgt native Datasets, ZVOLs und Snapshots und ermöglicht dadurch einen schnellen Wiederanlauf. Proxmox Backup Server erstellt deduplizierte Backups mit längerer Historie und integriertem Restore für VMs und Container. Beide Verfahren ergänzen sich.
Warum ist Pull-Replikation sicherer als Push-Replikation?
Bei Pull-Replikation startet das Ziel die Verbindung und holt Daten von der Quelle. Die Quelle benötigt dadurch keine administrativen Rechte auf dem Sicherungsziel. Wird sie kompromittiert, kann sie ältere Ziel-Snapshots nicht ohne Weiteres löschen.
Wozu vergleicht checkzfs.py Snapshot-GUIDs?
Ein Snapshot-Name kann auf zwei Systemen identisch sein, ohne denselben Snapshot zu bezeichnen. Die GUID ermöglicht eine eindeutige Zuordnung und zeigt, ob Quelle und Ziel tatsächlich einen gemeinsamen replizierten Snapshot besitzen.
Beschleunigt ein ZFS-SLOG alle Schreibvorgänge?
Nein. Ein SLOG hilft nur bei synchronen Schreibvorgängen. Asynchrone Writes werden dadurch nicht grundsätzlich schneller. Ein geeignetes SLOG benötigt geringe Latenz und Power-Loss-Protection.
Kann der Verlust eines Special vdev den ZFS-Pool zerstören?
Ja. Ein Special vdev speichert bestimmte Blöcke dauerhaft und nicht nur als Cache. Es muss deshalb mindestens so redundant wie die normalen Daten-vdevs aufgebaut werden.
Fazit: Proxmox-Storage mit überprüfbarer Backup-Strategie
Ceph, lokales ZFS und iSCSI erfüllen unterschiedliche Aufgaben. Entscheidend ist nicht nur die Storage-Technik, sondern der vollständige Wiederherstellungsweg. Automatische ZFS-Snapshots liefern schnelle lokale Zeitpunkte, zsync erzeugt getrennte native Replikate, checkzfs.py kontrolliert deren Aktualität und der Miyagi-Workflow kombiniert ZFS-Replikation mit Proxmox Backup Server, Monitoring und zeitweiser Offline-Sicherung.
So entsteht aus einzelnen Storage-Funktionen eine mehrstufige Strategie gegen Hardwareausfälle, Fehlbedienung, spät erkannte Datenfehler und kompromittierte Produktivsysteme.
Proxmox 9 und iSCSI SAN mit Multipath
TrueNAS als Proxmox-Speicher: iSCSI mit Multipath und LVM einrichten
Video zum Artikel: Die Einrichtung wird im
begleitenden Livestream zu Proxmox, TrueNAS und iSCSI-Multipath gezeigt.
Diese Dokumentation zeigt die Einrichtung eines gemeinsamen iSCSI-Speichers für einen Proxmox-Cluster mit TrueNAS. Zwei getrennte SAN-Netze stellen die Speicherverbindungen bereit. Multipath bündelt die Zugriffswege auf dieselbe LUN, während Proxmox die VM-Datenträger über LVM verwaltet.
Dokumentiert wurde ein Workshop mit drei Proxmox-Knoten. Die Anleitung enthält die sichtbaren Einrichtungsschritte, passende Screenshots und eine Einordnung der aufgetretenen Probleme. Am Ende folgen konkrete Optimierungstipps.
Stand: · Umgebung: Proxmox VE 9.2.11 und TrueNAS Community Edition
Ergebnis: Die iSCSI-Anbindung und zwei verfügbare Multipath-Pfade je Host sind dokumentiert. Das Verschieben einer VM-Festplatte auf TrueNAS war erfolgreich. Bei der Einrichtung wurde zunächst der Haken bei „Shared“ vergessen. Die fehlgeschlagene Migration lag an einem noch eingerichteten ZFS-Replikationsjob. Nach Aktivierung von Shared, Entfernung der bisherigen ZFS-Replikationsjobs und Übernahme aller VM-Disks einschließlich EFI und gegebenenfalls TPM liefen alle Migrationen tadellos. Dieses abschließende Ergebnis ergänzt die Screenshots durch die nachträgliche Bestätigung aus dem Workshop. Ein Ausfalltest ist weiterhin nicht dokumentiert.
1. Netzwerk und IP-Adressen für Proxmox und TrueNAS
Das Managementnetz und die beiden Speichernetze sind getrennt. SAN1 verwendet das Netz 172.16.1.0/24, SAN2 das Netz 172.16.2.0/24. Die Managementadressen liegen im Netz 192.168.168.0/24.
| System | Management | SAN1 | SAN2 |
|---|---|---|---|
| pve1 | 192.168.168.21 | 172.16.1.21 | 172.16.2.21 |
| pve2 | 192.168.168.22 | 172.16.1.22 | 172.16.2.22 |
| pve3 | 192.168.168.23 | 172.16.1.23 | 172.16.2.23 |
| TrueNAS | 192.168.168.67 | 172.16.1.67 | 172.16.2.67 |
Auf TrueNAS übernimmt enp2s0f0 das Management, ens1f0np0 SAN1 und enp2s0f1 SAN2. Die SAN-Adressen von pve2 und pve3 werden durch die später sichtbaren iSCSI-Verbindungen bestätigt; ihre vollständigen finalen Schnittstellendateien sind nicht abgebildet.
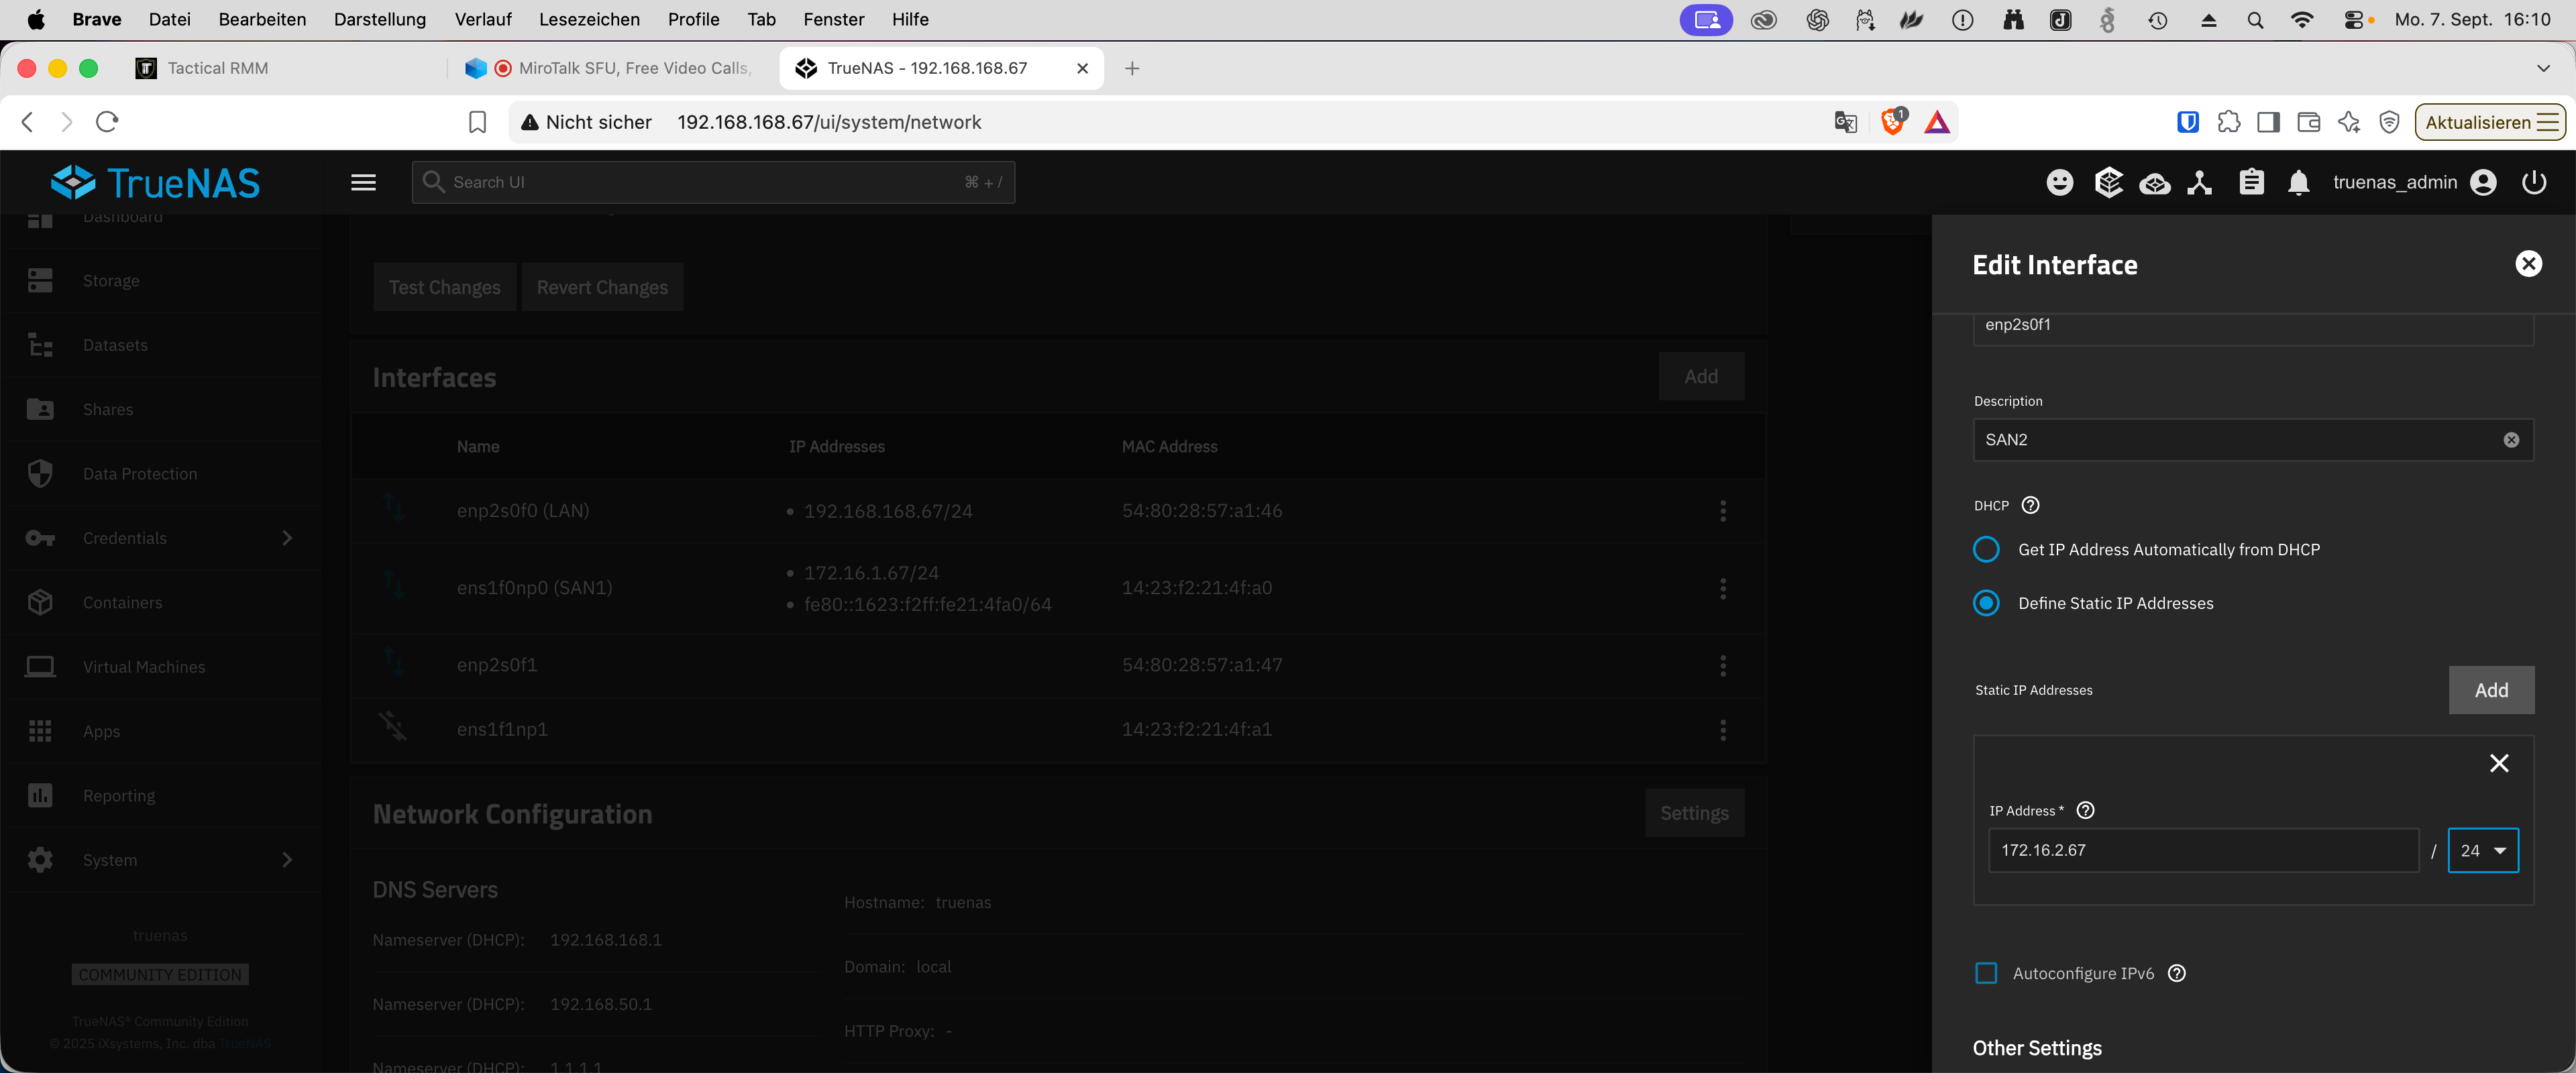
SAN-Schnittstellen auf Proxmox konfigurieren
Die spätere Konfiguration von pve1 verwendet nic1 für SAN1 und nic2 für SAN2. Das Standardgateway 192.168.168.1 bleibt am Managementnetz über vmbr0. Für die SAN-Schnittstellen ist kein Gateway eingetragen.
auto nic1
iface nic1 inet static
address 172.16.1.21/24
auto nic2
iface nic2 inet static
address 172.16.2.21/24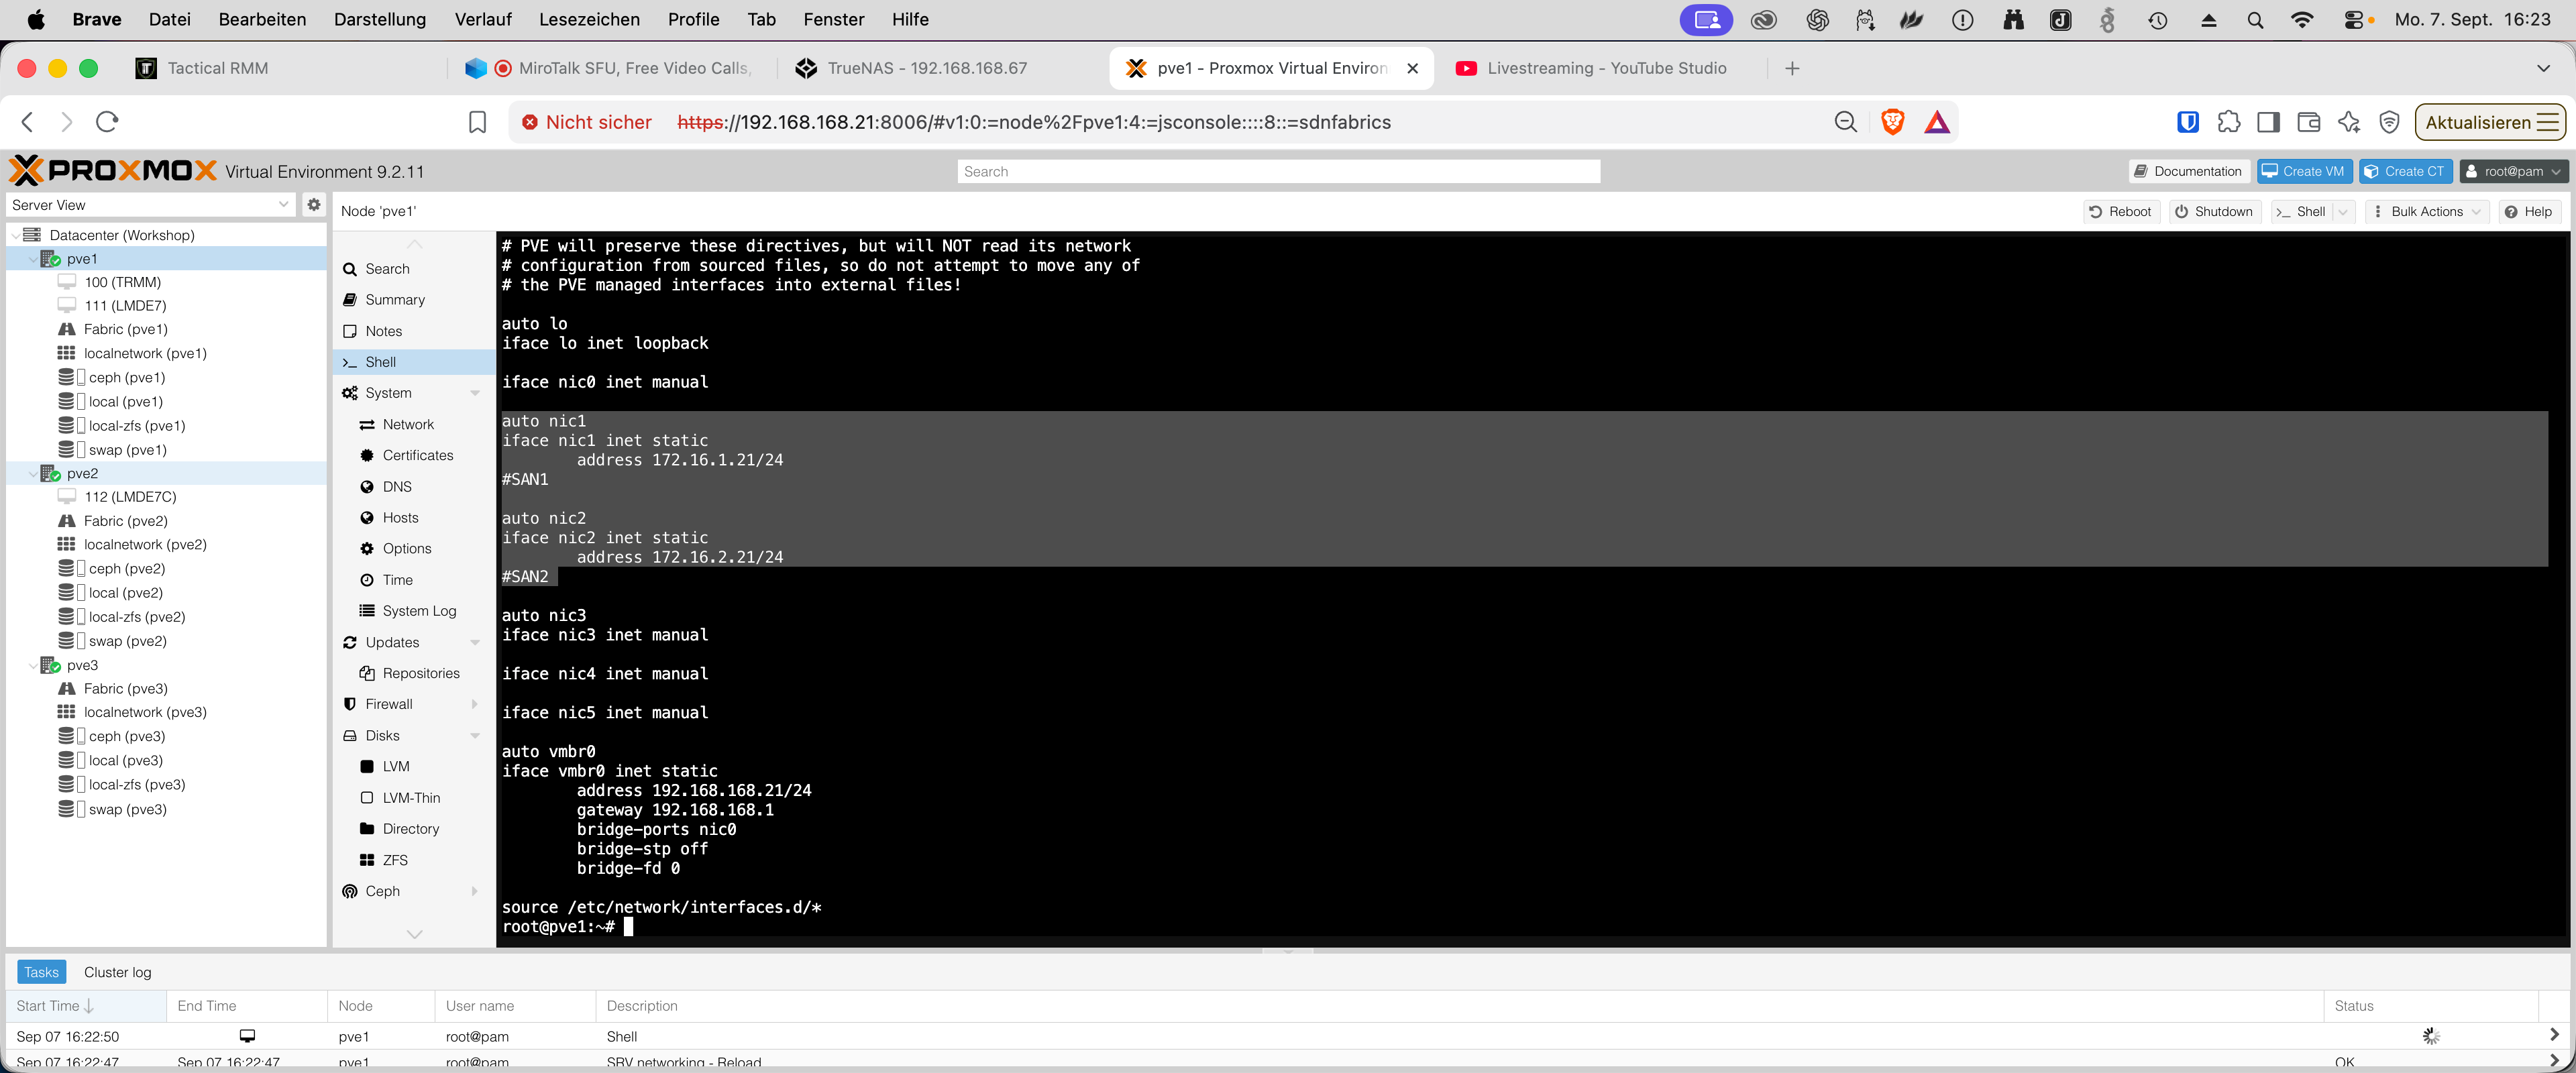
Ein früher Ping scheitert mit „Destination Host Unreachable“. Nach den Anpassungen sind erfolgreiche Antworten von beiden TrueNAS-SAN-Adressen auf pve1 und pve2 sichtbar. Auch pve3 erreicht dokumentierte SAN-Ziele. Diese kurzen Tests bestätigen die Erreichbarkeit, aber noch keine Leistung oder Stabilität unter Last.
2. TrueNAS-Pool und iSCSI-LUN erstellen
ZFS-Mirror aus zwei SSDs anlegen
Unter Storage → Create Pool wird der Pool Mirror erstellt. Er besteht aus einem Mirror-VDEV mit zwei als SSD erkannten Laufwerken von jeweils 931,51 GiB. Eine Verschlüsselung ist in der gezeigten Konfiguration nicht aktiviert.
Die Poolerstellung löscht die ausgewählten Datenträger. Vor einer Wiederholung müssen deshalb Laufwerksauswahl und vorhandene Daten geprüft werden.
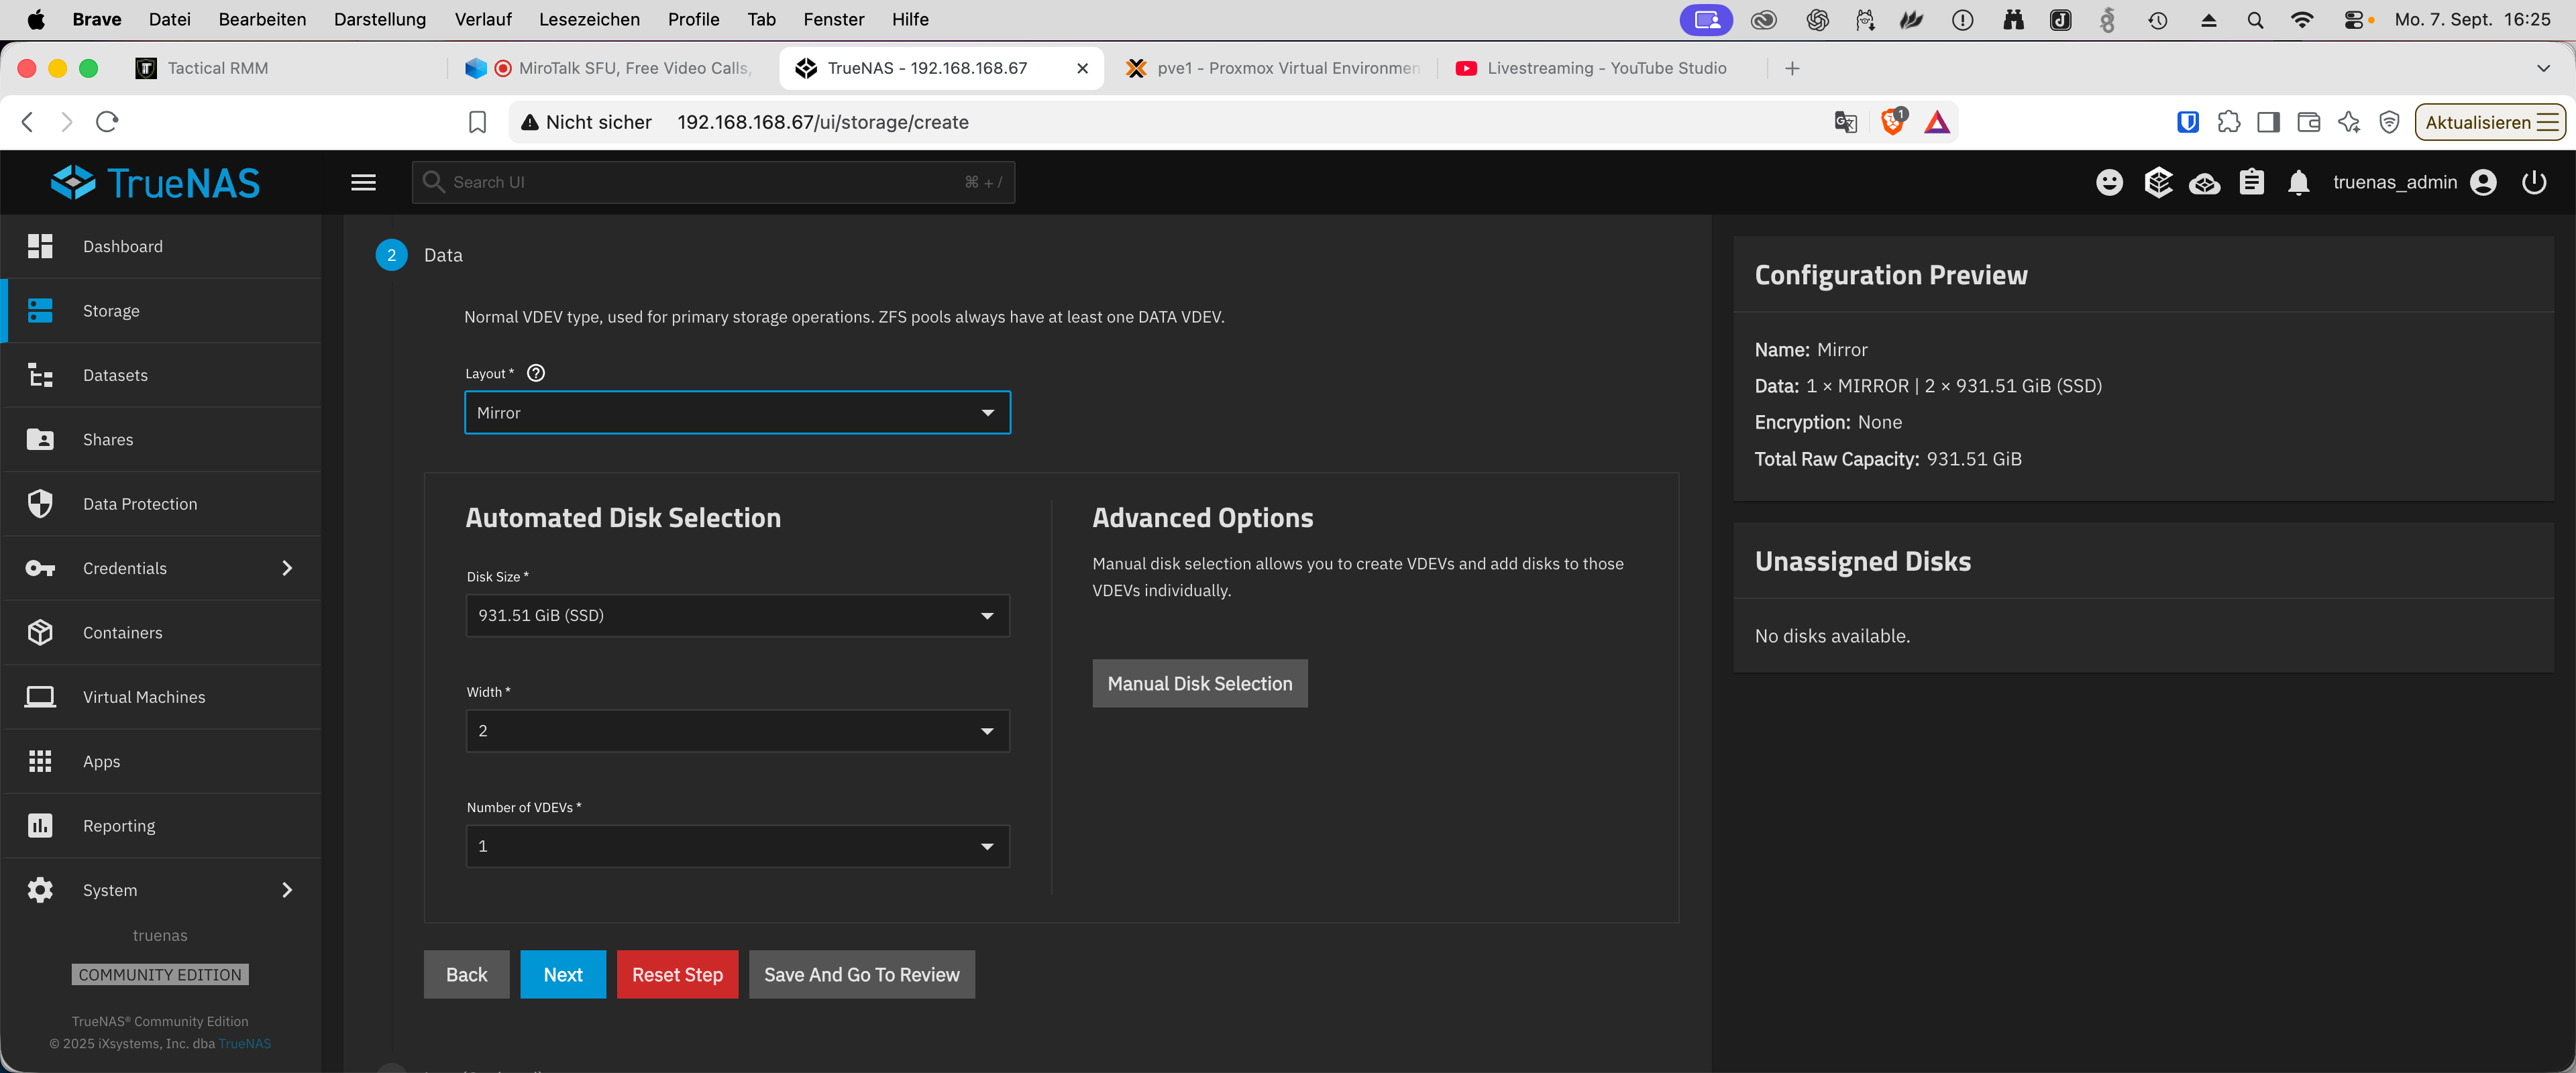
Nach der Erstellung zeigt TrueNAS etwa 899,25 GiB nutzbare Kapazität und den Zustand „Online, no errors“. Ein Scrub ist sonntags um 00:00 Uhr geplant. Auto TRIM ist ausgeschaltet; Temperaturdaten sind nicht verfügbar.
Dataset und Zvol mit 512 GiB erstellen
Unter Shares → Block (iSCSI) Shares Targets → Wizard wird ein neues Target vorbereitet. Im Pool entsteht das Dataset Mirror/iscsi. Der Assistent erstellt darin ein neues Blockgerät mit 512 GiB.
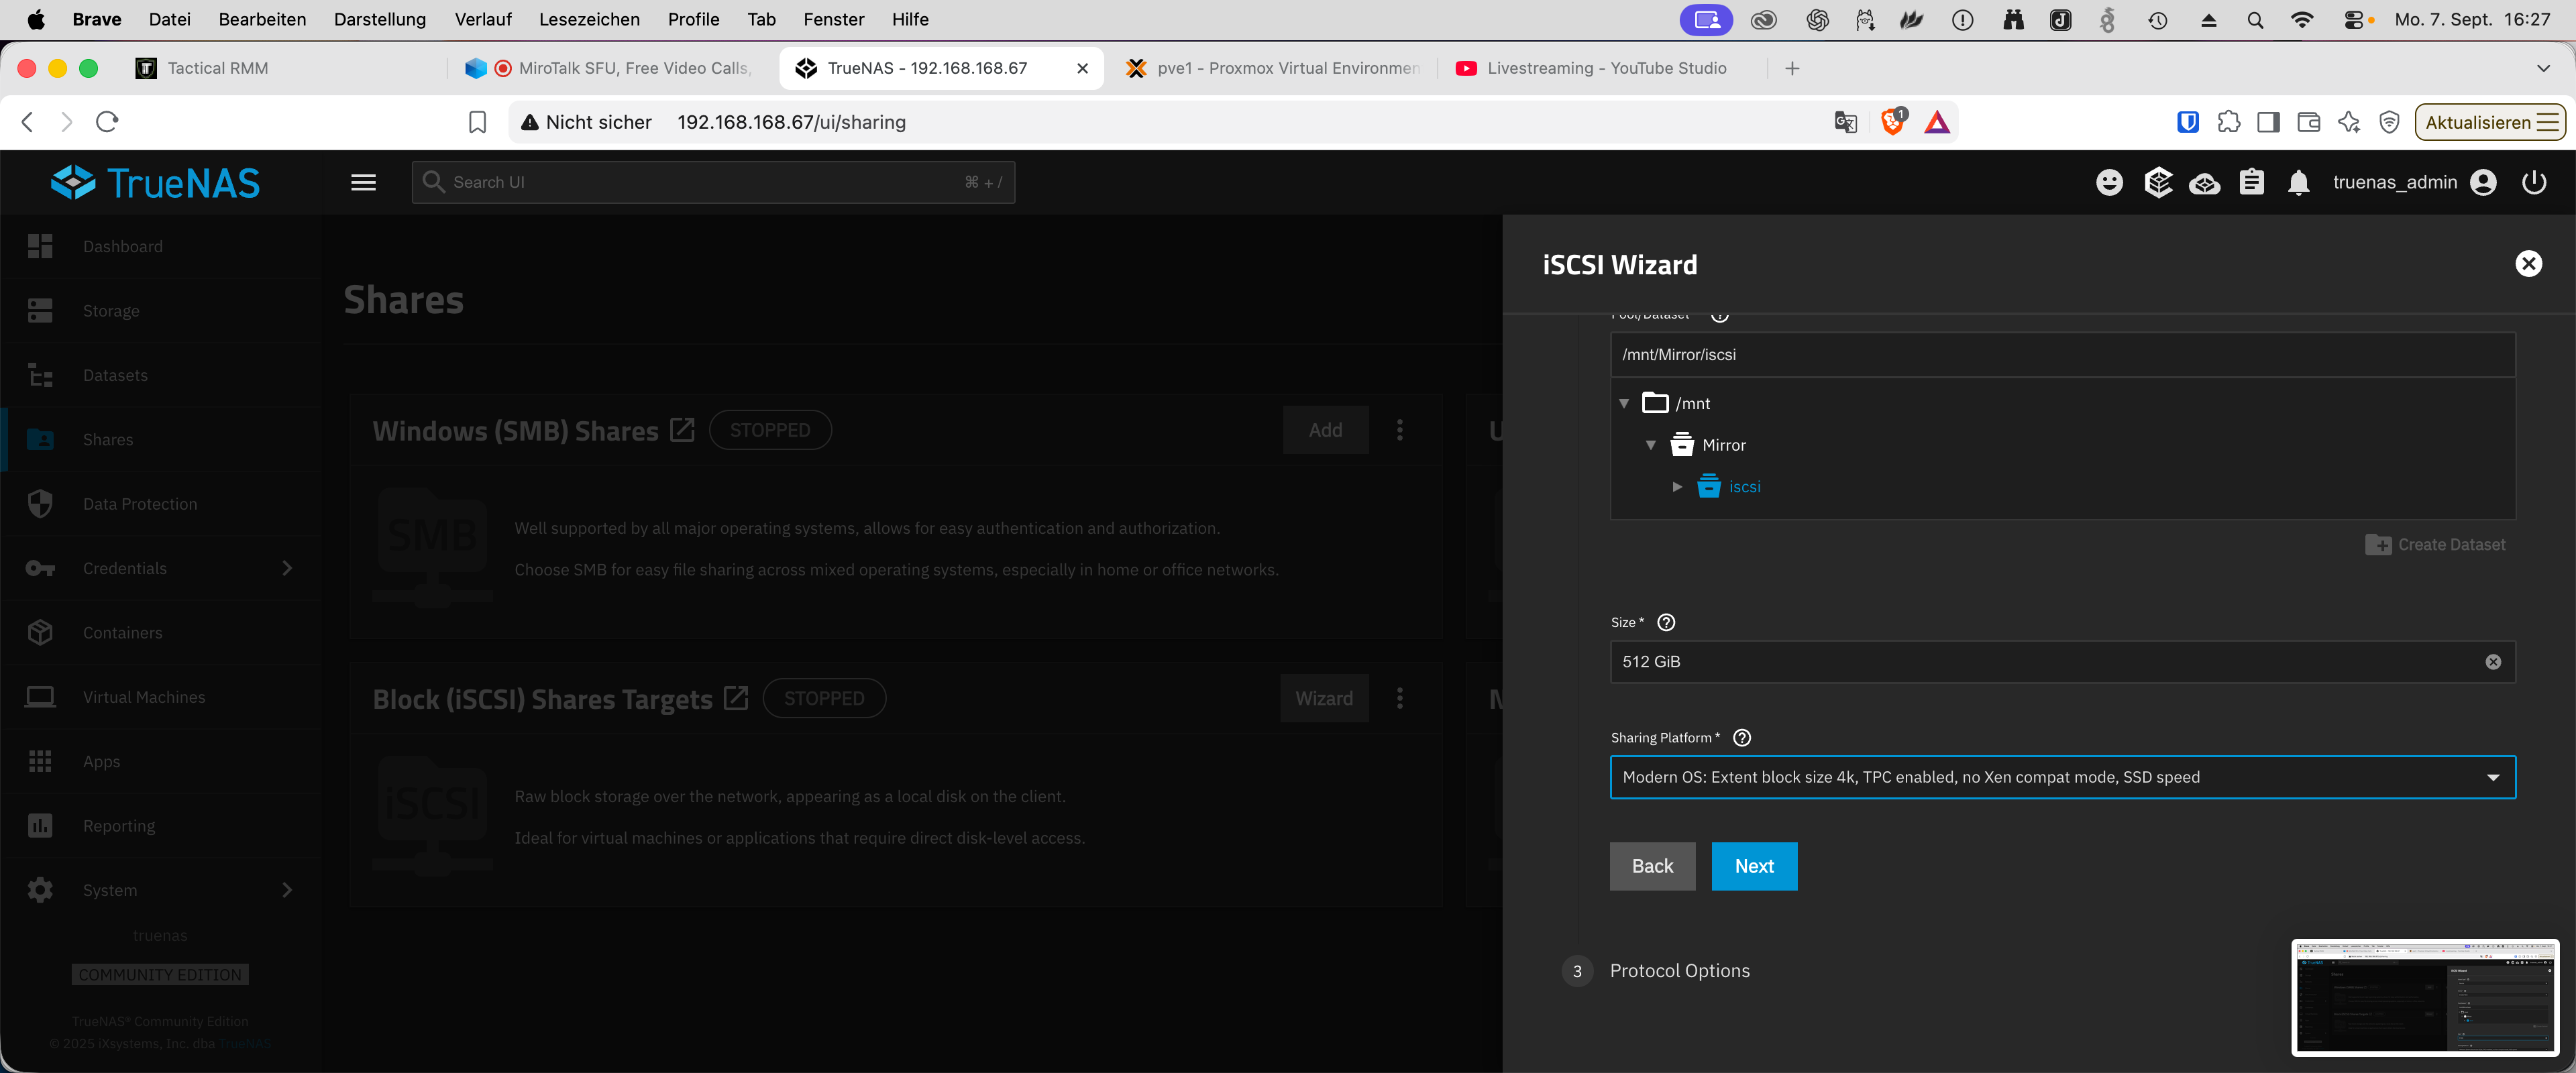
Das Profil zeigt eine Extent-Blockgröße von 4 KiB. Diese Angabe ist nicht mit der ZFS-Eigenschaft volblocksize gleichzusetzen. Der später sichtbare Gerätepfad lautet zvol/Mirror/iscsi/iscsi.
3. iSCSI-Portale und Initiatoren konfigurieren
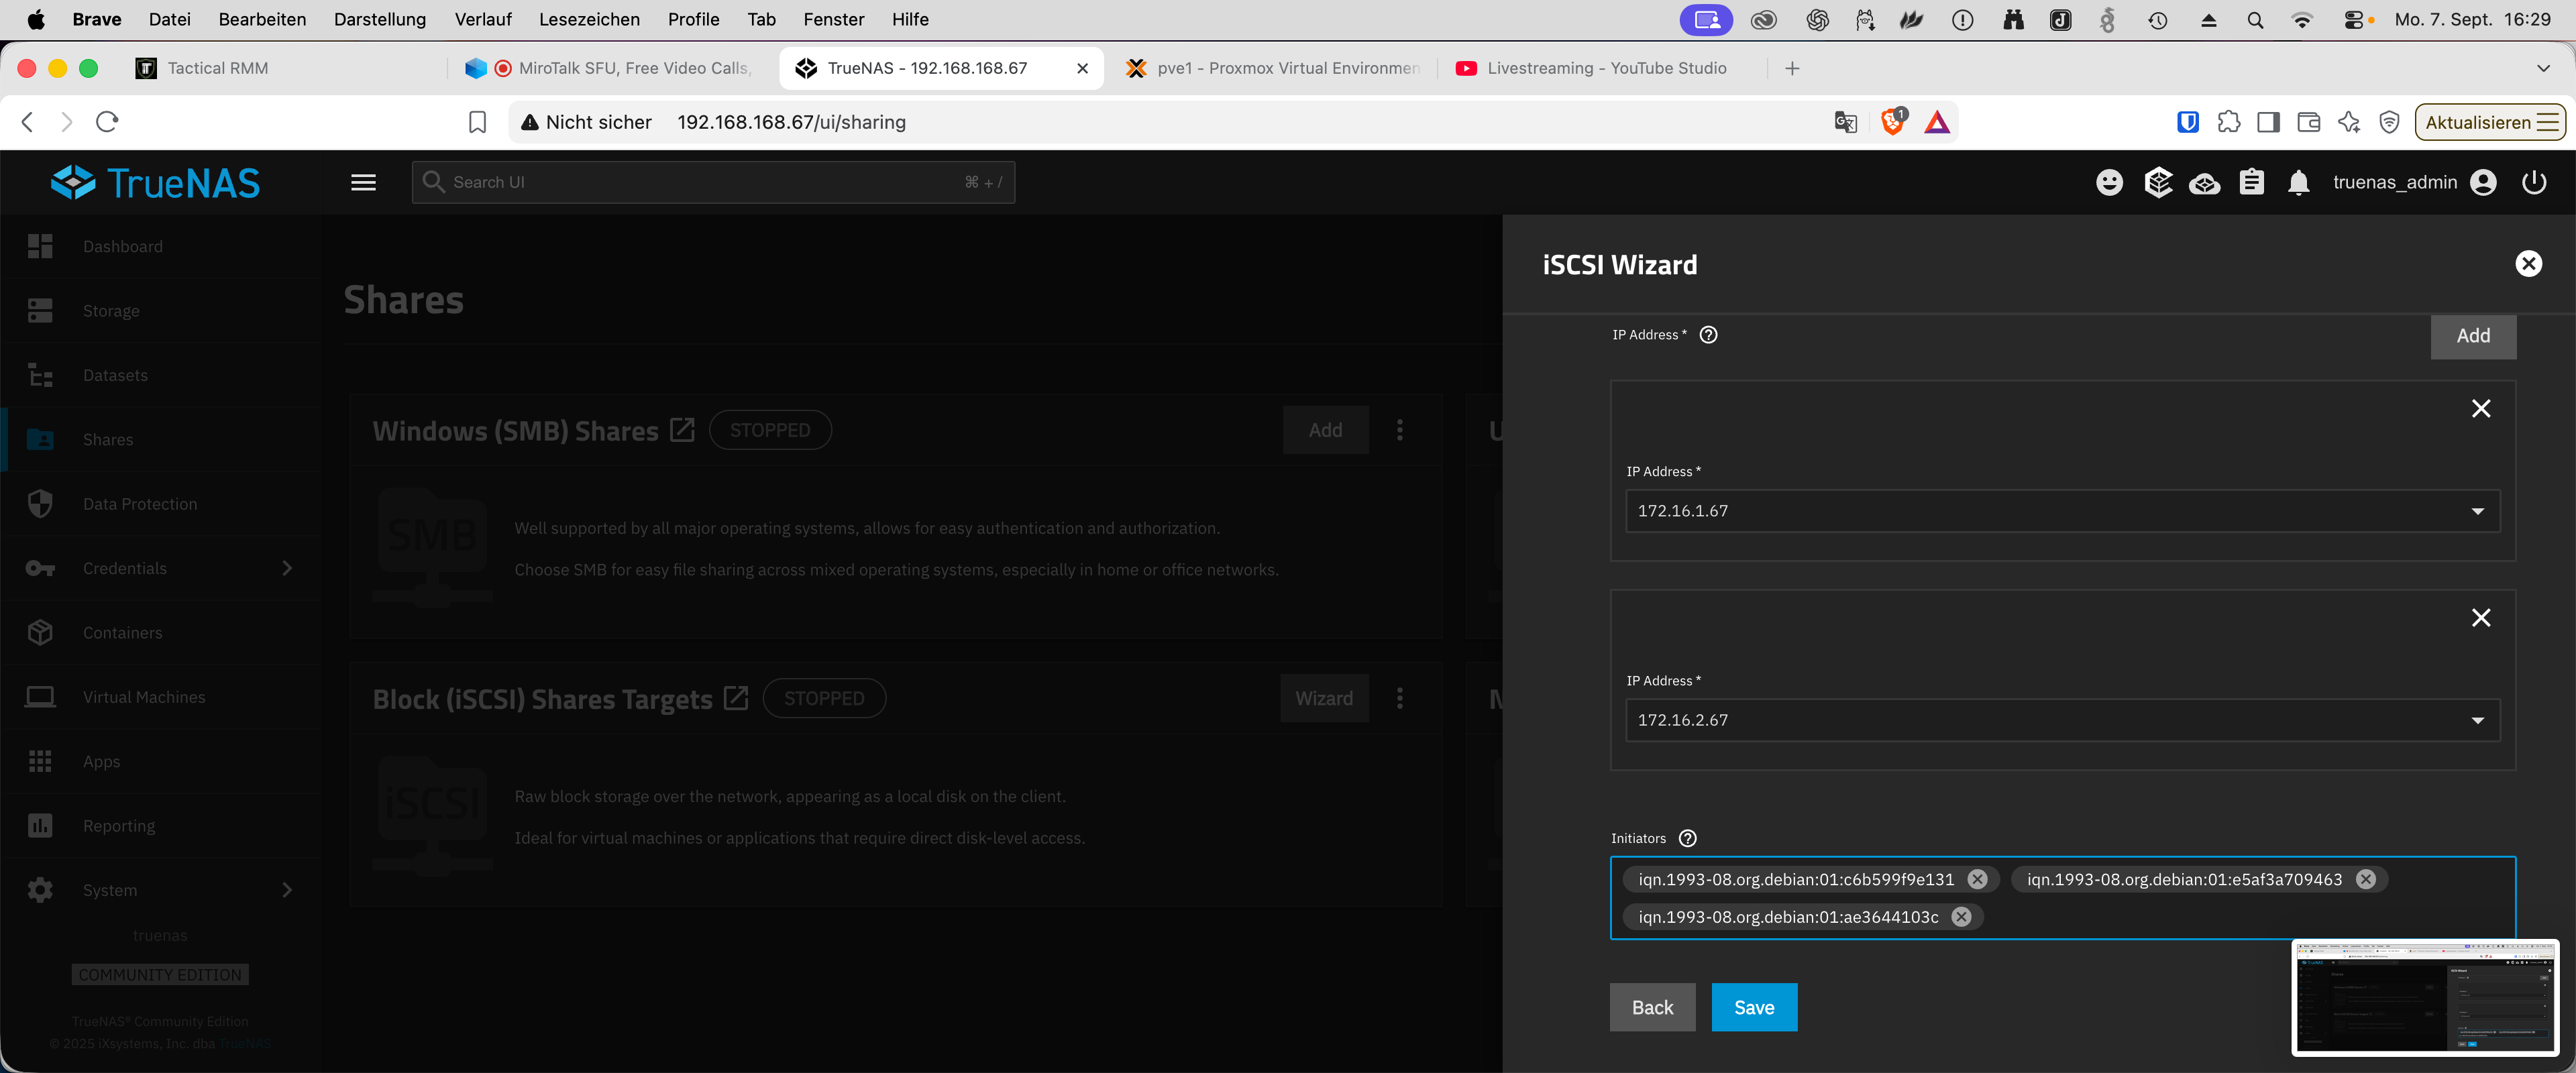
Das TrueNAS-Target wird über 172.16.1.67 und 172.16.2.67 erreichbar gemacht. Beide Portal-Adressen führen zur selben LUN. Mehrere Portal-Adressen bilden die Grundlage für die späteren Multipath-Verbindungen.
Die eindeutigen Initiator-Namen der Proxmox-Knoten lassen sich auf jedem Host auslesen:
cat /etc/iscsi/initiatorname.iscsiIm Workshop werden alle drei Initiatoren im TrueNAS-Assistenten hinterlegt. Danach wird der iSCSI-Dienst gestartet; die Option für den automatischen Start ist ausgewählt.
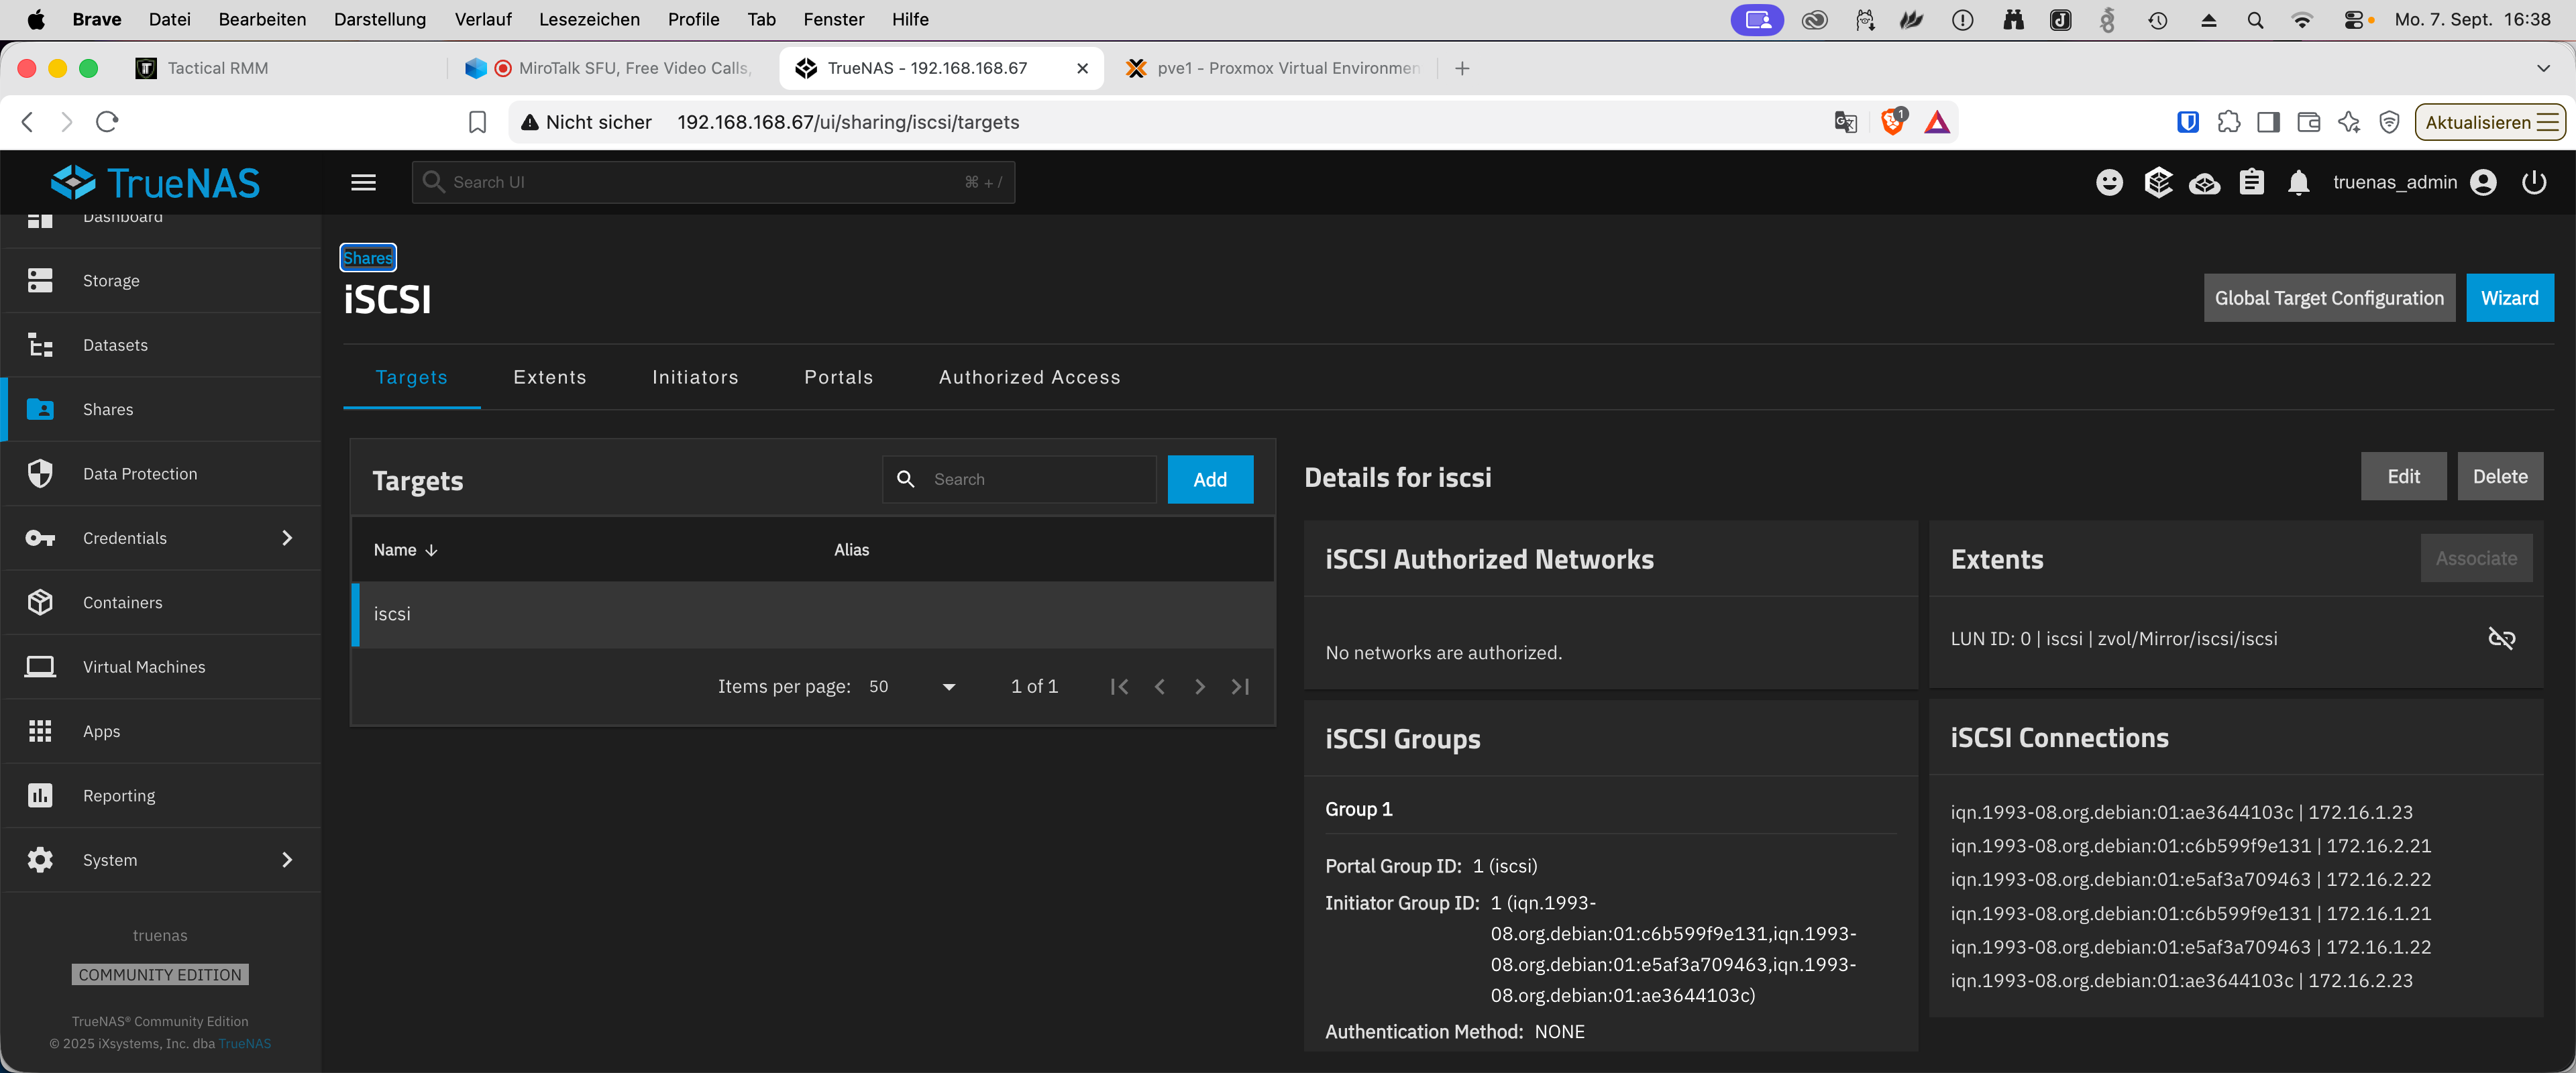
Die spätere Übersicht zeigt das Target iscsi mit LUN-ID 0, Authentifizierung NONE und sechs Verbindungen: jeweils eine Verbindung pro Host und SAN-Netz. Es sind keine zusätzlichen „Authorized Networks“ eingetragen; die Initiatorliste ist davon getrennt zu betrachten.
4. TrueNAS-iSCSI-Speicher in Proxmox einbinden
Unter Datacenter → Storage → Add → iSCSI wird die Verbindung hinzugefügt:
- ID:
iscsi-portal - Portal:
172.16.1.67 - Target:
iqn.2005-10.org.freenas.ctl:iscsi - Nodes: alle Knoten
- Enable: aktiviert
- Use LUNs directly: deaktiviert
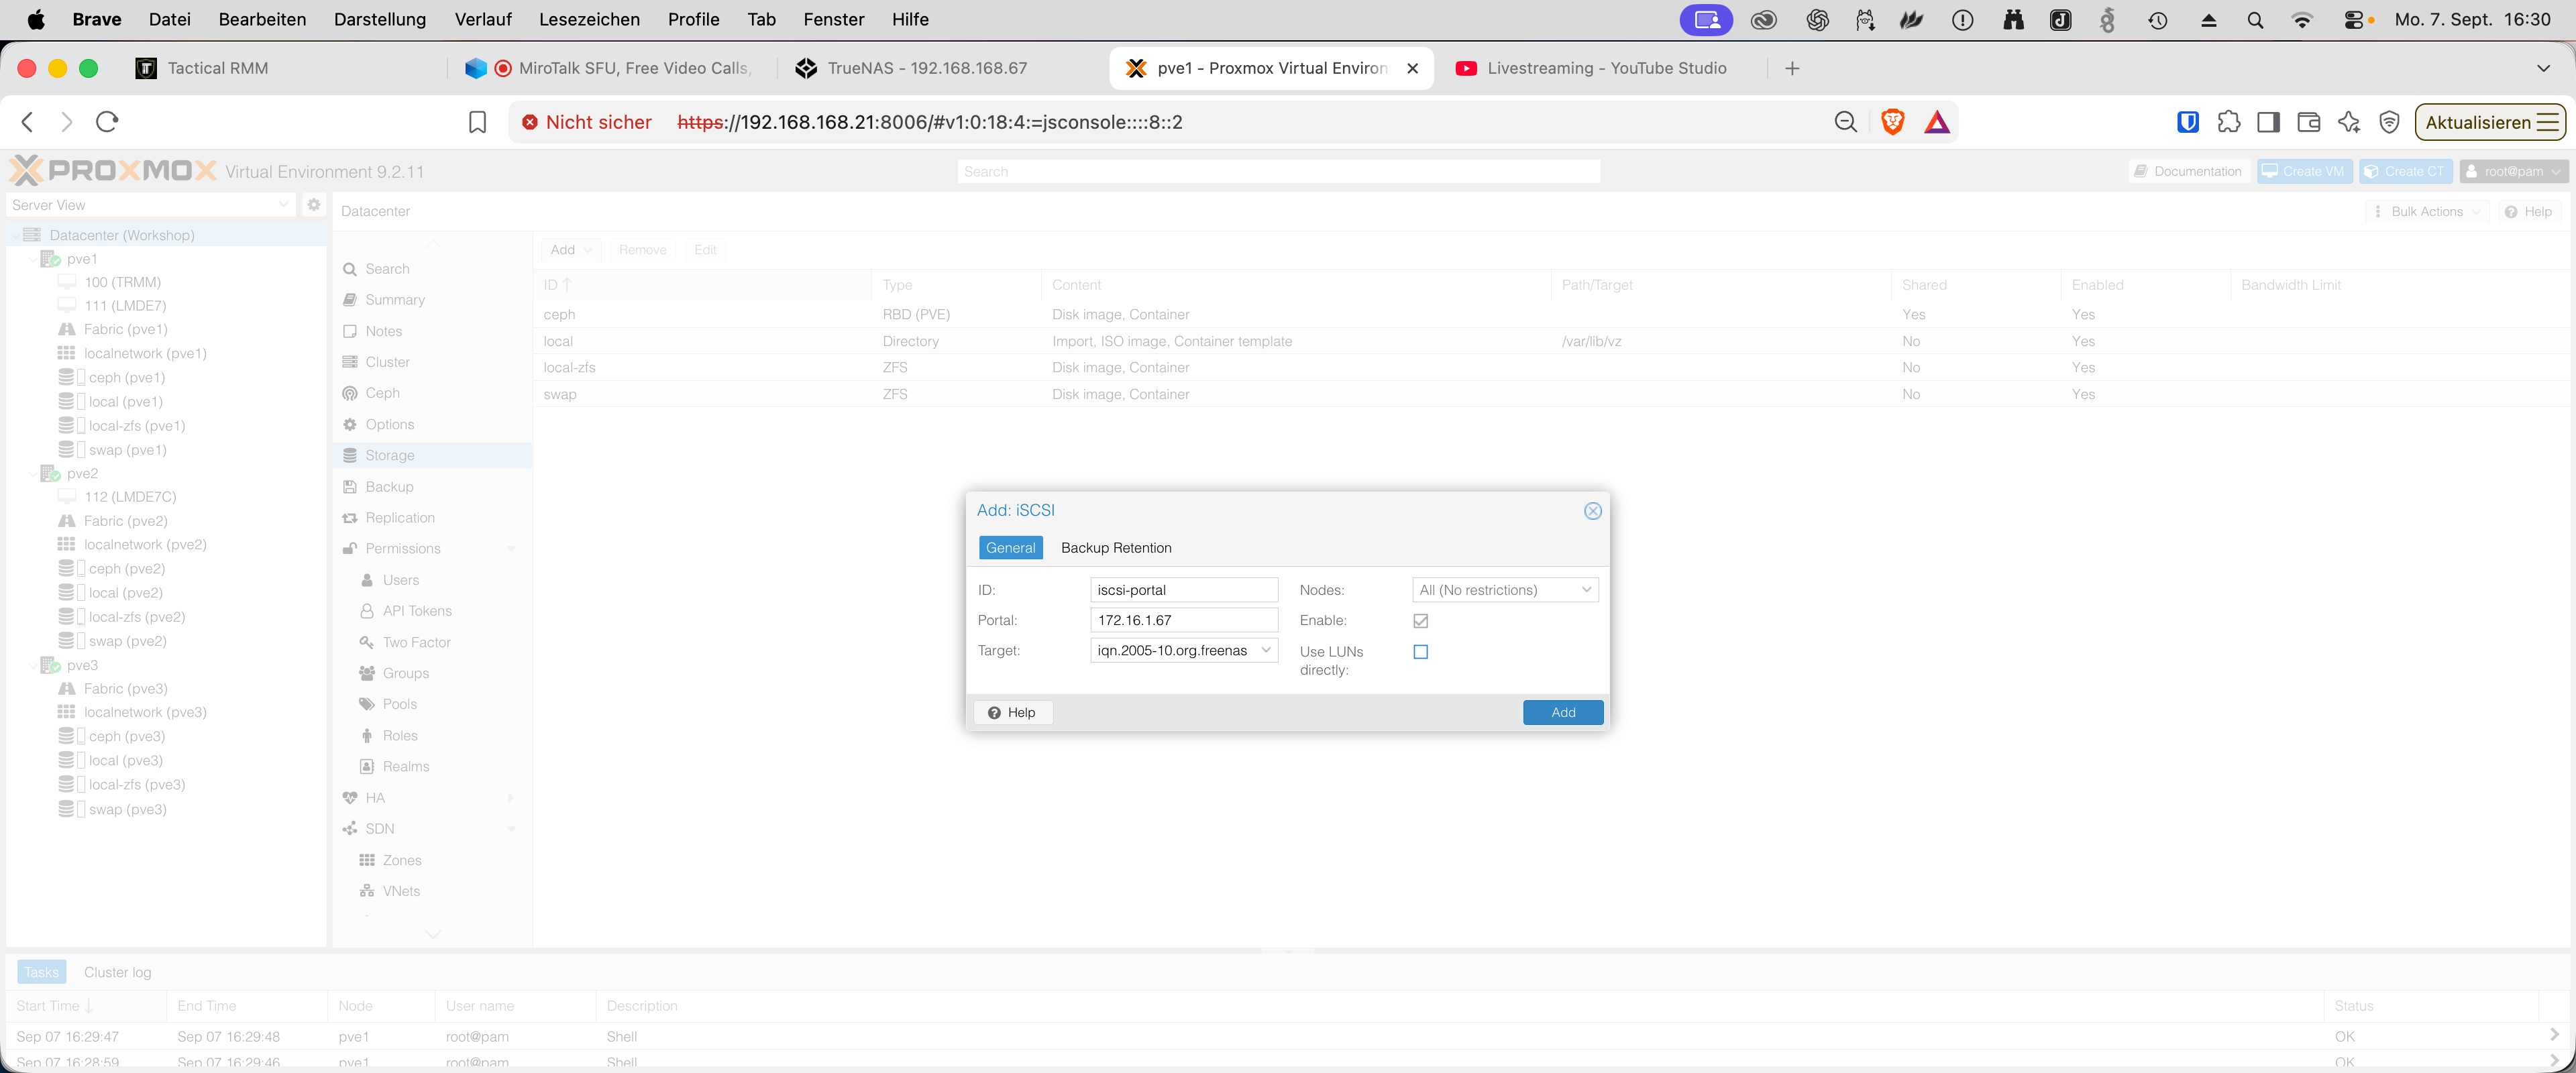
Nach der Einrichtung ist iscsi-portal aktiv. Der Inhaltstyp none passt zur Nutzung als Basis für LVM. Vor der Multipath-Einrichtung erscheinen zwei Geräte mit jeweils 512 GiB. Sie stellen zwei Wege zu derselben LUN dar und dürfen nicht als unabhängige Datenträger verwendet werden.
5. iSCSI-Multipath auf den Proxmox-Knoten einrichten
Multipath-Werkzeuge installieren und Sitzungen prüfen
Auf allen drei Hosts wird die Installation der Multipath-Werkzeuge angestoßen:
apt-get install multipath-tools -yAuf pve1 und pve2 ist der Installationsabschluss sichtbar. Auf pve3 bestätigen die späteren Abfragen die Verfügbarkeit. Die iSCSI-Sitzungen werden mit folgendem Befehl geprüft:
iscsiadm -m sessionAuf pve3 sind Verbindungen zu beiden Portalen über TCP-Port 3260 sichtbar.
Dieselbe LUN über ihre WWID identifizieren
Im gezeigten Beispiel heißen die beiden Pfadgeräte auf pve3 /dev/sdd und /dev/sde. Ihre Identität wird so abgefragt:
/lib/udev/scsi_id -g -u -d /dev/sdd
/lib/udev/scsi_id -g -u -d /dev/sdeBeide liefern die WWID 36589cfc00000005cf4f3f236e1d7b5b0. Die Gerätenamen können auf anderen Hosts oder nach einem Neustart abweichen. Vor einer Übernahme der Befehle müssen die tatsächlich vorhandenen Geräte geprüft werden.
WWID registrieren und Multipath kontrollieren
multipath -a 36589cfc00000005cf4f3f236e1d7b5b0
multipath -r
multipath -ll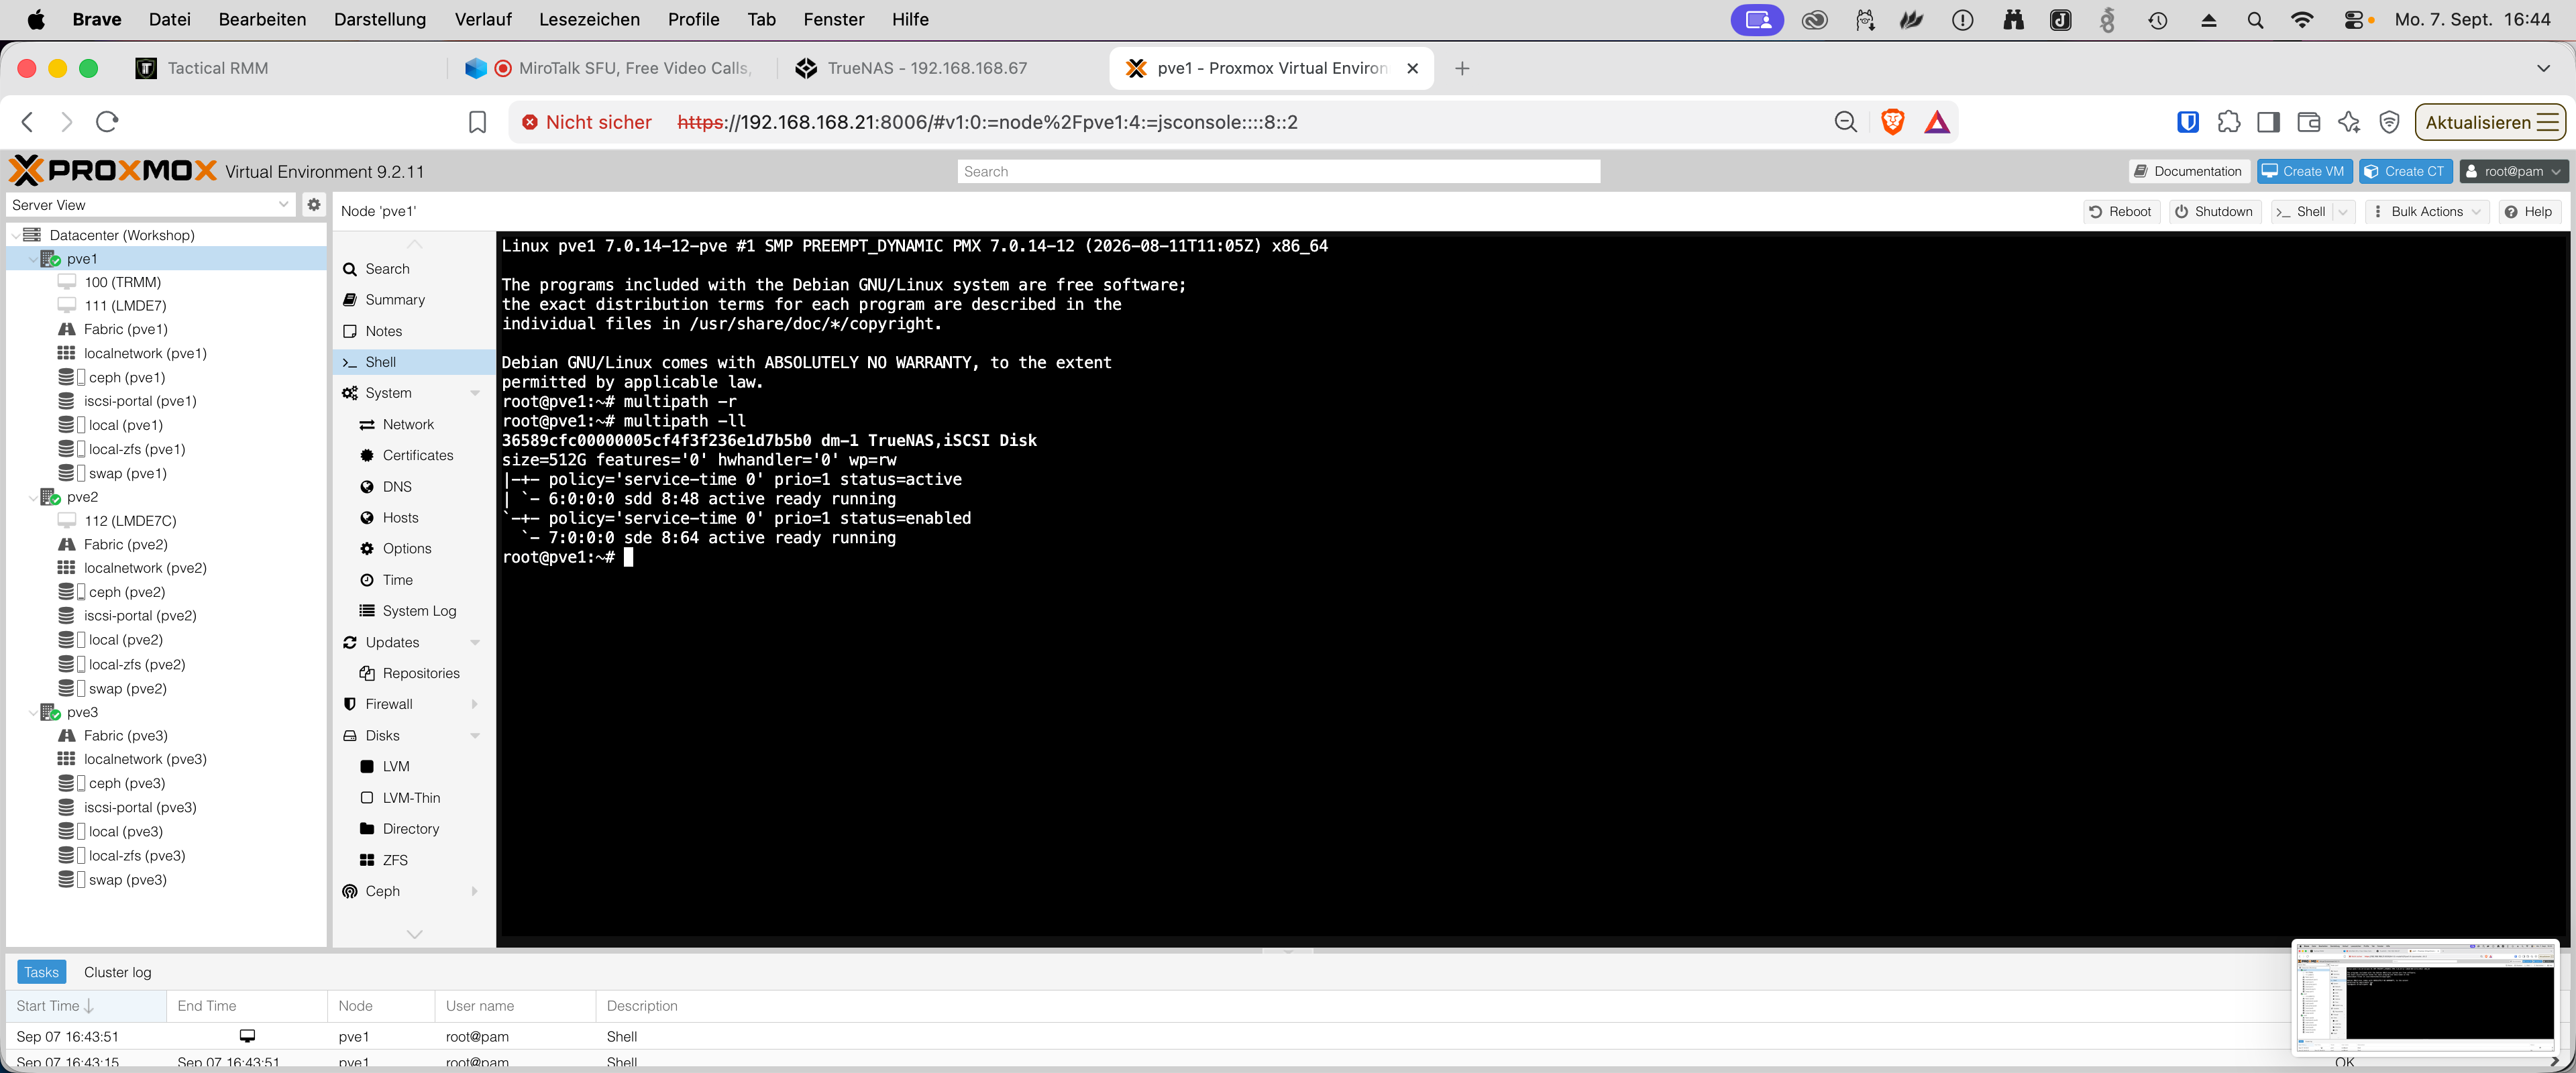
Vergleichbare abschließende Ausgaben sind auf allen drei Hosts sichtbar. Eine aktive und eine weitere verfügbare Pfadgruppe sind dokumentiert. Ein praktischer Ausfalltest wurde damit noch nicht nachgewiesen.
Wichtige Korrektur: Konfiguration und WWID-Datei trennen
Im Workshop wird zwischenzeitlich ein multipaths { … }-Block mit einem Alias in /etc/multipath/wwids eingetragen. Ein solcher Block gehört in die Multipath-Konfiguration, üblicherweise /etc/multipath.conf. Die WWID-Datei dient der Registrierung der Geräte und wird über die Multipath-Werkzeuge gepflegt.
Später wird die WWID erneut hinzugefügt und die Datei zwischen Hosts kopiert. Obwohl die abschließenden Geräteausgaben erfolgreich sind, ist der endgültige Dateiinhalt nicht sichtbar. Die Bereinigung muss deshalb vor einer Abnahme geprüft werden.
iSCSI-Timeouts auf tatsächliche Wirksamkeit prüfen
Auf pve3 wird in /etc/iscsi/iscsid.conf folgende Einstellung gezeigt:
node.session.timeo.replacement_timeout = 15Eine spätere Sitzungsdetailansicht zeigt weiterhin Recovery Timeout: 120. Das deutet darauf hin, dass die geänderte Vorgabe in der betrachteten Sitzung noch nicht wirksam war. Konfigurationsdatei, gespeicherte Verbindungseinträge und aktive Sitzungen müssen gemeinsam geprüft werden.
SSH-Loginprobleme nach manuellen Verbindungen zwischen den Knoten
Während der Einrichtung können bei manuellen SSH-Verbindungen zwischen den Nodes Loginprobleme auftreten, beispielsweise durch widersprüchliche gespeicherte Hostschlüssel. Eine manuelle Verbindung verursacht nicht grundsätzlich einen Fehler; entscheidend ist die konkrete SSH-Meldung.
Bei einem veralteten Hostschlüsseleintrag lässt sich beispielsweise so vorgehen: Zunächst den aktuellen Fingerprint auf dem Zielknoten über eine vertrauenswürdige Konsole anzeigen und mit der SSH-Meldung vergleichen:
ssh-keygen -lf /etc/ssh/ssh_host_ed25519_key.pubNur wenn der Schlüsselwechsel geklärt ist und die Fehlermeldung auf /root/.ssh/known_hosts verweist, auf dem Quellknoten die betroffenen Einträge entfernen. Beispiel für pve2:
ssh-keygen -f /root/.ssh/known_hosts -R pve2
ssh-keygen -f /root/.ssh/known_hosts -R 192.168.168.22
ssh root@pve2Beim erneuten Verbindungsaufbau den angezeigten Fingerprint prüfen. Bei abweichendem Hostnamen oder Dateipfad die Angaben aus der tatsächlichen Fehlermeldung verwenden; nicht pauschal die gesamten Known-Hosts-Dateien löschen.
Bei veralteten Proxmox-Hostschlüsseldaten, etwa nach erneutem Beitritt eines Nodes mit gleichem Namen oder gleicher IP, kann auf dem betroffenen Zielknoten außerdem Folgendes helfen:
pvecm updatecertsProxmox verwendet versionsabhängig eigene Hostschlüsseldateien beziehungsweise explizites Host-Key-Pinning. Ein erfolgreicher manueller SSH-Login allein bestätigt daher nicht jede von Proxmox verwendete SSH-Verbindung. Siehe die Proxmox-Clusterdokumentation zur Rolle von SSH. Bei „Permission denied (publickey)“ stattdessen die Anmeldung mit Schlüsseln und die Zugriffsrechte prüfen; das Entfernen eines Hostschlüsseleintrags behebt diesen anderen Fehler nicht.
6. Gemeinsamen LVM-Speicher auf der iSCSI-LUN hinzufügen
Unter Datacenter → Storage → Add → LVM wird der Speicher truenas angelegt. Als Basisspeicher dient iscsi-portal, als Basisvolume die LUN 0. Die Volume Group erhält im Workshop den Namen pve. Zugelassen sind VM-Festplatten und Container.
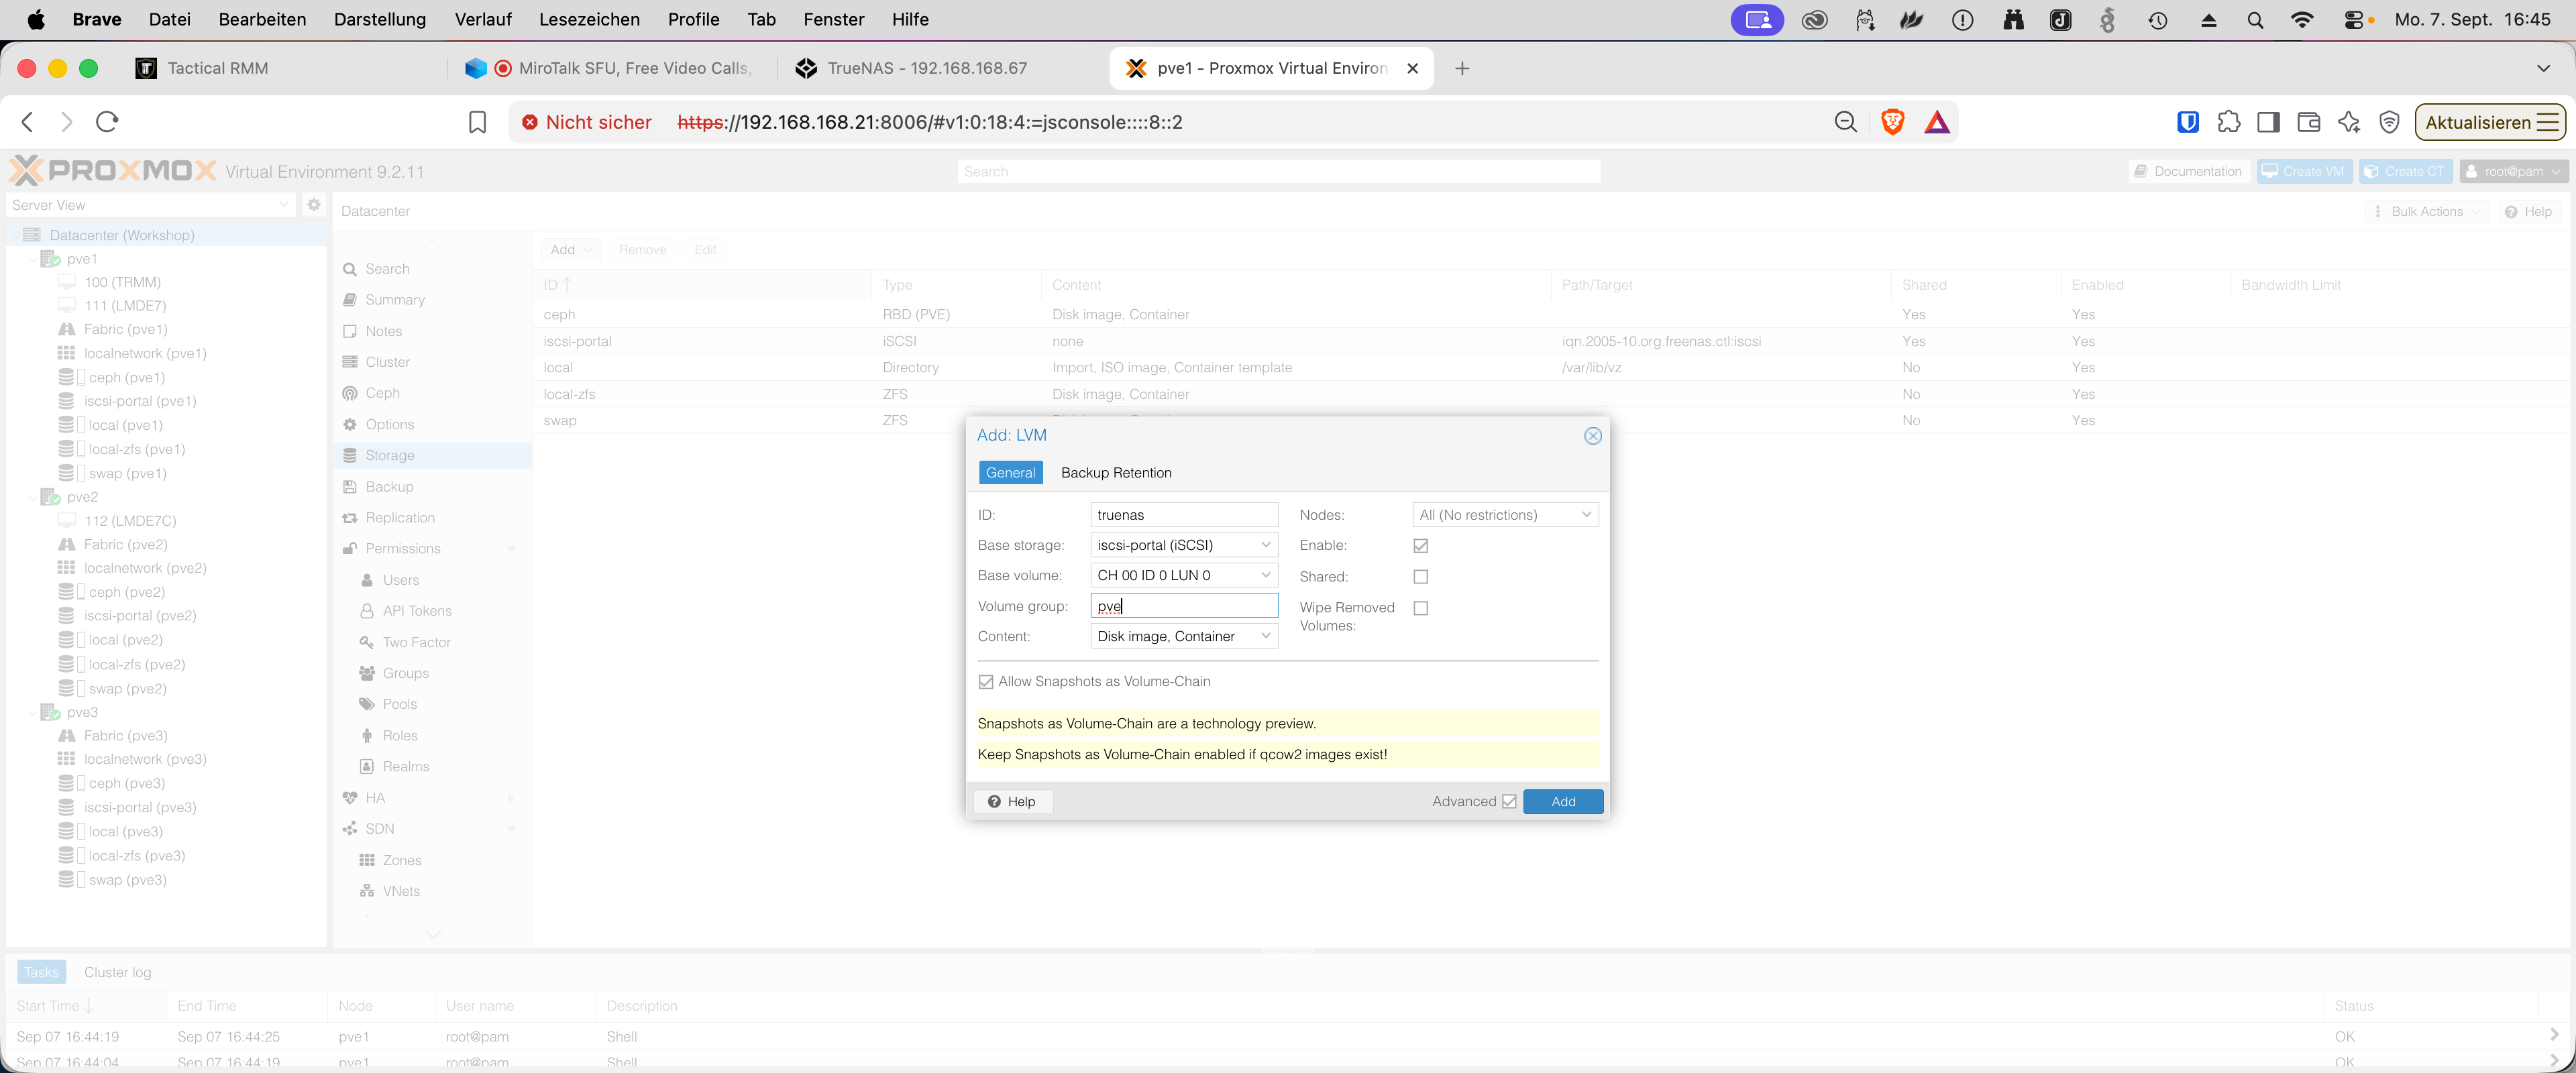
Die Ausgabe von pvs auf pve1 ordnet die Volume Group dem Multipath-Gerät unter /dev/mapper/… zu. Proxmox zeigt etwa 549,75 GB Gesamtkapazität, entsprechend ungefähr 512 GiB.
Später werden Shared und Wipe Removed Volumes aktiviert. Die Option Allow Snapshots as Volume-Chain bleibt eingeschaltet.
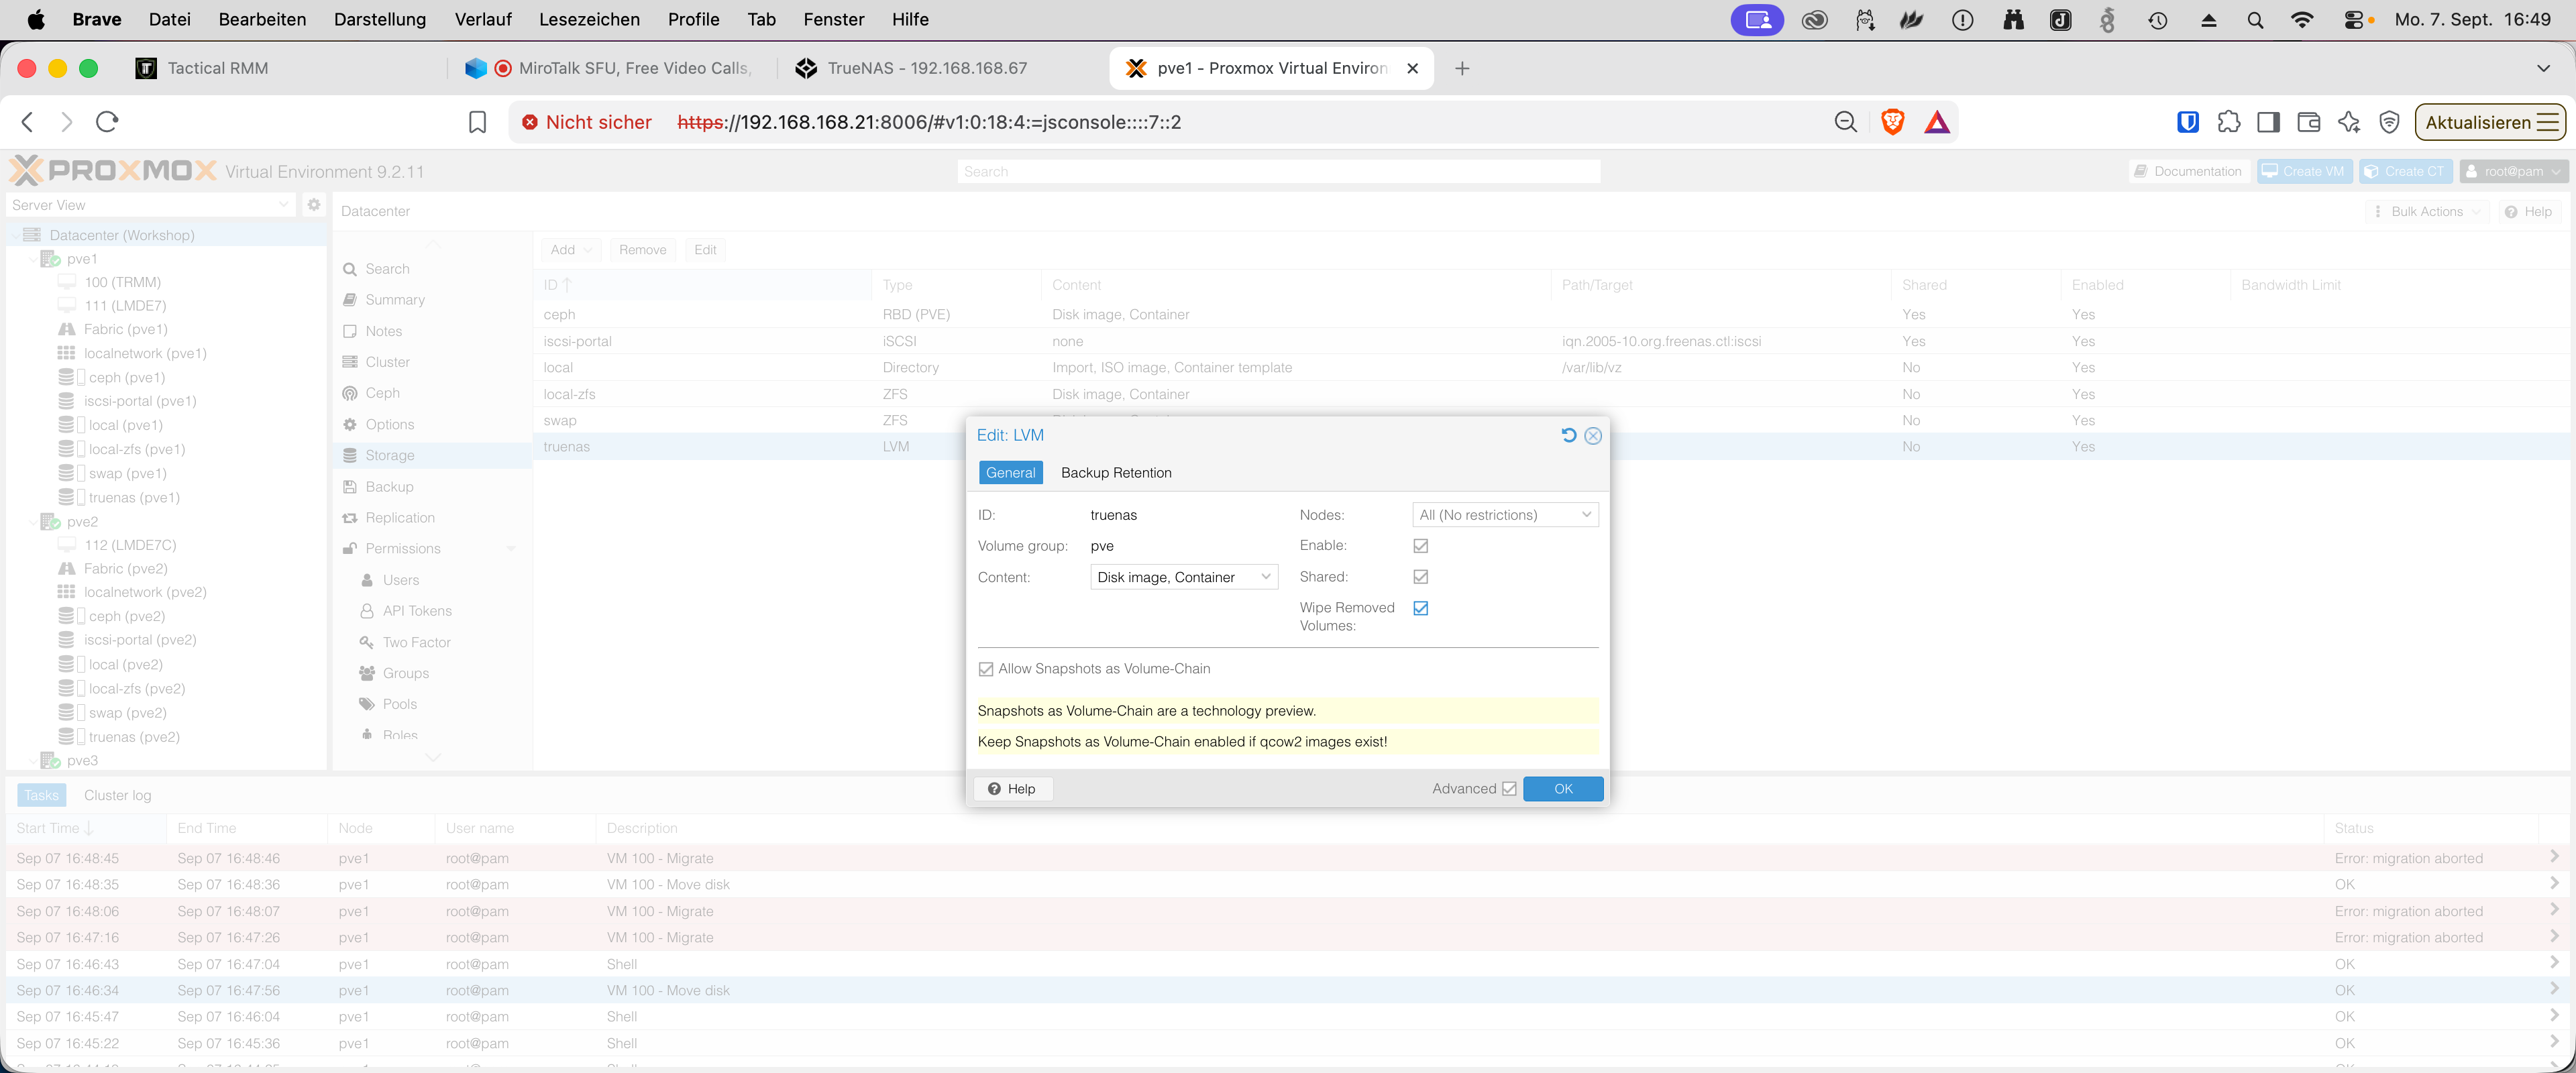
Shared stellt keine Speicherverbindung her. Die Einstellung beschreibt einen bereits von mehreren Knoten erreichbaren Speicher. Alle Hosts müssen dieselbe LUN und Volume Group erkennen.
Die Oberfläche kennzeichnet Volume-Chain-Snapshots als Technology Preview. QCOW2 auf LVM ist in diesem Zusammenhang nicht automatisch falsch: Das Proxmox-Administrationshandbuch beschreibt diese Funktion für neuere Versionen. Bei bereits vorhandenen abhängigen Volumes darf die Option nicht unvorbereitet deaktiviert werden.
7. VM-Festplatte auf TrueNAS verschieben und Migration prüfen
Als Beispiel dient VM 100 (TRMM) mit 8 GiB RAM, vier CPU-Kernen, CPU-Typ host, OVMF/UEFI und einer 32-GiB-Systemfestplatte. Die VM verwendet einen VirtIO-SCSI-single-Controller und ein VirtIO-Netzwerkgerät an vmbr0.
Systemfestplatte auf den LVM-Speicher verschieben
In der Hardwareansicht wird für scsi0 die Aktion zum Verschieben des Speichers geöffnet. Ausgewählt sind das Ziel truenas, das Format qcow2 und das Löschen der Quelle nach dem Verschieben.
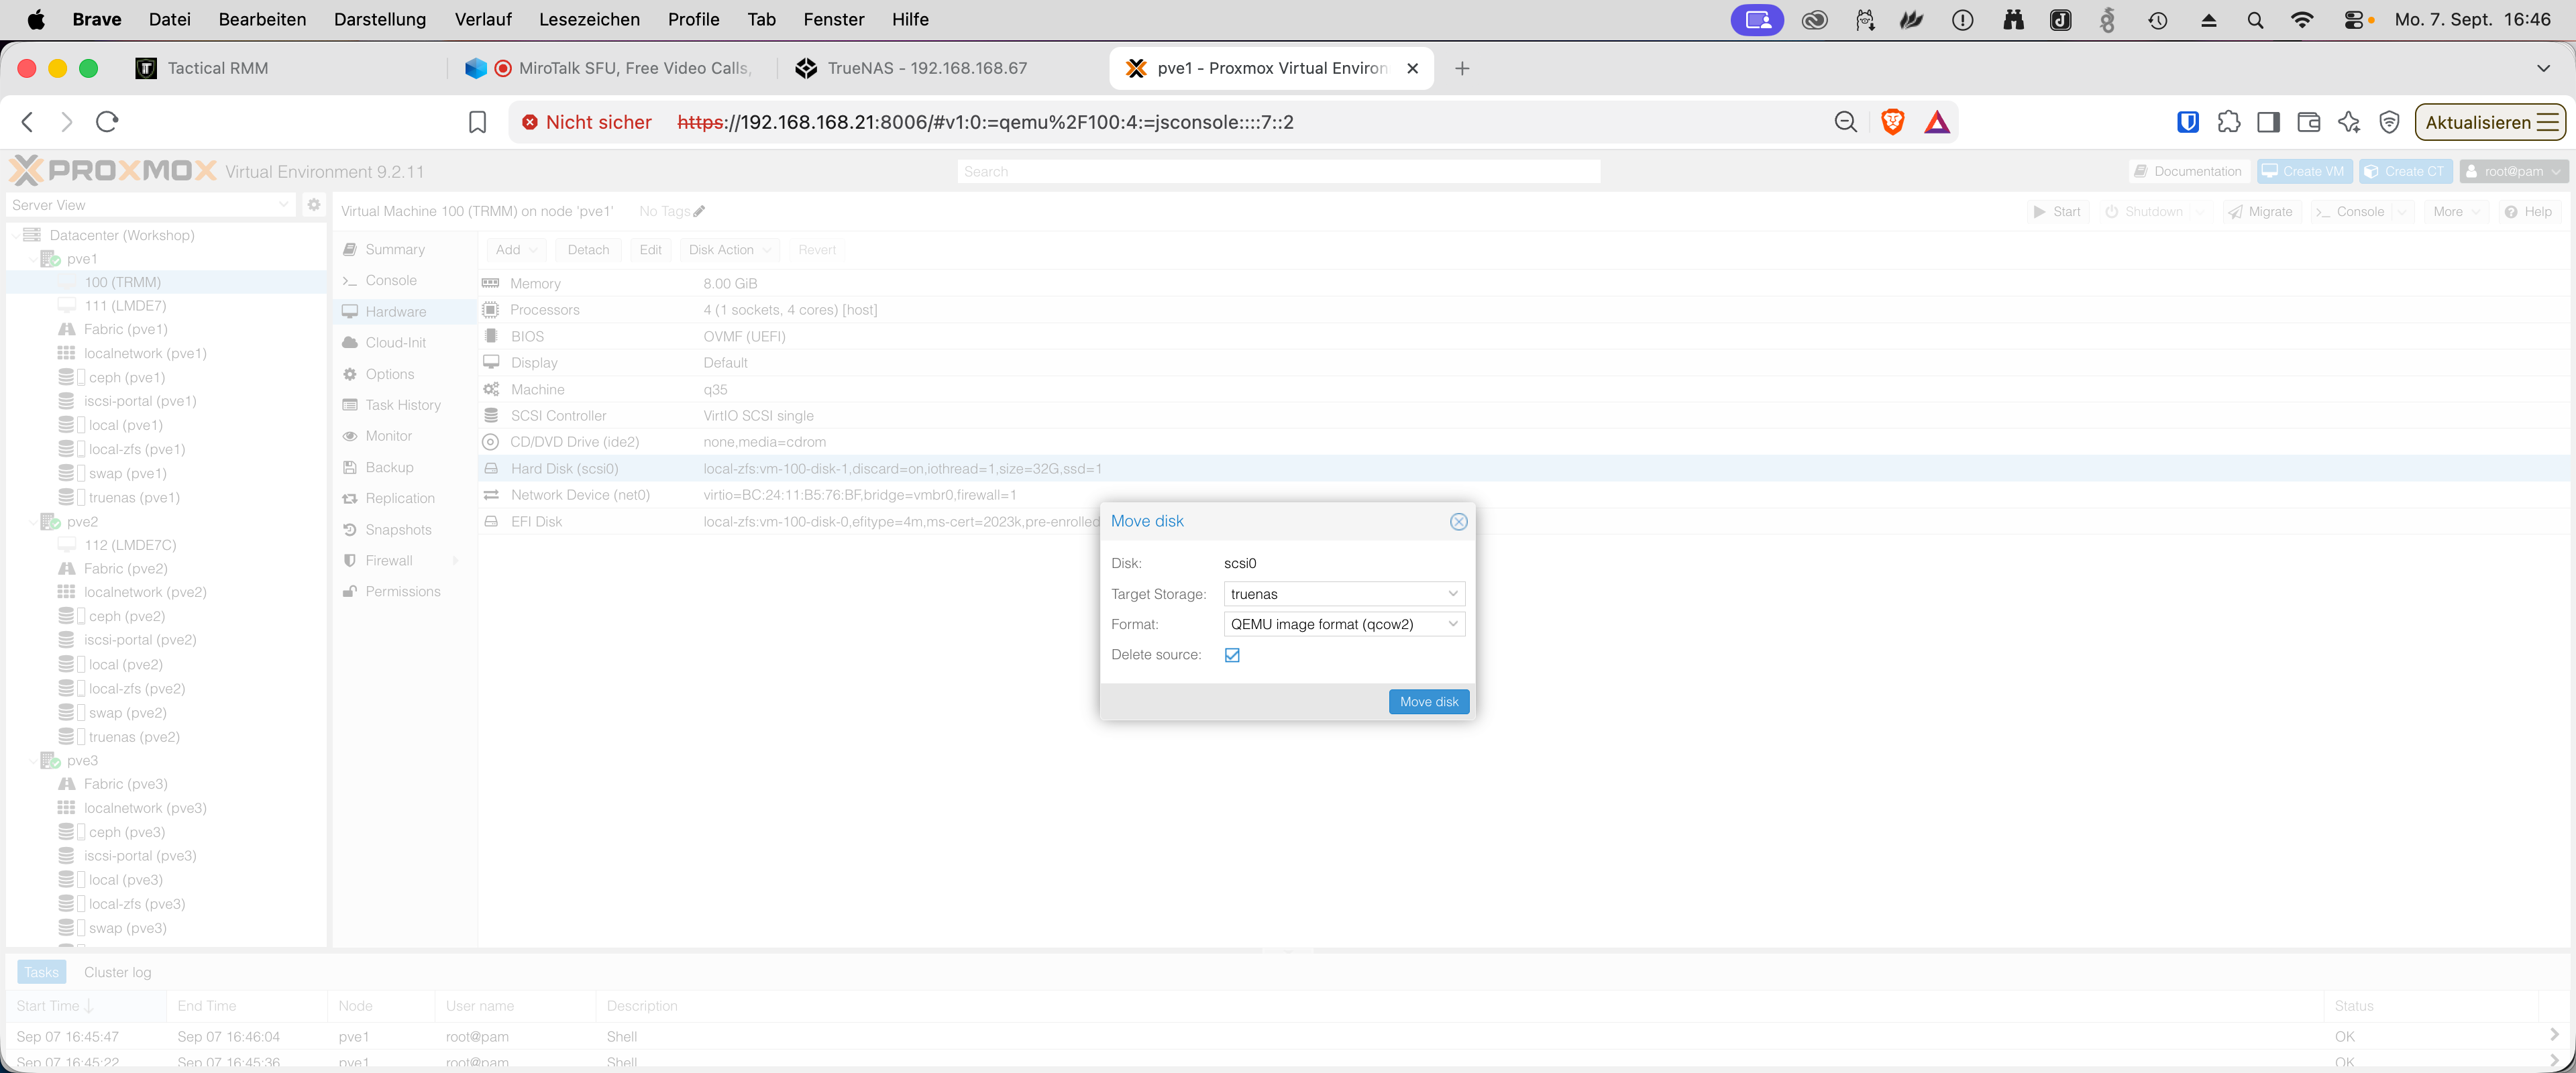
Das Zielvolume lautet truenas:vm-100-disk-0.qcow2. Die spätere Aufgabenliste bestätigt den Verschiebevorgang mit OK. Um 16:48 Uhr liegt die EFI-Disk noch auf local-zfs. Ein weiterer erfolgreicher Verschiebetask ist sichtbar, dessen betroffenes Volume jedoch nicht eindeutig belegt ist.
Migrationsfehler gelöst: Shared, ZFS-Replikation und alle VM-Disks prüfen
Mehrere Offline-Migrationen von pve1 nach pve2 enden mit Error: migration aborted. Frühere Dialoge warnen vor lokalen Datenträgern. Nach dem Aktivieren von „Shared“ zeigt der abgebildete Dialog diese Warnungen nicht mehr.
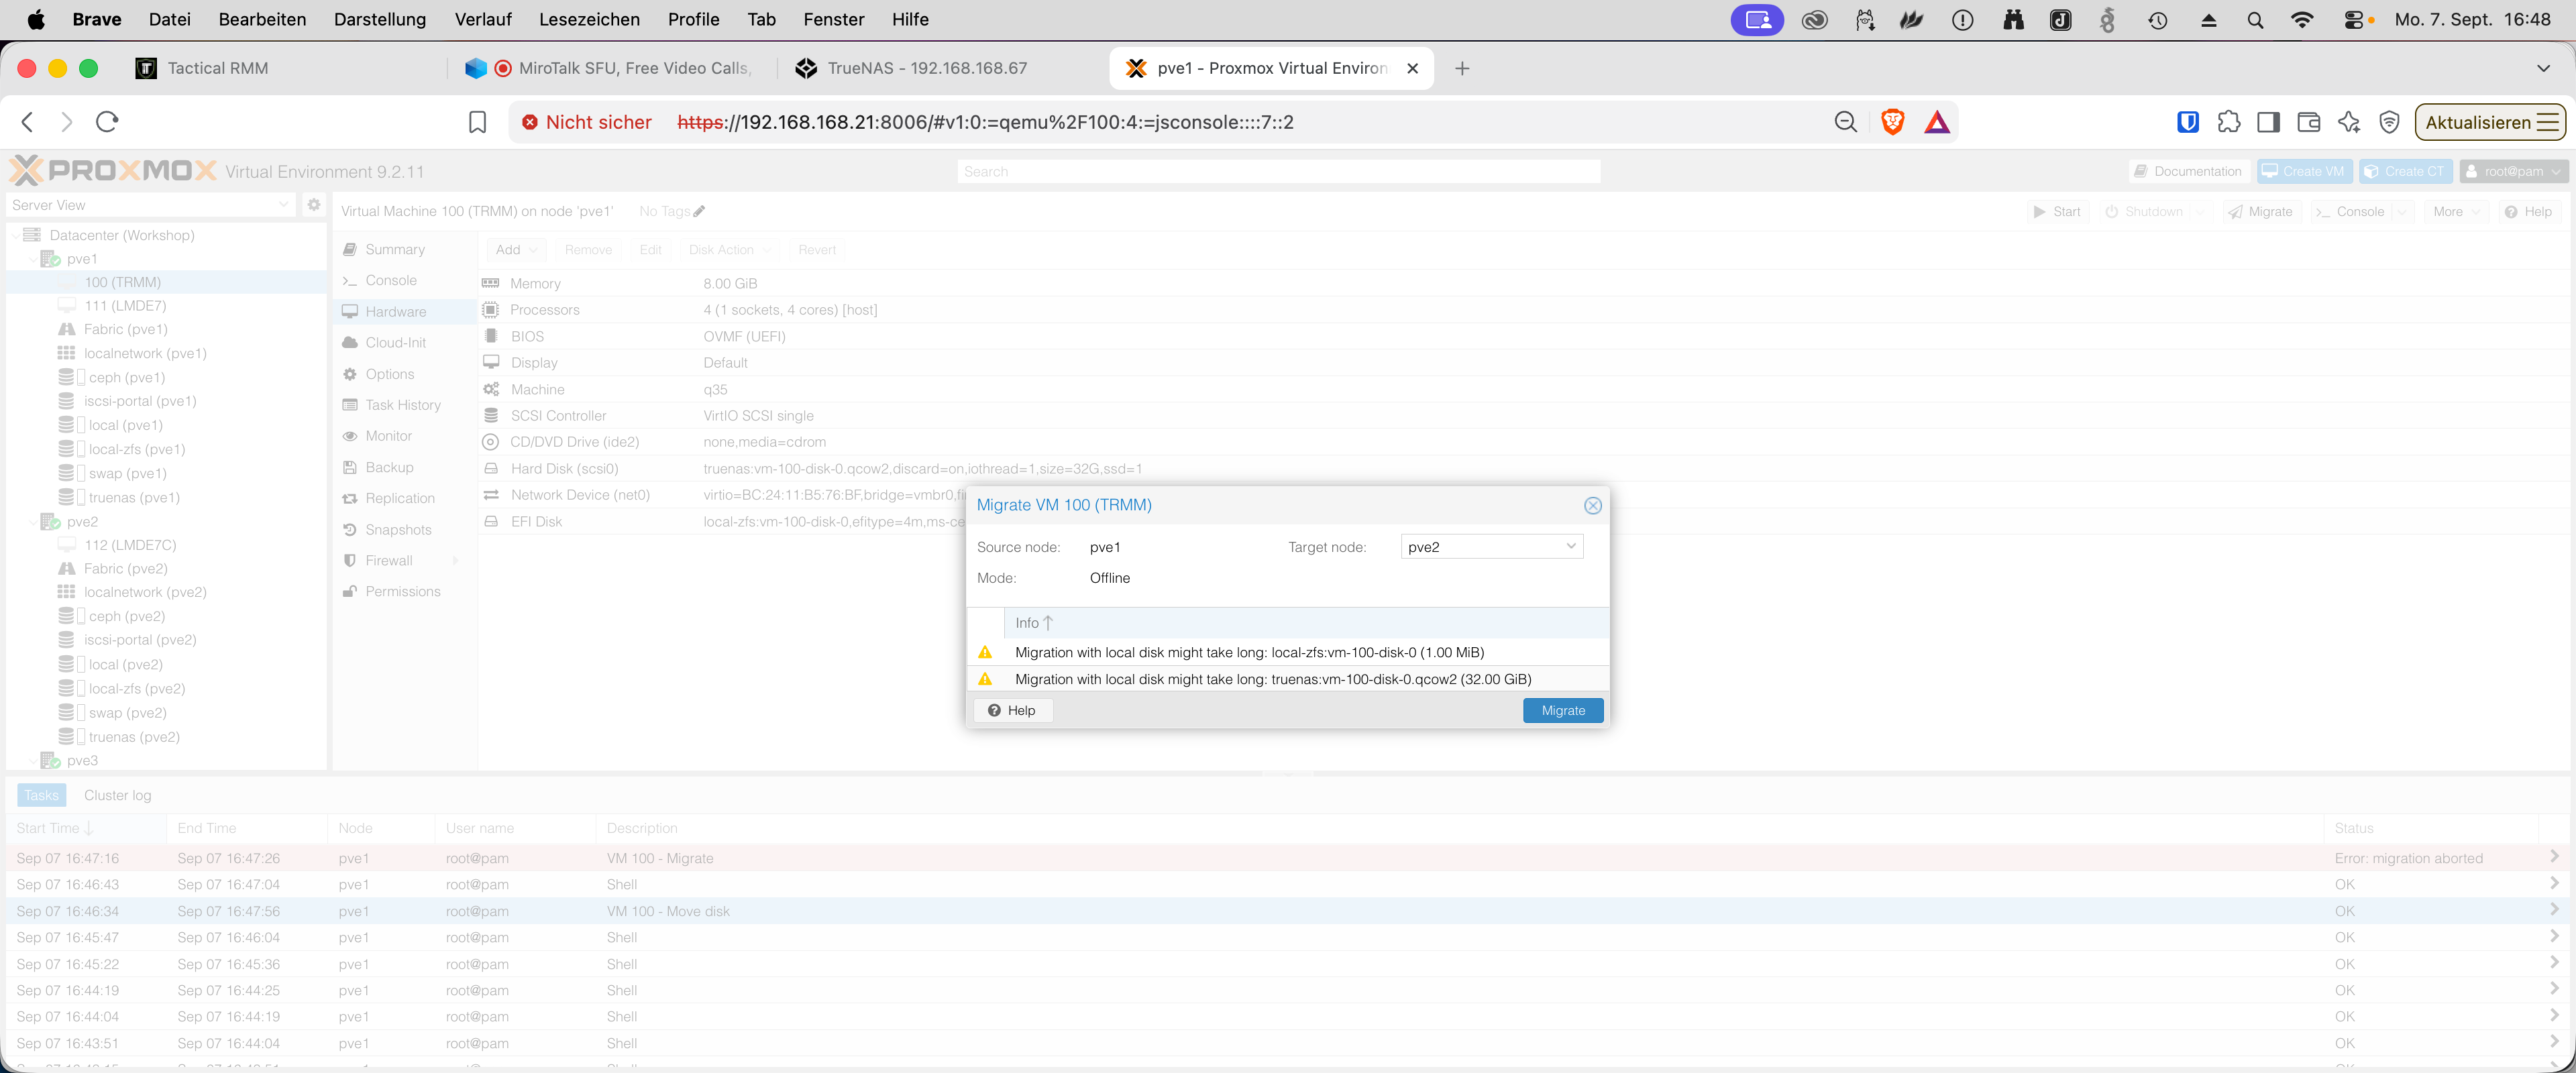
Die Ursache wurde im weiteren Workshop-Verlauf geklärt: Für die betroffene VM war noch ein ZFS-Replikationsjob eingerichtet. Dieser verbliebene Job verursachte die fehlgeschlagene Migration. Zusätzlich war bei der Anlage des LVM-Speichers zunächst der Haken bei „Shared“ vergessen worden.
Für den Wechsel auf den gemeinsamen iSCSI-Speicher wurden deshalb folgende Punkte umgesetzt:
- Shared aktivieren: Den tatsächlich auf allen Knoten erreichbaren LVM-Speicher als gemeinsam genutzt markieren.
- Keine bisherigen ZFS-Replikationsjobs zurücklassen: Die für die umgestellte VM eingerichteten Jobs unter „Replication“ entfernen und deren Entfernung abwarten. Die native lokale ZFS-Replikation wird für die nun gemeinsam genutzten iSCSI-Disks nicht benötigt.
- Alle Disks migrieren: Neben der System- und den Datenfestplatten auch die EFI-Disk und eine gegebenenfalls vorhandene TPM-State-Disk auf den gemeinsamen Speicher verschieben. Bestehende EFI- und TPM-Datenträger übernehmen, nicht neu erstellen.
Danach liefen alle Migrationen tadellos. Dieses Ergebnis wurde nachträglich aus dem Workshop bestätigt; die eingebetteten Screenshots zeigen noch die vorherigen Zwischenstände.
Letzter dokumentierter Stand: Klonvorgang läuft
Der letzte Screenshot um 16:55 Uhr zeigt einen laufenden Klonvorgang von VM 111 mit etwa 21 Prozent Fortschritt. Das Zielvolume gehört zu VM 101 auf truenas. Ein Abschluss ist nicht abgebildet. Der im Hintergrund sichtbare Replikationsjob von VM 111 nach pve2 gehört noch zum aufgenommenen Zwischenstand. Der Klonabschluss ist nicht abgebildet; die anschließend fehlerfrei laufenden Migrationen wurden nachträglich bestätigt.
8. Prüfliste für die Abnahme des gemeinsamen Speichers
- Auf jedem Proxmox-Knoten sind beide TrueNAS-Portale verbunden.
- Alle Knoten erkennen dieselbe WWID und zwei fehlerfreie Multipath-Pfade.
- Die gemeinsame Volume Group ist über das Multipath-Gerät erreichbar.
- Multipath-Konfiguration und WWID-Registrierung sind korrekt getrennt.
- Die gewünschten iSCSI-Timeouts sind in den verwendeten Verbindungen wirksam.
- Shared ist aktiviert; auf allen Knoten ist tatsächlich derselbe Speicher erreichbar.
- Für die auf iSCSI umgestellten VMs sind keine bisherigen ZFS-Replikationsjobs mehr eingerichtet.
- Sämtliche VM-Disks einschließlich EFI und gegebenenfalls TPM liegen auf dem gemeinsamen Speicher.
- Eine Offline-Migration endet mit OK; die VM startet und funktioniert auf dem Zielhost.
- Ein kontrollierter Test bestätigt den Weiterbetrieb beim Ausfall eines einzelnen SAN-Pfads.
- Nach einem Host-Neustart sind Speicher und beide Verbindungen automatisch verfügbar.
- Ein unabhängiges Backup wurde erfolgreich wiederhergestellt und geprüft.
9. Optimierungstipps für Proxmox, TrueNAS und iSCSI-Multipath
Bewährte Konfiguration für weitere Migrationen übernehmen
- Multipath-Dateien vereinheitlichen: Prüfe die Konfiguration und die registrierten WWIDs auf allen Hosts. Vergleiche vorhandene Inhalte, bevor Dateien überschrieben werden.
- Shared und Replikationsjobs prüfen: Im Workshop war Shared zunächst vergessen worden; ein verbliebener ZFS-Replikationsjob verursachte den Migrationsabbruch. Bei weiteren Umstellungen Shared aktivieren und bisherige ZFS-Replikationsjobs der betroffenen VM entfernen. Bei neuen Fehlern zusätzlich das vollständige Migrationslog auswerten.
- Alle VM-Datenträger berücksichtigen: Verschiebe neben der Systemfestplatte auch Daten-, EFI- und gegebenenfalls TPM-State-Disks auf den gemeinsamen Speicher.
- Timeouts kontrolliert übernehmen: Kläre die Abweichung zwischen den konfigurierten 15 Sekunden und den sichtbaren 120 Sekunden. Änderungen an bestehenden Speicherverbindungen gehören in ein Wartungsfenster.
Ausfallsicherheit praktisch nachweisen
- Unabhängige SAN-Wege verwenden: Getrennte Subnetze sollten durch geeignete physische Wege ergänzt werden. Prüfe Adapter, Verkabelung und Switches auf gemeinsame Ausfallpunkte. Die TrueNAS-Netzwerkempfehlungen erläutern die Verwendung zusätzlicher iSCSI-Portale.
- Pfadwechsel testen: Unterbrich mit einer Test-VM und laufenden Ein-/Ausgaben jeweils nur einen SAN-Pfad. Prüfe anschließend auch dessen Wiederkehr und einen Host-Neustart.
- TrueNAS-Ausfall einplanen: Mirror und Multipath schützen gegen unterschiedliche Teilfehler. Der vollständige Ausfall eines einzelnen TrueNAS-Systems erfordert weiterhin einen Wiederanlaufplan und unabhängige Sicherungen.
Leistung, Wartung und Sicherheit verbessern
- Vorschaufunktionen gezielt testen: Prüfe bei Volume-Chain-Snapshots insbesondere Erstellung, Löschen, Backup, Restore und Migration mit der eingesetzten Version.
- Eindeutige Namen wählen: Bei künftigen Einrichtungen lässt sich eine Volume Group wie
vg_truenas_iscsileichter zuordnen alspve. Bestehende Gruppen nicht ohne Prüfung ihrer Referenzen umbenennen. - Leistung messen: Erfasse Durchsatz, IOPS und Latenz in einer Test-VM, bevor MTU, Pfadverteilung oder ZFS-Parameter geändert werden. Jumbo Frames benötigen eine durchgängig passende Netzwerkkonfiguration.
- SSD-Wartung ergänzen: Prüfe TRIM-Unterstützung und Laufwerksüberwachung. Im dokumentierten Stand ist Auto TRIM ausgeschaltet; Temperaturdaten fehlen. Überwache außerdem Poolkapazität, Speicherfehler und ausgefallene Pfade.
- Zugriffe begrenzen: Behalte eindeutige Initiatorlisten bei und beschränke die SAN-Erreichbarkeit auf die vorgesehenen Hosts. Prüfe CHAP oder Mutual CHAP als zusätzliche Authentifizierung. CHAP verschlüsselt den Datenverkehr nicht. Weitere Informationen enthält die TrueNAS-iSCSI-Dokumentation.
- Backups unabhängig speichern: Sichere VMs außerhalb der produktiven LUN und dokumentiere einen erfolgreichen Restore mit VM-Start und Anwendungstest. Mirror, Snapshots und Replikation ersetzen dieses Backup nicht.
Round Robin aktivieren: beide gleichwertigen SAN-Pfade nutzen
Round Robin verteilt I/O reihum auf die Pfade einer aktiven Pfadgruppe. Bei gleichwertigen Verbindungen kann dies beide SAN-Links besser auslasten. Eine Verdopplung der Leistung ist nicht garantiert; service-time kann bei unterschiedlich schnellen oder belasteten Wegen günstiger sein.
Der gezeigte Stand hat je Pfad eine eigene Gruppe. Der Selektor allein genügt daher nicht. Nur wenn beide Wege gleichzeitig gleichwertig nutzbar sind, eignet sich multibus für eine gemeinsame Gruppe. Bei ALUA- oder Active/Passive-Systemen die herstellergerechte Gruppierung beibehalten.
Auf jedem Node den bestehenden Eintrag dieser LUN in /etc/multipath.conf ergänzen; übrige Konfiguration erhalten:
multipaths {
multipath {
wwid 36589cfc00000005cf4f3f236e1d7b5b0
path_grouping_policy multibus
path_selector "round-robin 0"
rr_weight uniform
rr_min_io_rq 1
}
}rr_min_io_rq 1 bewirkt bei request-basiertem Multipath einen Wechsel nach einer I/O-Anforderung. Das Beispiel verändert keinen Gerätealias.
Im Wartungsfenster zunächst die aufgelöste Konfiguration auf Fehler prüfen, dann neu laden:
multipath -t
multipathd reconfigure
multipath -llErwartet: round-robin 0 und beide gesunden Pfade in derselben aktiven Gruppe. Danach Durchsatz, Latenz und Pfadausfall mit einer Test-VM prüfen. Die Option ist eine Optimierungsempfehlung, kein im Workshop belegter Änderungsschritt. Parameterreferenz: Debian-Handbuch zu multipath.conf.
OPNsense Migration Legacy zu Instance, ohne neues Ausrollen von Konfigurationen
OPNsense: OpenVPN Legacy zu Instances migrieren – ohne Neukonfiguration der Clients
In OPNsense werden die bisherigen OpenVPN-Legacy-Konfigurationen abgekündigt. Wer unter VPN → OpenVPN → Legacy arbeitet, kennt vermutlich bereits die folgende Meldung:
This component is reaching the end of the line, official maintenance will end as of version 26.1
Bestehende OpenVPN-Server sollten daher von der bisherigen Legacy-Konfiguration auf OpenVPN Instances migriert werden.
Die Migration ist grundsätzlich unkompliziert. Wenn die vorhandenen Parameter korrekt übernommen werden, kann die Umstellung erfolgen, ohne die komplette VPN-Konfiguration neu auszurollen. Es gibt allerdings einige Punkte, auf die besonders geachtet werden sollte.
1. Bestehende Legacy-Konfiguration dokumentieren
Öffnet zunächst die vorhandene OpenVPN-Konfiguration unter:
VPN → OpenVPN → Legacy
Die dort vorhandenen Werte werden anschließend in die neue Instanz übernommen. Es empfiehlt sich daher, die bestehende Konfiguration vor der Migration vollständig zu dokumentieren.
Wichtig: Die alte Konfiguration zunächst nicht löschen. Sie dient während der Migration als Referenz für sämtliche Einstellungen.
2. Alten OpenVPN-Server deaktivieren
Deaktiviert den bisherigen OpenVPN-Legacy-Server.
Da die neue Instanz denselben Port verwenden soll, darf der alte und der neue OpenVPN-Server nicht gleichzeitig auf diesem Port lauschen.
3. Shared Key übernehmen
Falls die bisherige OpenVPN-Konfiguration einen Shared Key / TLS Static Key verwendet, muss dieser zunächst übernommen werden.
Öffnet dazu:
VPN → OpenVPN → Static Keys
Übernehmt dort den bisherigen Schlüssel und verwendet als:
| Einstellung | Wert |
|---|---|
| Mode | Auth |
Dieser Key wird später der neuen OpenVPN-Instanz zugeordnet.
4. Neue OpenVPN-Instanz erstellen
Erstellt nun unter OpenVPN eine neue Instanz.
Mindestens die folgenden Einstellungen müssen aus der bisherigen Legacy-Konfiguration übernommen werden:
| Neue OpenVPN Instance | Wert / Quelle aus Legacy |
|---|---|
| Role | Server |
| Enabled | Yes |
| Port Number | Bisherigen Port übernehmen, z. B. 1194 |
| Type | TUN |
| Server IP | Wert aus IPv4 Tunnel Network, z. B. 172.16.1.0/24 |
| Topology | subnet |
| Certificate | Alten Eintrag aus Server Certificate übernehmen |
| Certificate Authority | Alten Eintrag aus Peer Certificate Authority übernehmen |
5. Advanced Mode aktivieren
Blendet anschließend links oben den Advanced Mode ein.
Dadurch werden zusätzliche Einstellungen sichtbar, die für eine möglichst identische Übernahme der bisherigen Legacy-Konfiguration benötigt werden.
6. TLS Static Key konfigurieren
Unter:
TLS Static Key
wählt ihr den zuvor unter Static Keys angelegten bzw. übernommenen Schlüssel aus.
7. Authentifizierung übernehmen
Die bisherigen Authentifizierungsparameter müssen ebenfalls übernommen werden.
| Einstellung | Konfiguration |
|---|---|
| Auth | Alten Wert aus Auth Digest Algorithm übernehmen, z. B. SHA256 |
| Authentication | Bisherigen Authentifizierungsserver auswählen, sofern vorhanden |
| Renegotiate Time | 3600 |
| Auth Token Lifetime | 43200 |
Als Authentication Backend kann beispielsweise ein vorhandener Domain Controller, UCS-Server oder Samba Active Directory verwendet werden.
8. Lokales Netzwerk übernehmen
Unter:
Local Network
übernehmt ihr den bisherigen Wert aus:
IPv4 Local Network
Damit werden die bisher über den VPN-Tunnel erreichbaren internen Netzwerke wieder entsprechend bereitgestellt.
9. Achtung bei Compression
Hier befindet sich einer der wichtigen Fallstricke bei der Migration.
Falls in der bisherigen Legacy-Konfiguration unter Compression ein Wert ausgewählt war, muss in der neuen Instance im Advanced Mode zusätzlich:
Compression Migrate
aktiviert werden.
Achtung: Dies gilt auch dann, wenn in der bisherigen Konfiguration bei Compression Disabled ausgewählt war.
10. Weitere Parameter prüfen
Abhängig von der bisherigen OpenVPN-Konfiguration können weitere Parameter erforderlich sein. Vergleicht daher vor dem produktiven Einsatz die neue Instance vollständig mit der bisherigen Legacy-Konfiguration.
Besonders geprüft werden sollten:
- Port und Protokoll
- Tunnel-Netzwerk
- lokale Netzwerke
- Zertifikate und Certificate Authority
- TLS Static Key
- Authentifizierungsserver
- Auth Digest Algorithm
- Compression-Einstellungen
- zusätzliche Advanced-Optionen
Besonderheit der OPNsense Business Edition
Hinweis zur Business Edition: Die OPNsense Business Edition 24.10 verfügt noch nicht über die Option Compression Migrate.
Für entsprechende bestehende Konfigurationen muss daher auf eine geeignete Business-Version 25.x gewartet werden.
Technischer Stand
Diese Anleitung basiert auf dem technischen Stand von April 2025. Die beschriebene Migration wurde mit:
OPNsense 25.1.4_1-amd64
durchgeführt.
Hinweis: OPNsense entwickelt die OpenVPN-Instance-Konfiguration kontinuierlich weiter. Bezeichnungen und verfügbare Optionen können sich in neueren Versionen ändern.
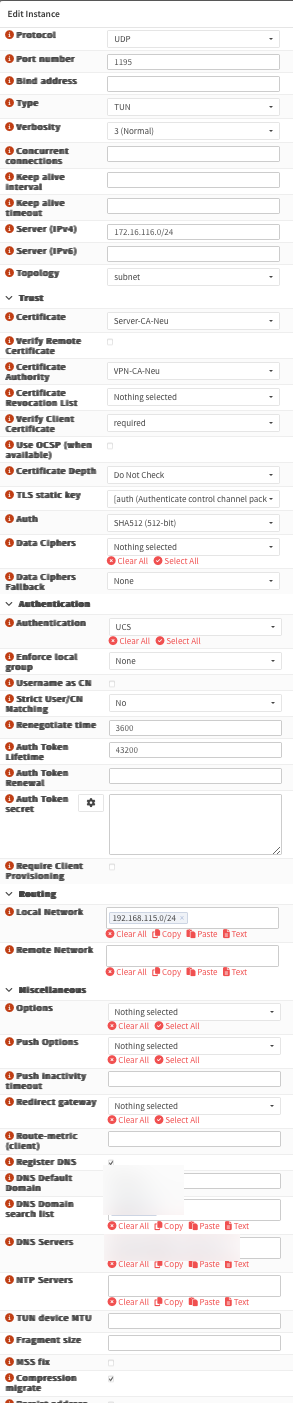
Backup und Replikation trojanersicher für Proxmox VE mit Miyagi Workflow
Trojanersichere Backups und Replikationen mit Proxmox Backup Server, ZFS und Miyagi
Ziel ist eine Datensicherung mit drei Kopien der Daten, mindestens zwei Standorten und zwei unterschiedlichen Sicherungsmethoden. Zusätzlich muss die Kontrolle der Backups und Replikationen zuverlässig, automatisch und ohne Fehlerquote funktionieren.
Unsere Lösung kombiniert Proxmox Backup Server, ZFS-Replikation, Snapshots, Monitoring mit Checkmk und den Miyagi-Workflow. Dadurch entstehen sowohl klassische Backups mit langer Historie als auch startfähige ZFS-Replikate für schnelle Wiederherstellung im Notfall.
Backups bieten ein Wiederherstellungsversprechen.
ZFS-Replikate bieten eine sehr schnelle Wiederherstellungsmöglichkeit, weil replizierte Systeme auf geeigneter Hardware direkt gestartet werden können.
Was wir erreichen wollen
- Native Proxmox-Backups ohne Löschmöglichkeit von der Quelle
- Startfähige ZFS-Replikate auf einem zweiten System
- Lückenloses Monitoring aller Backups und Replikationen
- Serialisierte Sicherungen für bessere Performance
- Automatisierte Updates, Backupwartung und Verifizierung
- Automatisches Herunterfahren des Sicherungsservers nach Abschluss
- Zentrales Dashboard für Backupstatus, Replikation und Systemzustand
- Schnelle Wiederherstellung über Proxmox Backup Server oder ZFS-Replikate
Als Ergebnis entsteht eine Backuphistorie über mehrere Monate bis Jahre sowie ein ZFS-Replikat mit typischer Aufbewahrung von ca. 14 Tagen bis drei Monaten.
Beispiel auf dem Zielserver
# Auf dem Zielserver sollte das dann so aussehen
# Proxmox Backups mit Snapshot-Schutz gegen Kompromittierung
zfs list
rpool/pbsstore 4.9T 30.4T 4.62T /rpool/pbsstore
# PVE mit LXC Container
rpool/repl/lwpve2/rpool/data/subvol-100-disk-0 168G 34.8G 165G /rpool/repl/lwpve2/rpool/data/subvol-100-disk-0
rpool/repl/lwpve2/rpool/data/subvol-102-disk-0 918M 31.1G 872M /rpool/repl/lwpve2/rpool/data/subvol-102-disk-0
# PVE mit KVM
rpool/repl/lwpve3/rpool3/data/vm-301-disk-0 267K 41.0T 169K -
rpool/repl/lwpve3/rpool3/data/vm-301-disk-1 40.6G 41.0T 26.7G -
rpool/repl/lwpve3/rpool3/data/vm-301-disk-2 277G 41.0T 214G -
# ZVOLs finden sich unter /dev/zvol/rpool...Backups benötigen für eine Wiederherstellung den richtigen Zeitpunkt, genügend freien Platz und Zeit. ZFS-Replikate können dagegen auf ausreichend leistungsfähiger Hardware sehr schnell produktiv gestartet werden.
Die Aufbewahrungszeiten für Backups und Replikate können selbst festgelegt werden.
Überlegungen zu Proxmox VE, ZFS und Ceph
Proxmox VE ist eine leistungsfähige Virtualisierungsplattform auf Basis von KVM und LXC. Viele ältere VMware- und Hyper-V-Umgebungen können auf Proxmox VE migriert werden.
Der eigentliche Nutzen von Proxmox entsteht aber nicht nur durch die Weboberfläche, sondern durch die Kombination mit ZFS, Ceph, SDN, Snapshots, Replikation und dem Proxmox Backup Server.
Nutzt man Proxmox VE nur mit Hardware-RAID oder klassischem SAN, verliert man viele Vorteile, die Proxmox in Verbindung mit ZFS oder Ceph eigentlich bietet.
ZFS eignet sich besonders für kleinere und mittlere Installationen mit einem bis drei Proxmox-Servern. Hier können Systeme performant betrieben, regelmäßig snapshotiert und auf weitere Systeme repliziert werden.
Ceph kommt vor allem dann ins Spiel, wenn im Fehlerfall möglichst kein Datenverlust entstehen darf und ausreichend Budget, Netzwerkleistung und Know-how vorhanden sind. In der Praxis bedeutet Ceph häufig einen deutlich höheren Hardware- und Betriebsaufwand.
Mit ZFS erreicht man realistisch eine Sicherungslücke von unter fünf Minuten oder besser, wenn es notwendig ist. Nur weil bei einem Server das Licht ausgeht, sind die Daten noch lange nicht verloren.
Empfehlung für kleinere Umgebungen
- Ein bis drei Proxmox-Server bevorzugt mit ZFS betreiben
- ZFS-Snapshots regelmäßig automatisieren
- ZFS-Replikation auf ein zweites System einrichten
- Zusätzlich Proxmox Backup Server für längere Historie nutzen
- Monitoring für Backup, Replikation und ZFS-Zustand einrichten
Snapshots gegen Bedienfehler, Fahrlässigkeit und Ransomware
Vor Umstellungen, Updates oder riskanten Maßnahmen erstellt ein Administrator üblicherweise einen Snapshot. Bei VMware oder Hyper-V können zu viele oder zu lange bestehende Snapshots schnell zum Problem werden.
Hier spielt ZFS seine Stärke aus. ZFS-Snapshots sind sehr effizient und können regelmäßig erstellt werden, ohne den Betrieb in gleicher Weise zu belasten.
Durch die Arbeitsweise von ZFS sind permanente Snapshots im produktiven Betrieb ein großer Vorteil.
Empfohlene Snapshot-Strategie
Für automatische Snapshots eignen sich beispielsweise zfs-auto-snapshot oder CV4PVE als Web-GUI für Proxmox VE.
- 12 Snapshots alle 15 Minuten für schnelle Hilfe in den letzten drei Stunden
- 96 stündliche Snapshots für vier Tage
- 21 tägliche Snapshots für drei Wochen
- 6 wöchentliche Snapshots für sechs Wochen
- 3 monatliche Snapshots für unentdeckte Fehler
Für Aufbewahrungszeiten über drei Monate hinaus eignet sich zusätzlich die tägliche Sicherung mit dem Proxmox Backup Server.
Wichtig: Das System sollte nicht dauerhaft über 80 % belegt werden. Bei zu hoher Belegung müssen Aufbewahrungszeiten reduziert werden.
Proxmox Backup Server: Segen und Risiko
Der Proxmox Backup Server ist ein hervorragendes Sicherungswerkzeug für virtuelle Maschinen und Linux-Container auf Proxmox VE. Er bietet inkrementelle Backups, Deduplizierung, Verifizierung und effiziente Wiederherstellung.
Das Standarddesign sieht allerdings vor, dass Proxmox VE seine Sicherungen zum Proxmox Backup Server schiebt. Dadurch entsteht im Ernstfall Angriffsfläche, wenn Zugangsdaten oder Berechtigungen zu weit gefasst sind.
Der Backup-Benutzer sollte ausschließlich Sicherungs- und Wiederherstellungsrechte besitzen.
2FA, ein API-Token mit minimalen Rechten und deaktivierter SSH-Passwortlogin sind Pflicht.
Typische Probleme im Standardbetrieb
- Der Backupserver muss häufig dauerhaft laufen
- Automatisches Einschalten und Herunterfahren ist nicht vorgesehen
- Monitoring der Backups ist nicht komfortabel integriert
- Mailbenachrichtigungen reichen für professionelle Kontrolle oft nicht aus
- Ein zentrales Dashboard für Backup-, Replikations- und ZFS-Zustand fehlt
Der Miyagi-Workflow
Der Miyagi-Workflow kombiniert Proxmox Backup Server, ZFS-Replikation, Wartung, Updates, Verifizierung und Monitoring in einem Ablauf.
Das Ziel ist ein Backupserver an einem anderen Standort, der nur für den Sicherungslauf aktiv ist, die Sicherungen kontrolliert, Replikate erstellt und anschließend wieder herunterfährt.
Voraussetzungen
- Proxmox VE 8.4 oder neuer
- ZFS RAID10 empfohlen, RAIDZ möglich aber langsamer
- Optional zfs-auto-snapshot oder CV4PVE Snapshotmanager
- Separater Sicherungsserver mit möglichst viel Speicherplatz
- Empfohlen: HPE Microserver mit ECC und mehreren großen HDDs
- Proxmox Backup Server 3.4 oder neuer
- Installation idealerweise ebenfalls auf ZFS
- Bashclub Postinstaller für checkzfs und zsync auf beiden Systemen
- Optional Checkmk-Agent auf PVE und PBS
Bashclub Postinstaller:
https://github.com/bashclub/proxmox-zfs-postinstallProxmox Backup Server vorbereiten
SSH-Zugriff vorbereiten
- Auf dem PBS den Inhalt von
.ssh/id_rsa.pubkopieren - Den Key in Proxmox VE unter
.ssh/authorized_keysergänzen - Einmalig per SSH vom PBS zum PVE verbinden, um den Hostkey zu speichern
Wichtige Hinweise zur PBS-Konfiguration
Kein NFS als Datastore für Proxmox Backup Server verwenden.
Optional kann beim Booten ein iSCSI-LUN von Synology oder einem anderen System eingebunden werden, wenn keine lokalen Platten genutzt werden.
@reboot iscsiadm --mode node --targetname "iqn.2xxxx" --portal "10.ipsyn...:3260" --login && zpool import -f iscsiZFS-Pool und Dataset für PBS erstellen
Bei direkter Nutzung von Festplatten:
zpool create -f iscsi /dev/sdx -o autoexpand=on
zfs create iscsi/pbsstore -o recordsize=1M -o com.sun:auto-snapshot=falseBei nativ installiertem PBS:
zfs create rpool/pbsstore -o recordsize=1M -o com.sun:auto-snapshot=falseDie Festplatten sollten idealerweise über /dev/disk/by-id eingebunden werden.
Datastore im Proxmox Backup Server anlegen
- Bei iSCSI:
/iscsi/pbsstore - Bei nativer Installation:
/rpool/pbsstore - Purge, Garbage Collection und Verifyjobs zunächst deaktiviert anlegen
- Benutzer
backup@pbsmit starkem Passwort und 2FA anlegen - API-Key
backup@pbs!backupanlegen - Berechtigung Datastore Backup für Benutzer und API-Key setzen
Datastore in Proxmox VE einrichten
In Proxmox VE wird ein neuer Datastore vom Typ Proxmox Backup Server eingerichtet.
Danach sollte direkt aus einer VM oder einem LXC ein Testbackup ausgeführt werden.
Achtung: Proxmox VE setzt den Store
localstandardmäßig teilweise auf Typ Backup. Das sollte dringend deaktiviert werden.
Miyagi installieren
Die Installation erfolgt auf dem Proxmox Backup Server.
apt install git open-iscsi
git clone -b dev https://github.com/bashclub/miyagi-pbs-zfs.git
cd miyagi-pbs-zfs
cp config.example ipdeinespve.conf
nano ipdeinespve.confDas Miyagi-Script sichert einen Proxmox VE Host mit maximal zwei ZFS-Pools auf ein Ziel. Für weitere Hosts oder Pools werden einfach mehrere Konfigurationsdateien verwendet.
Beispielkonfiguration
SSHPORT='22'
BACKUPSERVER=yes
MAINTDAY=6
SHUTDOWN=yes
UPDATES=yes
SOURCEHOST='dein-pve-ip'
# ZFS-Replikation
ZFSROOT='rpool/data'
ZFSSECOND='rpool-hdd/data'
ZFSTRGT='rpool/repl'
ZPOOLSRC=rpool
ZPOOLDST=rpool
# ZSYNC für ZFS-Replikation
ZPUSHTAG=bashclub:zsync
ZPUSHMINKEEP=3
ZPUSHKEEP=14
ZPUSHLABEL=zsync
ZPUSHFILTER="daily,weekly,monthly"
# Backup
PBSHOST='ip-des-pbs'
BACKUPSTORE=backup
BACKUPSTOREPBS=backup
BACKUPEXCLUDE='99999'Wichtige Parameter
BACKUPSERVER=yes: Proxmox Backup ausführenMAINTDAY=6: Wartungstag, idealerweise SamstagSHUTDOWN=yes: Backupserver nach Abschluss herunterfahrenUPDATES=yes: Updates auf dem PBS ausführenZPUSHKEEP=14: Anzahl der aufzubewahrenden ReplikationsständeZPUSHFILTER: vorhandene Snapshots wie daily, weekly, monthly mitnehmenBACKUPEXCLUDE: auszuschließende VMs oder LXC, Komma-getrennt
Testlauf durchführen
/root/miyagi-pbs-zfs/pbs-zfs-daily.sh -c /root/miyagi-pbs-zfs/192.x.x.x.confDie Ausgabe sollte zuerst die ZFS-Replikation und anschließend das Proxmox-Backup anzeigen. Danach fährt der Server bei entsprechender Konfiguration herunter.
Kontrolle des Testlaufs
Proxmox Backup Server
- In Proxmox VE unter Cluster / Datastores den Backupstore wieder aktivieren
- In den VMs/LXCs oder im Store kontrollieren, ob Backups vorhanden sind
ZFS-Replikation auf dem PBS prüfen
checkzfs --sourceonlyAlternativ:
checkzfs --source ippve --filter rpool/data --threshold 1500,2000 --columns +messageZFS-Replikation auf dem PVE prüfen
cat /var/lib/check_mk_agent/spool/*Monitoring mit Checkmk
Ein zentraler Bestandteil des Workflows ist das Monitoring ohne Fehlerquote. Backups und Replikationen sollen nicht nur laufen, sondern zuverlässig überwacht werden.
Service Discovery auf Proxmox VE

Dieser Dienst zeigt den Status des letzten Backups.
Dieser Dienst zeigt alle Quelldatasets und Volumes. Wenn innerhalb eines Tages keine neuen Daten kommen, geht der Status auf Unknown.
Ausgeschalteten Miyagi-Server überwachen
Da der Sicherungsserver nach Abschluss herunterfahren kann, wird in Checkmk ein eigener Host angelegt.
- Host mit Namen nach Schema
miyagi-quelle-zielanlegen - Kein Agent und keine API notwendig
- Spezialprüfung für den letzten bekannten Backupstatus verwenden
Nach der Service Discovery erscheint der entsprechende Status.
Damit bleibt auch ein ausgeschalteter Backupserver kontrollierbar. Wenn innerhalb eines Tages keine neuen Daten eintreffen, geht der Status auf Unknown.
Warum dieser Ansatz trojanersicherer ist
Der zentrale Vorteil liegt in der Kombination mehrerer Schutzebenen:
- Snapshots schützen gegen Bedienfehler und schnelle Verschlüsselung
- ZFS-Replikate ermöglichen einen schnellen Start auf Ersatzhardware
- Proxmox Backup Server bietet lange Historie und Deduplizierung
- Der Backupserver muss nicht dauerhaft erreichbar sein
- API-Token und minimale Rechte reduzieren Angriffsflächen
- Checkmk überwacht Erfolg, Alter und Vollständigkeit der Sicherungen
Fazit
Mit Proxmox VE, ZFS, Proxmox Backup Server, Miyagi und Checkmk entsteht ein sehr robuster Backup- und Replikationsworkflow für kleine und mittlere Unternehmen.
Die Lösung kombiniert eine lange Backuphistorie mit schnell startfähigen Replikaten und einer zentralen Überwachung. Damit lassen sich Ausfälle, Bedienfehler und Ransomware-Schäden deutlich besser beherrschen.
Passende Schulungen
Wenn Sie diesen Workflow im Detail verstehen oder gemeinsam aufbauen möchten, passen besonders diese Kurse auf cloudistboese.de:
- Replikationen und Backups trojanersicher
- Proxmox produktiv mit ZFS betreiben
- ZFS Grundlagen
- IT Monitoring und Kontrolle mit Checkmk, Tactical RMM und Wazuh
Migration Univention Corporate Server & Kopano nach Zamba AD & Mailcow
Univention Corporate Server durch Zamba AD und Mailcow ersetzen
Migration von Univention UCS und Kopano zu Zamba Active Directory, Mailcow und Proxmox VE. Viele kleinere Unternehmen nutzen Univention Corporate Server hauptsächlich als Domain Controller und Benutzerverwaltung. Wenn UCS nur noch als Active Directory dient und Kopano ohnehin abgelöst werden soll, ist der Betrieb häufig unnötig aufwendig.
Mit Zamba Active Directory, Mailcow, Proxmox VE, optional Proxmox Mail Gateway und Mailpiler lässt sich eine schlanke, moderne Open-Source-Infrastruktur aufbauen, die schneller wartbar ist und sich ideal für kleine und mittlere Unternehmen eignet.
Updates von Mailcow und Zamba AD Controller laufen künftig in wenigen Minuten statt in mehreren Stunden.
Kunden, die Keycloak oder eine vollständig vom Hersteller supportete UCS-Umgebung benötigen, sollten weiterhin bei Univention bleiben.
Passende Kurse finden Sie auf cloudistboese.de unter den Themen Mailcow, Domain Controller ablösen und Alles ohne Windows.
Vorteile der Migration
- Univention UCS kann in kleinen Umgebungen ersetzt werden
- Active Directory bleibt mit Samba/Zamba erhalten
- Mailcow ersetzt Kopano als moderne Groupware
- Updates werden deutlich einfacher und schneller
- Proxmox VE ermöglicht Snapshots, Backups und einfache Wiederherstellung
- LDAP-Anbindung für Mailcow, Mailpiler und weitere Dienste bleibt möglich
- Die Umgebung wird schlanker, transparenter und besser wartbar
Systemvoraussetzungen
- Bestehender Univention Corporate Server im AD-Modus
- Kopano oder vergleichbare Groupware mit IMAP-Zugriff
- Proxmox VE 8.x oder neuer
- Linux Container mit installiertem Git
- Grundkenntnisse in DNS, Active Directory, Mailservern und Proxmox VE
Übersicht der Migration
- Zamba Active Directory als zweiten Domain Controller installieren
- Active Directory replizieren und prüfen
- DNS auf den neuen Domain Controller umstellen
- Mailcow installieren
- LDAP-Anbindung in Mailcow konfigurieren
- Benutzer und Mailboxen synchronisieren
- Mails von Kopano nach Mailcow migrieren
- Kalender und Kontakte übernehmen
- Aliase und Weiterleitungen prüfen
- Mailcow produktiv schalten
- FSMO-Rollen übernehmen
- Univention UCS demoten und abschalten
- LDAP-Clients auf den neuen Zamba AD umstellen
Zamba Active Directory als zweiten Domain Controller installieren
Die Installation erfolgt auf dem Proxmox Host, zum Beispiel im Verzeichnis /root.
git clone -b dev https://github.com/bashclub/zamba-lxc-toolbox
cd zamba-lxc-toolbox
cp conf/zamba.conf.example conf/zamba.confzamba.conf anpassen
In der Datei conf/zamba.conf werden die Werte an die bestehende Umgebung angepasst.
LXC_TEMPLATE_STORAGE="local"
LXC_ROOTFS_SIZE="32"
LXC_ROOTFS_STORAGE="rpool-data"
LXC_SHAREFS_SIZE="100"
LXC_SHAREFS_STORAGE="rpool-data"
LXC_HOSTNAME="zmb-ad"
LXC_DOMAIN="windomain.local"
LXC_IP="10.0.0.254/24"
LXC_GW="10.0.0.1"
LXC_DNS="10.0.0.4"
LXC_BRIDGE="vmbr0"
LXC_PWD='Admin123'
ZMB_REALM="WINDOMAIN.LOCAL"
ZMB_DOMAIN="WINDOMAIN"
ZMB_ADMIN_USER="administrator"
ZMB_ADMIN_PASS='Admin123'Hinweis: LXC_DNS zeigt zunächst auf den alten UCS-DNS-Server. Bei Windows-Domänen sollte vorher gegebenenfalls das Funktionslevel geprüft werden.
Zamba AD Join starten
bash install.sh -i 100Im Menü wird Zamba-AD-Join gewählt.
Replikation prüfen
Nach der Installation kann der Container betreten und die Replikation geprüft werden.
pct enter 100
su -
wbinfo -u
wbinfo -gWenn alle Benutzer und Gruppen angezeigt werden, ist der Join grundsätzlich erfolgreich.
Empfehlung: In Proxmox sollte anschließend der alte UCS-DNS-Server aus der Hostkonfiguration entfernt werden, sobald der neue Zamba AD DNS zuverlässig funktioniert.
smb.conf anpassen
Folgende Anpassungen können in der smb.conf hilfreich sein:
vi /etc/samba/smb.conf[global]
ldap server require strong auth = no
dns forwarder = 1.1.1.1 1.0.0.1DNS auf den neuen Domain Controller umstellen
DNS ist bei Active Directory fast immer der kritischste Punkt. Sobald der neue Zamba Domain Controller sauber repliziert, werden feste IP-Konfigurationen und DHCP-Einstellungen angepasst.
- Alle Server mit statischer IP erhalten den neuen Zamba AD als DNS-Server
- Im DHCP-Server wird der alte UCS-DNS durch den neuen DC ersetzt
- Alte UCS-DNS-Einträge werden später bereinigt
- RSAT DNS-Konsole zur Kontrolle verwenden
Merksatz: It was DNS.
Mailcow installieren
Für Mailcow wird ein weiterer LXC verwendet. Die Installation erfolgt ebenfalls über die Zamba LXC Toolbox.
cp conf/zamba.conf.example conf/zamba.confFür Mailcow müssen insbesondere Hostname und Netzwerkeinstellungen angepasst werden.
bash install.sh -i 101Im Menü wird Mailcow gewählt.
Mailcow aktualisieren
pct enter 101
su -
cd /opt/mailcow-dockerized
apt install jq
./update.shDanach wird das Mailcow-Webinterface geöffnet:
https://10.0.0.253/adminGrundkonfiguration von Mailcow
Unbedingt notwendige Schritte
- Admin-Passwort ändern: System / Konfiguration / Administrator bearbeiten
- Alle Maildomains eintragen: E-Mail / Konfiguration / Domains
- Schwellwerte und Quotas beachten
- LDAP-Bind-User im AD anlegen: zum Beispiel
bind-mailcow
LDAP in Mailcow konfigurieren
Die LDAP-Anbindung erfolgt unter:
System / Konfiguration / Zugang / Identity Provider
- Identity Provider: LDAP
- Host: IP des neuen Zamba AD
- Port: 636
- Benutze SSL: an
- Ignoriere SSL Fehler: an
- Base DN:
CN=Users,DC=windomain,DC=local - Username Feld:
mail - Attribute Feld:
mail - Bind DN:
CN=bind-mailcow,CN=Users,DC=windomain,DC=local - Bind Passwort: Passwort des Bind-Users
- Attribute Mapping: Standardvorlage / Default
- Benutzer beim Login erstellen: an
- Vollsynchronisation: an
- Importiere Benutzer: an
- Sync / Import interval: für den Anfang 1 Minute
Der Erfolg wird unter E-Mail / Mailboxen kontrolliert.
E-Mails von Kopano nach Mailcow migrieren
Die Migration erfolgt über IMAP-Synchronisation.
Mailcow Sync Job erstellen
In Mailcow:
E-Mail / Synchronisationen / Neuen Sync Job erstellen
- Host: IP des Kopano-Servers
- Port: 993
- Benutzername: Windows-Loginname
- Elemente ausschließen: Regex-Inhalt entfernen, da zu gefährlich
--delete2duplicatesnur verwenden, solange Mails noch auf Kopano laufen
Kopano hat standardmäßig IMAP teilweise deaktiviert. In der
server.confnachdisablesuchen oder in UMC beim Benutzer unter Kopano IMAP aktivieren.
Der Erfolg der Synchronisation sollte im Dialog und in den Logs kontrolliert werden.
Kalender aus Kopano exportieren
Kopano stellt Kalender über CalDAV bereit. Beispiele:
http://kopano:8080/caldav/<user>/<folder-name>/ |
Kalender oder Aufgabenordner im Benutzerpostfach |
http://kopano:8080/caldav/<user>/<sub-folder>/ |
Selbst erstellter Unterkalender |
http://kopano:8080/caldav/<other-user>/<folder-name>/ |
Freigegebener Kalender eines anderen Benutzers |
http://kopano:8080/caldav/public/<foldername>/ |
Öffentlicher Kalender |
http://kopano:8080/caldav/<user>/ |
Standardkalender des Benutzers |
Die exportierten Dateien können anschließend im SOGo-Frontend oder in einem Mailclient importiert werden.
Kontakte exportieren und importieren
Kontakte exportieren
Der Export kann über den alten Mailclient erfolgen. Alternativ kann ein Python-Script mit Kopano-MAPI genutzt werden.
sudo apt install python3-kopano
mkdir export
wget https://raw.githubusercontent.com/bashclub/trmm-scripts/refs/heads/main/kopano-export-contacts.py
python3 kopano-export-contacts.pyDas Script exportiert Kontakte in Unterordner pro Benutzer, da Kopano kein echtes CardDAV für diesen Zweck bereitstellt.
Kontakte importieren
- Outlook kann beim Export oder Import Probleme verursachen
- SOGo importiert Kontakte oft nur einzeln
- eM Client war in der Praxis häufig die beste Lösung für den Import vieler VCF-Dateien per Drag & Drop
Beispiel für CardDAV-Anbindung:
https://kunde.dyndns.org/SOGo/dav/user@domain.de/Contacts/personal/Aliase und Weiterleitungen übernehmen
Aliase finden
univention-ldapsearch -LLL | grep @ | grep mailAlternativeAliase werden in Mailcow unter E-Mail / Aliasse / Alias hinzufügen eingetragen.
Weiterleitungen finden
univention-ldapsearch -LLL | grep mailForwardWeiterleitungen werden im SOGo-Webfrontend unter E-Mail konfiguriert, nicht direkt in Mailcow.
Mailcow produktiv schalten
NAT und Portweiterleitungen
Auf der Firewall, zum Beispiel OPNsense, können Aliase verwendet werden.
p_mailcow: 80 443 465 993 4190
h_mailcow: 10.0.0.253Port Forwarding:
any > WAN IP > p_mailcow > h_mailcowMailcow neu starten
pct enter 101
su -
rm /opt/mailcow-dockerized/data/conf/nginx/redirect.conf
cd /opt/mailcow-dockerized
docker compose downOptional: Greylisting deaktivieren
vi /opt/mailcow-dockerized/data/conf/rspamd/local.d/greylist.confenabled = false;Optional: Let’s Encrypt Einstellungen
vi /opt/mailcow-dockerized/mailcow.confSKIP_LETS_ENCRYPT=n
SKIP_HTTP_VERIFICATION=ydocker compose up -dLet’s Encrypt kontrollieren
docker compose logs --tail=200 -f acme-mailcowAlternativ eigenes Zertifikat verwenden
Eigene Zertifikate können hier abgelegt werden:
/opt/mailcow-dockerized/data/assets/sslcert.pemkey.pem
Danach DNS-Werte beim Provider kontrollieren:
E-Mail / Domains / DNS
Abschluss der Migration
- Synchronisationen nach erfolgreicher Migration deaktivieren
- Optional Proxmox Mail Gateway auf Mailcow verweisen
- Alten Univention Corporate Server abschalten
- FSMO-Rollen auf Zamba AD übertragen
- Alte UCS-Fragmente bereinigen
- LDAP-Clients auf neuen Zamba AD umstellen
FSMO-Rollen übernehmen
pct enter 100
su -
samba-tool fsmo transfer --role=all -Uadministrator
samba-tool domain demote --remove-other-dead-server=UCS
rm /etc/cron.d/sysvol-syncBereinigung
- RSAT DNS-Konsole nach alten Fragmenten durchsuchen
- Alte DNS-Einträge entfernen
- Optional Metadata Cleanup durchführen
LDAP-Clients anpassen
Für bestehende LDAP-Clients werden neue Bind-User pro Rolle angelegt. Anschließend werden die LDAP-Parameter angepasst.
- IP: neuer Zamba AD
- Port: von 7389 auf 636 mit SSL ändern
- UID auf
sAMAccountNameändern - Bind DN von
uidaufcnändern
Proxmox Mail Gateway mit Mailcow verbinden
Greylisting in Mailcow deaktivieren
vi /opt/mailcow-dockerized/data/conf/rspamd/local.d/greylist.confenabled = false;docker compose restart rspamd-mailcowRouting in Mailcow
- Konfiguration / Routing / Networks
ipvompmg:26- Greylisting deaktivieren
Senderabhängige Transport Maps
- Für alle Maildomains, die PMG nutzen
- ID 1:
ipvompmg:26
Proxmox Mail Gateway
- Configuration / Mail Proxy
- Relay Domain setzen
- Transport zur Mailcow konfigurieren
- Kein MX für internen Transport verwenden
Beim DNS-Provider werden die PMG-Werte statt der direkten Mailcow-Werte gesetzt.
Mailpiler als Mailarchiv integrieren
Mailpiler kann ebenfalls über die LXC Toolbox installiert werden.
Mailcow für Archivweiterleitung vorbereiten
- System / Konfiguration / Einstellungen / Weiterleitungs-Hosts
- IP des Mailpilers eintragen
BCC an das Archiv
- System / Konfiguration / Routing / Transport
- Ziel:
piler.windomain.local - Next Hop:
10.0.0.x
BCC-Maps einrichten
Unter:
E-Mail / Konfiguration / Adressumschreibung / BCC-Maps
Für jede Maildomain jeweils eingehend und ausgehend:
- Lokales Ziel:
sysops.tv - BCC-Ziel:
piler@piler.windomain.local - Domain:
sysops.tv
Kontrolle im Mailpiler:
tail -f /var/log/mail.logEine LDAP-Anpassung im Mailpiler wäre in
config-site.phpmöglich, funktioniert jedoch nicht zuverlässig für Aliase.
Doppelte Mails bei mehrfacher Kopano-Synchronisation vermeiden
Die IMAP-Kompatibilität von Kopano ist in der Praxis oft problematisch. Wenn Mails doppelt oder dreifach erscheinen, kann eine gezielte Bereinigung und erneute Synchronisation helfen.
apt install kopano-migration-imap
nano migrate.sh#!/bin/bash
set -euo pipefail
if [ "$#" -ne 6 ]; then
echo "Verwendung:"
echo "$0 <host1> <host2> <user1> <pass1> <user2> <pass2>"
exit 1
fi
HOST1="$1"
HOST2="$2"
USER1="$3"
PASS1="$4"
USER2="$5"
PASS2="$6"
MAILCOW_DOVECOT_CONTAINER="565cef8dac49"
echo "=========================================="
echo "Bereinige Zielordner auf Mailcow"
echo "=========================================="
docker exec "$MAILCOW_DOVECOT_CONTAINER" \
doveadm expunge -u "$USER2" mailbox "Gesendet" ALL || true
docker exec "$MAILCOW_DOVECOT_CONTAINER" \
doveadm mailbox delete -u "$USER2" "Sent" || true
docker exec "$MAILCOW_DOVECOT_CONTAINER" \
doveadm mailbox delete -u "$USER2" "Gesendete Objekte" || true
docker exec "$MAILCOW_DOVECOT_CONTAINER" \
doveadm mailbox delete -u "$USER2" "Gesendete Objekte/Gesendete Objekte" || true
echo "=========================================="
echo "Starte IMAP Sync"
echo "=========================================="
kopano-migration-imap \
--host1 "$HOST1" \
--host2 "$HOST2" \
--user1 "$USER1" \
--password1 "$PASS1" \
--user2 "$USER2" \
--password2 "$PASS2" \
--ssl1 \
--ssl2 \
--regextrans2 's#^Gel&APY-schte Objekte$#Papierkorb#' \
--useheader Message-Id \
--addheader \
--usecache \
--syncinternaldates \
--skipsize \
--nofoldersizes \
--nofoldersizesatend \
--delete2 \
--delete2folders \
--delete2duplicates \
--exclude '(?i)^trash$|^junk$|^spam$|^unwanted$|^&U3CPbg-($|/)'
echo "=========================================="
echo "Migration abgeschlossen"
echo "=========================================="Ausführen mit:
bash migrate.sh quellip zielip login passwortucs email@adresse.de passwortmailcowDas Beispiel nimmt keine Papierkörbe oder Spam-Ordner mit. Dies wird über
--excludegesteuert.
Optionale DNS-Einträge für Autokonfiguration
Für Thunderbird, eM Client und weitere Programme können SRV-Records gesetzt werden, damit Mail, Kalender und Kontakte automatisch gefunden werden.
_autodiscover._tcp IN SRV 0 0 443 q.deine-domain.de.
_caldavs._tcp IN SRV 0 1 443 q.deine-domain.de.
_carddavs._tcp IN SRV 0 1 443 q.deine-domain.de.
_imaps._tcp IN SRV 0 1 993 q.deine-domain.de.
_matrix._tcp IN SRV 0 1 465 matrix.deine-domain.de.
_sieve._tcp IN SRV 0 1 4190 mail.deine-domain.de.
_smtps._tcp IN SRV 0 1 465 q.deine-domain.de.
_submissions._tcp IN SRV 0 1 465 q.deine-domain.de.Fazit
Mit Zamba Active Directory, Mailcow und Proxmox VE lässt sich eine bestehende Univention-/Kopano-Umgebung vollständig durch moderne Open-Source-Komponenten ersetzen. Für kleine und mittlere Unternehmen entsteht eine schlanke, wartbare und zukunftssichere Infrastruktur.
- Active Directory bleibt erhalten
- Kopano wird durch Mailcow ersetzt
- Updates werden deutlich schneller
- Proxmox VE ermöglicht einfache Snapshots und Backups
- Mailpiler und Proxmox Mail Gateway können integriert werden
- Der Betrieb wird transparenter und besser kontrollierbar
Passende Schulungen
Wenn Sie die Migration unter Anleitung durchführen möchten, finden Sie passende Live-Schulungen auf cloudistboese.de:
- Windows Domain Controller mit Samba/Zamba ablösen
- Open-Source Mailserver mit Mailcow betreiben
- Alles ohne Windows
- Proxmox produktiv mit ZFS betreiben
- Replikationen und Backups trojanersicher
Proxmox Best Practice Setup für ZFS und / oder Ceph im Cluster für Einsteiger (Stand Dezember 2024)
Proxmox Cluster mit ZFS und Ceph – Best Practices für Einsteiger
Praxiswissen aus rund 150 Proxmox- und ZFS-Systemen
Der Verfasser dieses Artikels, Christian-Peter Zengel, verfügt über rund 15 Jahre Praxiserfahrung mit Proxmox VE und ZFS und betreibt aktuell etwa 150 Systeme mit Proxmox und ZFS.
Die Erfahrungen reichen von Standalone-Installationen bis hin zu Proxmox-Clustern mit bis zu zehn Hosts. Der Schwerpunkt liegt klar auf ZFS, Replikation, Backup, Monitoring und praxistauglicher Hochverfügbarkeit.
Hinweis: Dieser Artikel versteht sich nicht als Ceph-Expertenleitfaden. Ceph wird hier vor allem zum Funktionsvergleich und als Einstieg behandelt. Für viele kleine und mittlere Installationen bis etwa zehn Hosts ist ZFS mit Replikation in unserer Praxis häufig die einfachere, günstigere und besser beherrschbare Lösung.
Proxmox Best Practice Kurs mit ZFS und Ceph
Diese Dokumentation basiert auf einem Onlinekurs von cloudistboese.de.
Proxmox Best Practice Cluster mit ZFS und Ceph für Einsteiger
Der Kurs vermittelt einen schnellen, praxisnahen Einstieg in den Aufbau eines Proxmox-Clusters mit ZFS, einfacher Ceph-Grundlage, Backup, Snapshots, Monitoring und Hochverfügbarkeit.
Aktuelle Kurse und Wiederholungen auf cloudistboese.de ansehen
Für wen eignet sich diese Anleitung?
Der folgende Artikel richtet sich besonders an Einsteiger, Administratoren und IT-Dienstleister, die mit mehr als einem Proxmox-Host starten möchten und eine robuste, nachvollziehbare Cluster-Grundlage suchen.
- Proxmox VE mit ZFS installieren
- Proxmox Cluster mit mehreren Nodes aufbauen
- ZFS-Replikation verstehen und kontrollieren
- VMs und LXCs performant anlegen
- einfache Ceph-Grundlagen kennenlernen
- Proxmox Backup Server integrieren
- Snapshots, Replikation und Monitoring verbessern
- Hochverfügbarkeit sinnvoll einordnen
Nach diesem Kurs können Sie einen kleinen Proxmox-Cluster sicherer planen, installieren und betreiben.
ZFS oder Ceph im Proxmox Cluster?
ZFS ist für kleine und mittlere Proxmox-Installationen eine sehr starke Grundlage. Durch Prüfsummen, Snapshots, Replikation und einfache Wiederherstellung schützt ZFS zuverlässig vor vielen typischen Problemen wie defekten Datenträgern, versehentlichen Änderungen und manchen Folgen von Ransomware-Angriffen.
ZFS ersetzt jedoch kein Backup. Gegen kompromittierte Root-Zugänge, Brand, Diebstahl, vollständigen Standortausfall oder absichtlich gelöschte Snapshots hilft nur ein sauberes Backup- und Replikationskonzept.
Ceph bietet echten verteilten Storage und hohe Skalierbarkeit, benötigt aber deutlich mehr Hardware, Netzwerkplanung und Betriebserfahrung. Für viele Umgebungen bis etwa zehn Hosts ist ZFS mit Replikation oft wirtschaftlicher und einfacher zu betreiben.
Installation von Proxmox VE auf ZFS
Für den Workshop wird ein HPE Microserver Gen10 Plus V2 verwendet. Empfehlenswert ist eine Ausstattung mit ECC-RAM und direkt ansprechbaren Datenträgern.
HPE Microserver Gen10 Plus V2 ansehen
Wir installieren Proxmox VE bevorzugt auf ZFS Mirror, RAID10 oder RAIDZ. Hardware-RAID-Controller sollten für ZFS vermieden werden. Empfehlenswert sind Controller im HBA- oder IT-Mode, damit ZFS direkten Zugriff auf die Datenträger erhält.
Für Cluster sollten Hostnamen, IP-Adressen, Netzwerke und DNS-Einträge vor der Installation sauber geplant werden. Nachträgliche Änderungen verursachen häufig unnötige Zusatzarbeit.
Proxmox Cluster mit drei Nodes erstellen
Ein Proxmox-Cluster kann sehr schnell erzeugt werden. Auch ein einzelner Node kann zunächst problemlos allein laufen. Für echte Cluster-Funktionen und Quorum sollten jedoch mindestens drei Nodes oder ein sinnvoller QDevice-Aufbau geplant werden.
Weitere Proxmox Nodes hinzufügen
Weitere Nodes werden über die Join-Informationen des ersten Cluster-Nodes hinzugefügt. Auf dem neuen Node werden die Informationen unter Join Cluster eingefügt. Zusätzlich werden Root-Passwort und Cluster-Netzwerk angegeben.

Während des Cluster-Beitritts kann der neue Node kurzzeitig die Verbindung zum Browser verlieren, da Schlüssel und Zertifikate des Clusters übernommen werden. Danach sollte die Weboberfläche neu geladen werden.
Postinstaller für Proxmox VE
Unser Proxmox ZFS Postinstaller vom Bashclub hilft bei vielen wiederkehrenden Aufgaben nach der Installation.
Für Cluster-Setups sollten die Optionen bewusst gewählt werden. Im Workshop verzichten wir beispielsweise auf Autosnapshots für rpool/data und auf SSH-Hardening, soweit dies aus Kompatibilitätsgründen sinnvoll ist.
ZFS RAID demonstrieren und überwachen
ZFS-Software-RAID lässt sich im Fehlerfall sehr schnell analysieren und wiederherstellen. Der direkte Zugriff auf die Datenträger ermöglicht ein gutes Monitoring und kann Probleme frühzeitig sichtbar machen.
Im Workshop wird beispielhaft eine Platte vor einem Reboot offline gesetzt. Das ist eine Demonstration und sollte auf produktiven Systemen nicht unüberlegt nachgestellt werden.
Das Proxmox-Dashboard zeigt nicht alle Storage-Probleme so deutlich, wie es für den produktiven Betrieb wünschenswert wäre. Für professionelle Umgebungen empfehlen wir zusätzliches Monitoring, zum Beispiel mit Checkmk oder CV4PVE.
VMs und LXCs unter Proxmox richtig anlegen
Für moderne virtuelle Maschinen sollten heute in der Regel q35 und OVMF/UEFI verwendet werden. Ältere Einstellungen wie i440FX und klassisches BIOS sind für neue Systeme meist nicht mehr empfehlenswert.
- VirtIO SCSI Single: gute Performance und eigener Prozess pro Disk
- QEMU Guest Agent: wichtig für Shutdown, Freeze, IP-Erkennung und Backups
- Discard und SSD Emulation: bessere Rückgabe gelöschter Blöcke an den Host
- IO Thread: bessere Entkopplung von I/O-Last
- CPU Typ Host: ideal bei identischer Hardware, vorsichtig bei gemischten CPUs im Cluster
- Ballooning: ermöglicht dynamischere RAM-Nutzung, benötigt aber passende Treiber

ZFS-Replikation in Proxmox VE
Die eingebaute ZFS-Replikation von Proxmox VE ist für viele kleine und mittlere Cluster eine sehr gute Grundlage. Bei vorhandener Replikation liegt der größte Teil der VM bereits auf dem Zielsystem und muss nur inkrementell ergänzt werden.
Ohne vorherige Replikation muss die komplette VM oder der komplette Container übertragen werden. Je nach Zustand erfolgt die Übertragung über KVM-Mechanismen oder ZFS. Dabei kann es Unterschiede beim Erhalt von Snapshots geben.
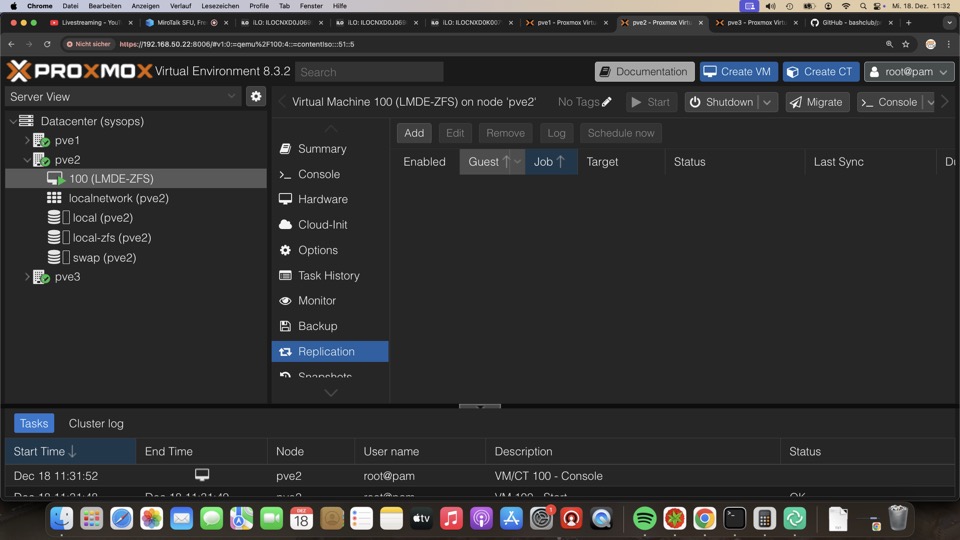
Replikationsintervalle von 15 bis 60 Minuten sind für viele Umgebungen ein guter Kompromiss. Eine Minute ist technisch möglich, sollte aber nicht pauschal für jede VM verwendet werden.
Ceph-Grundlagen im Proxmox Cluster
Ceph ermöglicht verteilten Storage innerhalb eines Proxmox-Clusters. Dadurch können VMs auf gemeinsamem Storage liegen und bei passender Architektur sehr flexibel zwischen Nodes betrieben werden.
Ceph benötigt jedoch sorgfältige Planung, geeignete Netzwerke, passende Hardware und ausreichende Redundanz.
Für produktive Ceph-Cluster empfehlen wir mindestens eine Proxmox-Subscription und erfahrene Planung. Ein fehlerhaft aufgebauter Ceph-Cluster kann selbst zum kritischen Ausfallrisiko werden.

Die Auswahl der Netzwerke für Cluster, Ceph, Redundanz und weitere Segmentierungen sollte durch erfahrene Fachleute erfolgen. Für produktive Ceph-Umgebungen sollte das normale LAN nicht einfach mitverwendet werden.
Ceph OSDs und Pools einrichten
Jeder Host benötigt geeignete Datenträger als OSDs. Für ein einfaches Testsetup reichen drei OSDs, produktiv sollte Ceph jedoch deutlich sorgfältiger und redundant geplant werden.
Hardware-RAID-Controller sollten auch für Ceph nicht verwendet werden. Ceph benötigt direkten Zugriff auf die Datenträger.
Monitor- und Manager-Rollen sollten auf mehrere Nodes verteilt werden. Andernfalls kann bereits ein Reboot eines einzelnen Nodes zu Problemen führen.
Migration zwischen Nodes
Die Migration laufender VMs oder gestoppter LXCs ist sowohl mit ZFS als auch mit Ceph möglich. Der wesentliche Unterschied liegt im Storage-Konzept.
- Ceph: Speicher liegt verteilt im Cluster
- ZFS: Speicher muss auf dem Zielhost vorhanden sein oder übertragen werden
- ZFS mit Replikation: nur die Änderungen müssen ergänzt werden
- ZFS ohne Replikation: vollständige Übertragung notwendig
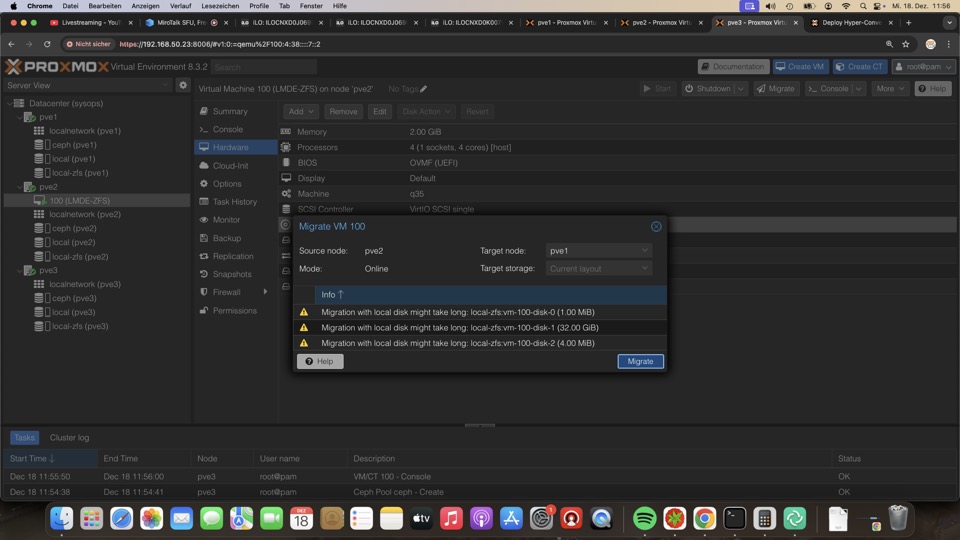
QEMU Guest Agent installieren
Der QEMU Guest Agent sollte in virtuellen Maschinen immer installiert und aktiviert werden. Er ermöglicht geordnetes Herunterfahren, bessere Backup-Konsistenz, IP-Erkennung und weitere Verwaltungsfunktionen.
Proxmox Sicherheit: 2FA, SSH und Netzwerksegmentierung
Zwei-Faktor-Authentifizierung aktivieren
Root- und Proxmox-Benutzer sollten mit Zwei-Faktor-Authentifizierung abgesichert werden.
SSH gegen Passwort-Login absichern
SSH-Zugänge sollten nach Möglichkeit nur mit Schlüsseln und ohne Passwort-Login betrieben werden.
Verwaltungsnetz trennen
Wenn die Ressourcen vorhanden sind, sollten Anwender- und Gast-VMs keinen direkten Zugriff auf Proxmox VE, Switches oder Firewalls erhalten.
Replikationen zuverlässig prüfen
Ein Blick auf ZFS allein zeigt nicht zuverlässig, welche VM gerade auf welchem Host aktiv ist. Deshalb müssen Replikationen kontrolliert und nachvollziehbar überwacht werden.
Das Proxmox Dashboard zeigt defekte Platten, RAID-Probleme und Replikationsfehler nicht immer so zentral, wie es für größere Umgebungen wünschenswert wäre. Deshalb sollten Checkmk, CV4PVE oder eigene Prüfwerkzeuge eingesetzt werden.
Proxmox Konfiguration sichern
Die Proxmox-Konfiguration liegt in einer Cluster-Datenbank und wird unter /etc/pve eingebunden. Unser Postinstaller kann diese Konfiguration regelmäßig nach /rpool/pveconf sichern und mit ZFS-Autosnapshots historisieren.
Hochverfügbarkeit mit Proxmox HA
Die Proxmox HA-Engine sorgt dafür, dass VMs oder LXCs beim Ausfall eines Hosts auf einem anderen Host gestartet werden können.
Wichtig ist die Unterscheidung:
- Ceph oder SAN: Storage ist gemeinsam verfügbar
- ZFS-Replikation: es kann die Replikationslücke verloren gehen
- HA mit ZFS: gut für Dienste mit tolerierbarem Datenverlustfenster
Bei ZFS hängt das mögliche Datenverlustfenster vom Replikationsintervall ab. Daher eignet sich HA mit ZFS besonders für Systeme wie Firewalls, Telefonanlagen oder Dienste, bei denen ein kurzer Rückstand vertretbar ist.

Wird ein Node regulär neu gestartet, sollten VMs vorher bewusst migriert werden. Ein Reboot ersetzt keine geplante Wartung.
Snapshots manuell und automatisch nutzen
Manuelle Snapshots über die Proxmox GUI oder API werden abhängig vom darunterliegenden Storage erzeugt – beispielsweise auf ZFS, Ceph oder anderen Storage-Backends.
Bei ZFS werden Snapshot-Zustände mitrepliziert und in der VM-Konfiguration sichtbar.
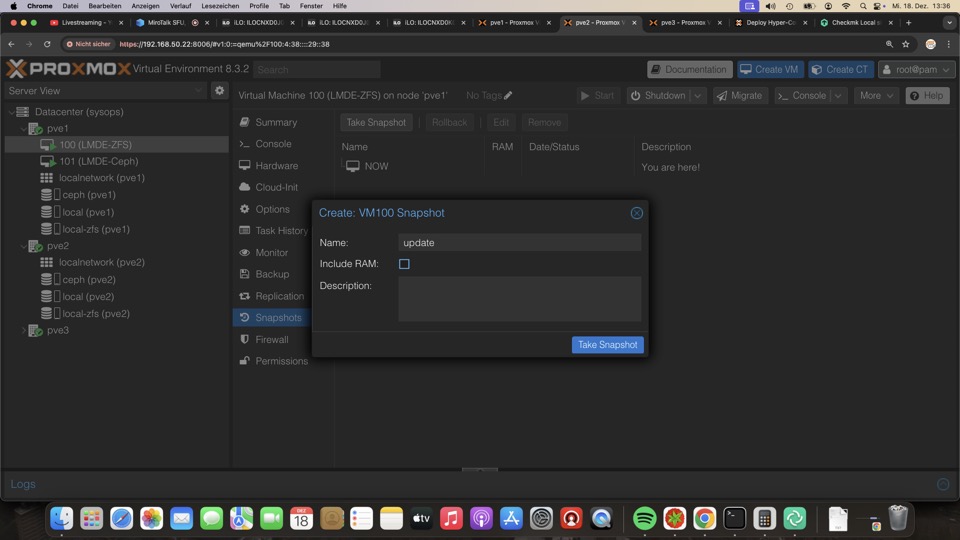
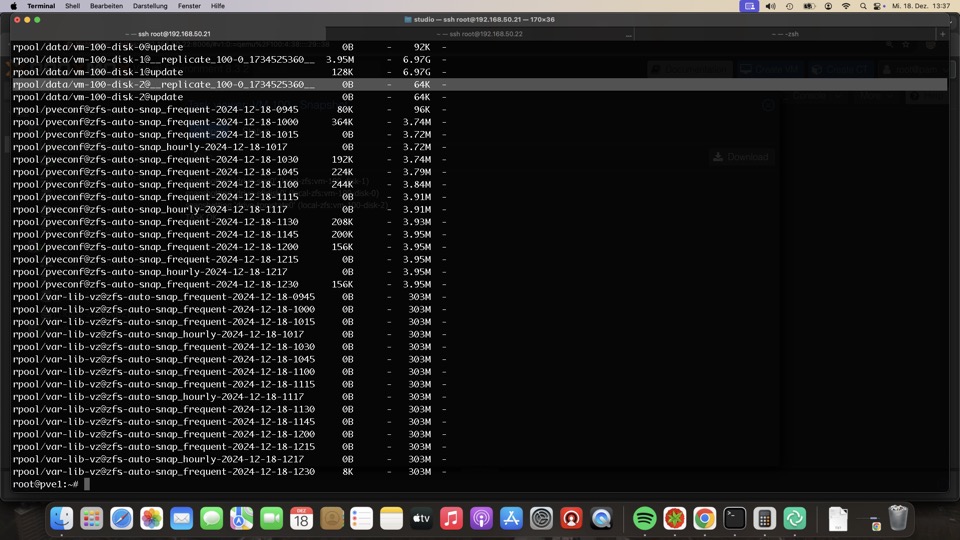
CV4PVE-Admin für Snapshots, Monitoring und Replikationen
CV4PVE-Admin kann eine sinnvolle Ergänzung zu Proxmox VE sein. Es bietet bessere Übersicht über Replikationen, Snapshots und bestimmte Monitoring-Funktionen.
Automatische Snapshots können dort definiert werden. Wichtig ist, dass das System zuverlässig läuft und überwacht wird.
Proxmox Backup Server einrichten
Proxmox VE kann klassische Backups erstellen. Der Proxmox Backup Server ergänzt inkrementelle, deduplizierte Backups, zentrale Verwaltung, Verify Jobs, Prune Jobs und Garbage Collection.
PBS kann auf eigener Hardware, in einer VM oder in bestimmten Szenarien auch als LXC betrieben werden. Für produktive Backups ist ein dediziertes, abgesichertes System vorzuziehen.
Für den Datastore empfehlen sich lokale Dateisysteme oder geeignete Storage-Anbindungen. SMB verursacht in vielen Umgebungen zusätzlichen Overhead und ist für PBS meist nicht die beste Wahl.
Backup-Benutzer, Token und Rechte
Für Backups sollte ein eigener Backup-Benutzer mit Token verwendet werden. Root-Zugänge und Backup-Zugänge sollten mit Zwei-Faktor-Authentifizierung abgesichert werden.
Der Benutzer oder Token benötigt die Berechtigung Datastore Backup.
Proxmox Backup Server in Proxmox VE einbinden
Für die Einbindung des Proxmox Backup Servers in Proxmox VE werden mehrere Angaben benötigt:
- Name des Datastores in Proxmox VE
- Serveradresse des PBS
- Datastore-Name im PBS
- Benutzer oder Token
- Token Secret
- Fingerprint des PBS-Zertifikats
Das lokale Bootvolume von Proxmox VE sollte nicht als Backup-Ziel verwendet werden.
Backups, Prune, Garbage Collection und Verify
Das erste Backup einer VM ist in der Regel ein vollständiger Durchlauf. Danach werden mit Dirty Bitmap und Deduplizierung nur noch geänderte Daten effizient übertragen und gespeichert.
Nach einem Stop der VM oder Reboot des Hosts kann wieder ein vollständiger Scan notwendig werden. Durch Chunk-Deduplizierung werden jedoch nur neue oder geänderte Chunks gespeichert.
Prune Jobs
Prune Jobs definieren Aufbewahrungszeiten. Der Proxmox-Simulator hilft bei der Prüfung der Regeln.
Garbage Collection
Die Garbage Collection räumt nicht mehr benötigte Chunks auf. Dieser Vorgang kann Last erzeugen und sollte sinnvoll geplant werden.
Verify Jobs
Verify Jobs prüfen regelmäßig die Integrität der Backups. Der Erfolg wird sowohl im PBS als auch in Proxmox VE angezeigt.
Optional: Replikationskontrolle mit checkzfs
Mit checkzfs vom Bashclub können ZFS-Replikationen zusätzlich kontrolliert werden. Da nicht immer sofort erkennbar ist, welcher Host welche VM aktiv betreibt, kann ein Vergleich der Datastores hilfreich sein.
Der Check sollte nicht während laufender Replikationen ausgeführt werden, da dies zu Fehlmeldungen führen kann.
Fazit: Proxmox Cluster mit ZFS bewusst planen
Für viele kleine und mittlere Umgebungen ist ein Proxmox-Cluster mit ZFS, Replikation, Proxmox Backup Server und gutem Monitoring eine sehr leistungsfähige und wirtschaftliche Lösung.
Ceph ist besonders interessant, wenn echter verteilter Storage, hohe Skalierung und passende Hardware vorhanden sind. Für kleinere Installationen ist ZFS jedoch häufig einfacher zu verstehen, schneller einzurichten und leichter zuverlässig zu betreiben.
- ZFS für kleine und mittlere Cluster bevorzugt prüfen
- Ceph nur mit passender Hardware und Erfahrung produktiv einsetzen
- Backups nie durch Snapshots ersetzen
- Replikationen regelmäßig kontrollieren
- Monitoring zwingend einplanen
- 2FA und SSH-Hardening aktivieren
- Proxmox Backup Server sauber absichern
Ressourcen
- Aktueller sysops Prospekt
- aow.de – Linkliste zu allen Projekten
- cloudistboese.de – Schulungsportal für Proxmox, ZFS und Open Source
- sysops.tv auf YouTube
- Bashclub Proxmox ZFS Postinstaller auf GitHub
Proxmox Schulung oder Beratung anfragen
Sie möchten Proxmox VE mit ZFS, Replikation, Backup und Monitoring professionell einsetzen? Die sysops GmbH unterstützt bei Planung, Installation, Migration, Schulung und Betrieb.
📧 info@sysops.de
📞 +49 (0) 6021 2125-0
Vielen Dank für Ihre Aufmerksamkeit.
Christian-Peter Zengel – sysops.tv
Update: Ceph-Vernetzung mit Proxmox VE 9 und Network Fabrics
Seit Proxmox VE 9 lässt sich die Ceph-Vernetzung deutlich einfacher abbilden. Mit den neuen SDN Network Fabrics können geroutete Underlay-Netzwerke direkt über die Proxmox-Oberfläche erstellt werden.
Damit werden insbesondere Full-Mesh-Netzwerke für Ceph übersichtlicher und wartbarer. Proxmox beschreibt selbst, dass Fabrics ab PVE 9 über den SDN-Stack in der GUI erstellt werden können und sich für Full-Mesh-Ceph-Setups eignen. [oai_citation:0‡Proxmox VE](https://pve.proxmox.com/wiki/Full_Mesh_Network_for_Ceph_Server?utm_source=chatgpt.com)
Für neue Ceph-Installationen sollte daher geprüft werden, ob die Vernetzung über Datacenter → SDN → Fabrics sinnvoller ist als eine manuelle statische Netzwerkkonfiguration.
ZFS Grundlagen am Beispiel Proxmox VE(Stand Dezember 2025)
ZFS Grundlagen mit Proxmox VE – Praxiswissen für sichere Server, Backups und Storage-Systeme
Erfahrung aus rund 150 produktiven Proxmox- und ZFS-Systemen
Der Verfasser dieser Dokumentation, Christian-Peter Zengel, verfügt über rund 18 Jahre Praxiserfahrung mit ZFS und Proxmox und betreibt aktuell etwa 150 Systeme mit Proxmox VE und ZFS.
Die hier beschriebenen Erfahrungen stammen aus realen Installationen – von einzelnen Standalone-Servern bis zu Proxmox-Clustern mit bis zu zehn Hosts.
Der Fokus liegt auf ZFS als robuste, sichere und wirtschaftliche Storage-Grundlage für kleine und mittlere IT-Umgebungen.
Warum ZFS für Proxmox, TrueNAS und Linux-Server?
ZFS ist eine ideale Grundlage für Systeme, bei denen Datenintegrität, Snapshots, Replikation und schnelle Wiederherstellung entscheidend sind. Gerade bei Proxmox VE, TrueNAS, Backup-Servern und Fileservern bietet ZFS erhebliche Vorteile gegenüber klassischen RAID-Controllern oder einfachen Dateisystemen.
- Hohe Datensicherheit durch Prüfsummen
- Snapshots in Sekunden
- Rollbacks bei Fehlern oder Updates
- Replikation auf andere Systeme
- Schutz vor Bedienfehlern
- Bessere Wiederherstellung nach Ausfällen
- Sehr gute Grundlage gegen Ransomware-Schäden
- Flexible Storage-Konzepte ohne klassischen RAID-Controller
In der Praxis zeigt sich ZFS für viele kleine und mittlere Systeme einfacher, vielseitiger, schneller und günstiger als Ceph. Eine produktive Ceph-Expertise wird hier bewusst nicht behauptet; intern wird jedoch intensiv an passenden Hauslösungen gearbeitet.
ZFS Onlinekurs und Schulung
Diese Dokumentation basiert auf einem Onlinekurs von cloudistboese.de. Die ZFS-Grundlagenkurse werden regelmäßig angeboten und vermitteln die wichtigsten Konzepte für den sicheren Einsatz von ZFS mit Proxmox VE, TrueNAS und vergleichbaren Systemen.
Aktuelle ZFS-Kurse und weitere Open-Source-Schulungen auf cloudistboese.de ansehen
Die Wiederholung der Onlinekurse sowie der Zugriff auf Aufzeichnungen sind für Kursteilnehmer kostenlos.
Inhalte des ZFS-Grundlagenkurses
ZFS ist die perfekte Grundlage, um kleine und mittlere Systeme gegen Ausfälle, Fehlbedienung und Verschlüsselungstrojaner besser abzusichern.
Der Kurs vermittelt Grundkenntnisse für den praktischen Einsatz mit:
- Proxmox VE
- TrueNAS
- Linux-Servern
- Backup-Systemen
- Fileservern
- kleinen und mittleren Virtualisierungsumgebungen
Themen im Überblick
- Grundbegriffe und Überblick über ZFS
- Aufbau von RAID-Konzepten mit
zpool - ZFS-Basisfunktionen am Beispiel von Proxmox VE
- Snapshots und Rollbacks
- Replikation in der Praxis
- Prüfung von Replikationen
- Datasets, ZVOLs und Storage-Struktur
- Cache, Logdevice und Special Device
- Typische Fehlentscheidungen vermeiden
Nach diesem Kurs sind Sie bei Ausfällen, Bedienfehlern und Datenverlust deutlich besser vorbereitet und können viele Systeme innerhalb weniger Minuten wieder produktiv machen.
ZFS RAID mit zpool erstellen
So erstellt Proxmox VE einen ZFS Mirror
zpool create -f -o cachefile=none -o ashift=12 rpool mirror disk1 disk2Die wichtigsten Parameter:
-ferzwingt das destruktive Anlegen des Pools-o cachefile=noneverhindert automatischen Import beim Startashift=12ist die übliche Wahl für moderne 4K-Sektorenrpoolist der Name des Poolsmirrordefiniert den RAID-Level- Disks sollten eindeutig über
/dev/disk/by-idangesprochen werden
Mögliche RAID-Varianten sind unter anderem:
- Stripe
- Mirror
- Striped Mirror / RAID10
- RAIDZ1
- RAIDZ2
- RAIDZ3
Praxisumgebung im Kurs
Im Kurs wird ein älterer Supermicro-Server mit 24 Einschüben sowie zwei NVMe-Datenträgern verwendet. Damit lassen sich verschiedene ZFS-Szenarien realistisch abbilden.
Die Verwendung gebrauchter und teilweise ungetesteter Datenträger zeigt sehr schnell, warum ZFS in der Praxis so wertvoll ist.
Empfehlung: Für produktive Systeme immer Enterprise-NVMe und ECC-RAM verwenden.
Bereits verwendete Datenträger können in Proxmox VE über die Wipe-Funktion bereinigt werden. Bei alten LVM- oder Ceph-Installationen empfiehlt sich jedoch häufig eine vorherige vollständige Löschung, beispielsweise mit nwipe.
Proxmox VE Bootlayout mit ZFS verstehen
Proxmox VE nutzt bei ZFS-Installationen ein spezielles Bootlayout. Wichtig ist, dass immer ausreichend bootfähige Datenträger mit passendem Partitionslayout vorhanden sind.
Typischerweise gibt es:
- eine kleine Partition für BIOS/GRUB
- eine EFI-Systempartition für
proxmox-boot-tool - eine ZFS-Partition für den eigentlichen Pool
Wird später unbedacht mit ganzen Disks gearbeitet, kann es passieren, dass keine geeignete Bootstruktur mehr vorhanden ist.
Laufwerke unter Linux eindeutig ermitteln
Vor dem Erstellen eines ZFS-Pools müssen die Laufwerke eindeutig identifiziert werden. Dafür eignen sich unter Linux mehrere Werkzeuge.
apt install lshw iotop
# Detaillierte Übersicht aller Laufwerke
lshw -class disk
# Liveansicht beim Einschieben von Festplatten
dmesg -Tw
# Eindeutige Laufwerksnamen über by-id anzeigen
ls -althr /dev/disk/by-idBeispiel: lshw
Beispiel: /dev/disk/by-id

Wichtige Entscheidungen beim Anlegen eines ZFS-Pools
Die wichtigsten Entscheidungen beim Anlegen eines ZFS-Pools sind:
- RAID-Level
ashift- Kompression
- Volblocksize
- Dataset-Struktur
- Cache- und Log-Konzept
Fehler an dieser Stelle lassen sich später häufig nur mit erheblichem Aufwand korrigieren.
RAID-Level: Mirror, RAID10 oder RAIDZ?
Mirror und Striped Mirror
Mirror und Striped Mirror sind für Proxmox VE meist die unproblematischste Wahl. Sie kosten zwar 50 % der Rohkapazität, bieten aber hohe Performance, einfache Erweiterbarkeit und sehr gute Wiederherstellbarkeit.
- Vorteile: schnell, einfach, robust
- Nachteile: 50 % Kapazitätsverlust
- Ideal für: VMs, LXCs, produktive Proxmox-Hosts
RAIDZ1, RAIDZ2 und RAIDZ3
RAIDZ bietet mehr nutzbare Kapazität, ist aber für VMs und LXCs auf drehenden Festplatten nur eingeschränkt geeignet.
- Vorteile: mehr nutzbarer Speicherplatz
- Nachteile: schlechter für viele kleine synchrone Schreibzugriffe
- Ideal für: Fileserver, Archivspeicher, Backup-Ziele
Virtuelle Maschinen sollten im Normalfall nicht auf drehenden Festplatten mit RAIDZ betrieben werden. Als Kompromiss kann RAIDZ mit NVMe Cache und Logdevice eingesetzt werden.
Ashift richtig wählen
Bei ZFS bezeichnet ashift die interne Sektorgröße eines VDEVs. Früher wurde häufig mit ashift=9 für 512-Byte-Sektoren gearbeitet. Für heutige Datenträger ist ashift=12 praktisch immer die richtige Wahl.
Empfehlung: Aktuell immer ashift=12 verwenden.
Eine falsche Einstellung kann zu massiven Leistungseinbußen und erheblicher Platzverschwendung führen.
Technischer Hintergrund zu ZFS ashift
Kompression mit ZFS
ZFS-Kompression kann erheblich Speicherplatz sparen, insbesondere bei Datenbanken, Logs, Textdateien, VM-Images und vielen Serverdaten.
Unsere heutige Empfehlung:
zfs set compression=on poolname/datasetFrüher wurde häufig explizit compression=lz4 gesetzt. In vielen aktuellen Umgebungen ist compression=on sinnvoll und ausreichend.
In der Praxis sparen wir damit häufig ein Drittel oder mehr Speicherplatz – ohne spürbare Geschwindigkeitseinbußen.
ZFS Dataset-Struktur für Proxmox VE
Nach dem Erstellen eines Pools sollte nicht einfach der Pool selbst als Proxmox Storage verwendet werden. Besser ist eine saubere Struktur mit getrennten Datasets.
zfs create mirror500g/data
zfs create mirror500g/clone
zfs create -o com.sun:auto-snapshot=false mirror500g/replDanach kann der Storage in Proxmox VE sauber als beispielsweise mirror500g-data eingebunden werden.
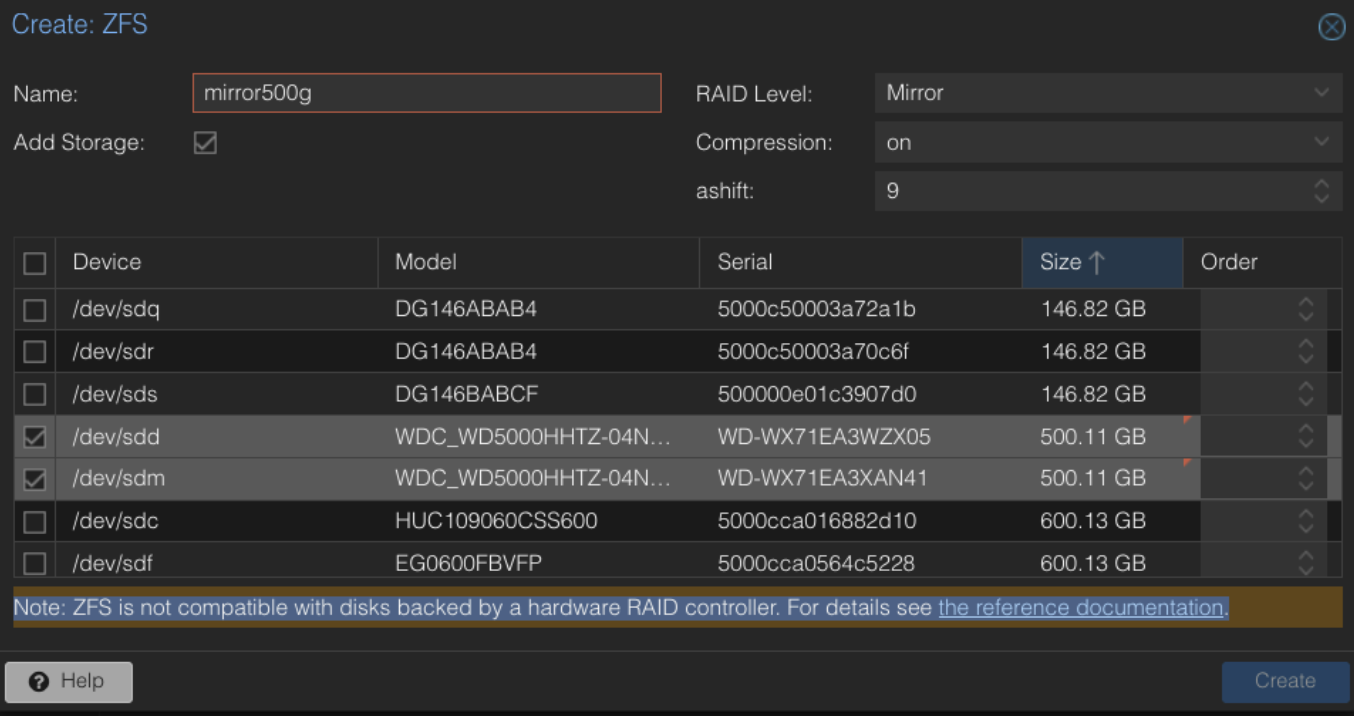
Praxisbeispiele: zpool create
Stripe / RAID0
Nur für Testsysteme oder Daten ohne Schutz sinnvoll.
zpool create -f test \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2c \
wwn-0x5000cca01a83a61cMirror / RAID1
zpool create -f test mirror \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2cStriped Mirror / RAID10
zpool create -f test \
mirror wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c \
mirror wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 \
mirror wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8RAIDZ1
zpool create test raidz \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2c \
wwn-0x5000cca01a83a61c \
wwn-0x5000cca01a832d24 \
wwn-0x5000cca01a83331c \
wwn-0x5000cca01a7495b8RAIDZ2
zpool create test raidz2 \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2c \
wwn-0x5000cca01a83a61c \
wwn-0x5000cca01a832d24 \
wwn-0x5000cca01a83331c \
wwn-0x5000cca01a7495b8RAIDZ mit mehreren VDEVs
zpool create test \
raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c \
raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8Dry-Run vor dem Anlegen
Vor destruktiven Aktionen immer prüfen:
zpool create -n test mirror disk1 disk2ZFS Cache, ARC, L2ARC und Logdevice
ARC – Cache im RAM
Der ARC ist der First-Level-Cache von ZFS und nutzt RAM. Als grobe Praxisregel kann man etwa 1 GB RAM pro 1 TB Netto-Daten ansetzen. Entscheidend ist jedoch immer der konkrete Einsatzzweck.
arcstat 1 
L2ARC – zusätzlicher Lesecache
Ein L2ARC kann als schneller Lesecache auf SSD oder NVMe eingesetzt werden. Er ist besonders interessant, wenn der Arbeitsspeicher nicht ausreicht und viele wiederkehrende Lesezugriffe auftreten.
zpool add test cache /dev/disk/by-id/nvme-cache-deviceSLOG / Logdevice
Ein Logdevice kann synchrone Schreibzugriffe beschleunigen, muss aber zwingend zuverlässig und im produktiven Einsatz gespiegelt sein.
zpool add test log mirror /dev/disk/by-id/nvme-log-1 /dev/disk/by-id/nvme-log-2
zfs set sync=always test 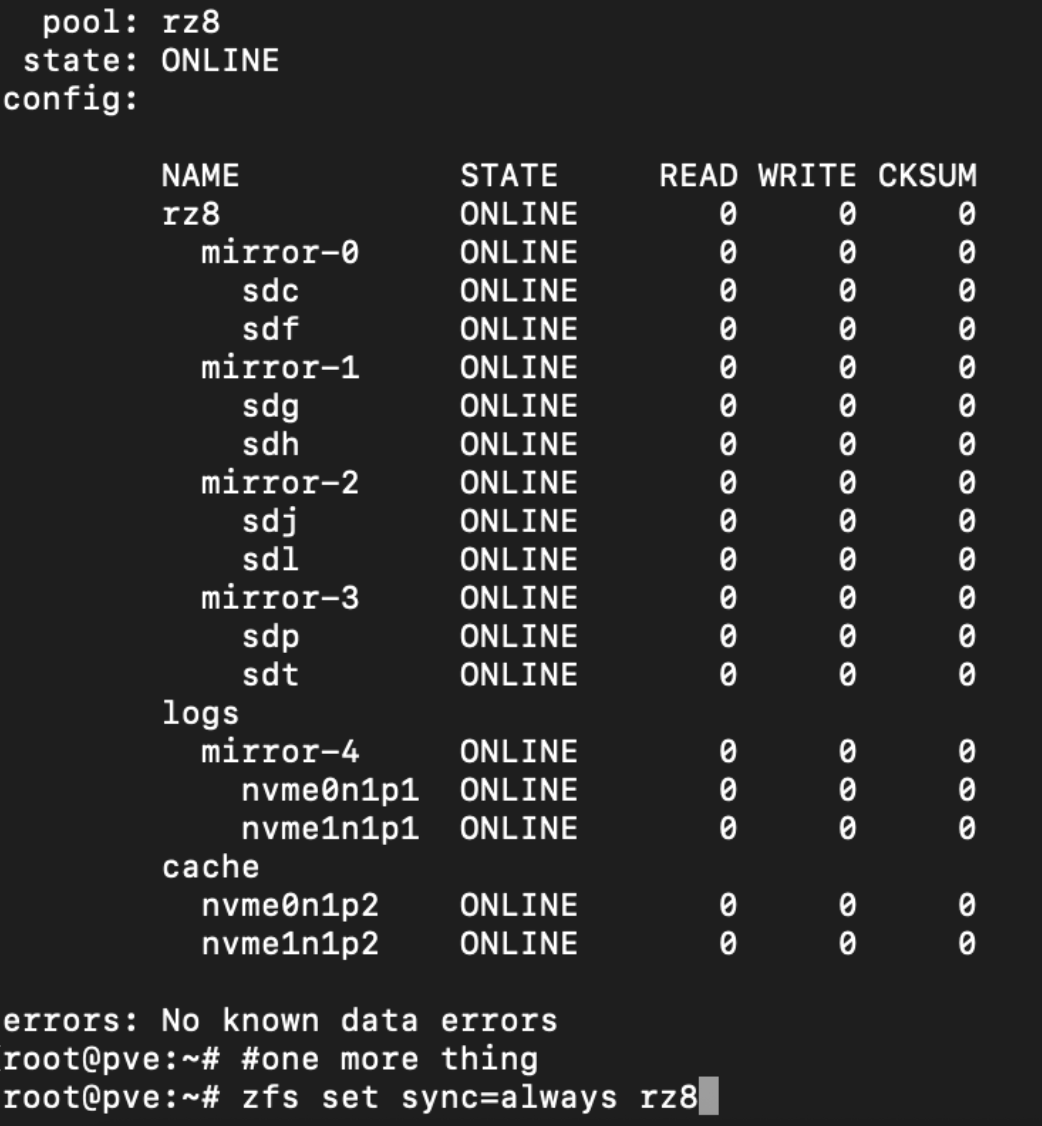
ZFS Special Device
Ein Special Device kann Metadaten und kleine Blöcke auf schnelle SSDs oder NVMes auslagern. Es muss zwingend redundant, also mindestens gespiegelt, aufgebaut werden.
Sinnvoll wird ein Special Device erst mit einer passenden Definition der Blockgröße, beispielsweise für kleine Blöcke bis etwa 64K.
In unseren Tests zeigte ein Special Device vor allem bei Fileservern und LXC-Workloads Vorteile. Im klassischen VM-Betrieb war der Nutzen deutlich geringer.
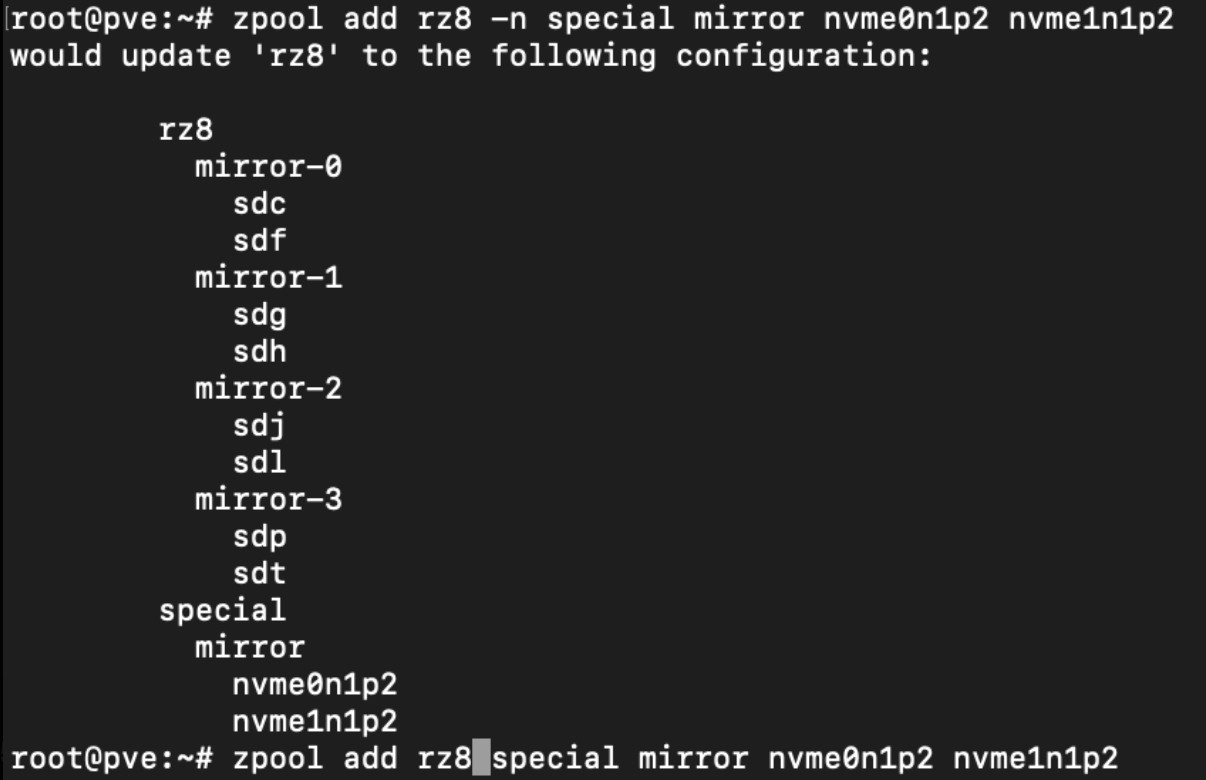

ZFS Pool importieren und entfernen
ZFS-Pools können importiert werden, ohne sie zu löschen. Besonders sinnvoll ist der Import über /dev/disk/by-id, damit später im Status eindeutige Laufwerksnamen angezeigt werden.
zpool import
zpool import poolname
zpool import -d /dev/disk/by-id poolname 
Datasets und ZVOLs verstehen
Datasets
Datasets werden wie Dateisysteme gemountet und eignen sich für:
- LXC-Container
- Backupdateien
- Vorlagen
- Serverdateien
- Fileserver-Daten
ZVOLs
ZVOLs verhalten sich wie virtuelle Blockgeräte. Sie werden unter /dev/zd... und mit sprechenden Namen unter /dev/zvol/poolname/... bereitgestellt.
Sie eignen sich insbesondere für virtuelle Festplatten von VMs.
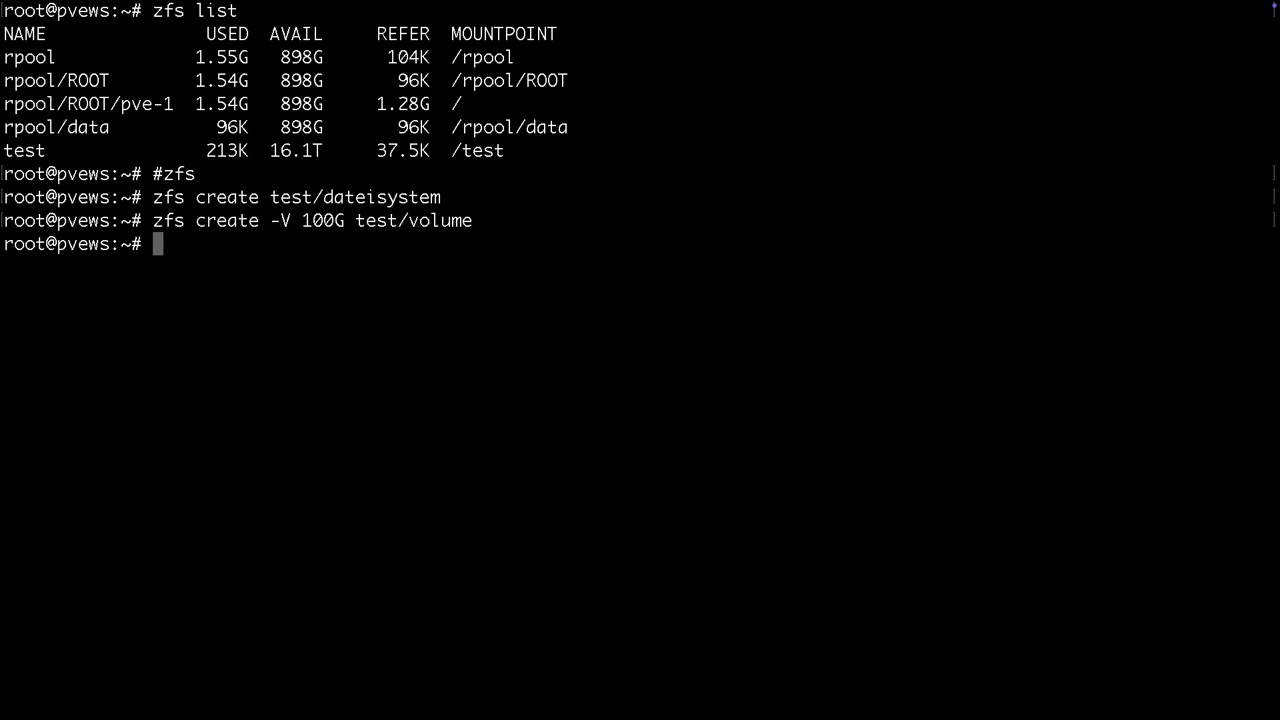
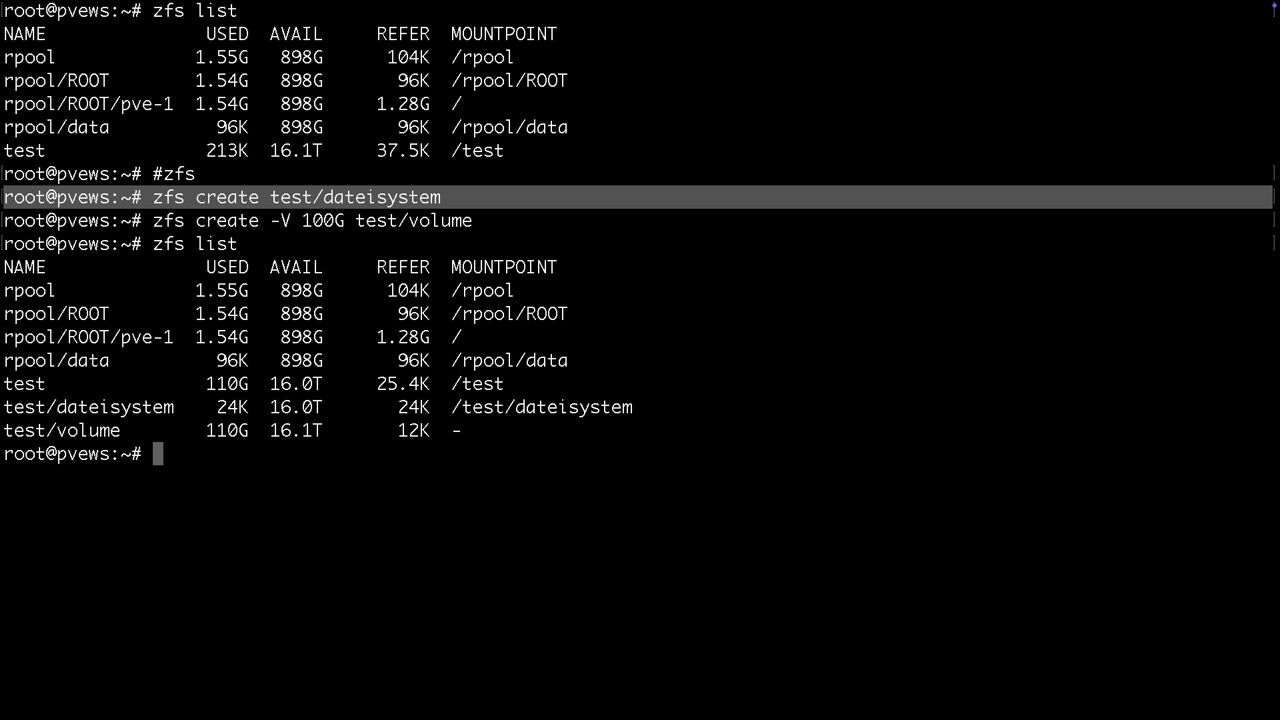
Thin- und Thick-Provisioning mit ZFS
Proxmox VE erzeugt virtuelle Festplatten auf ZFS typischerweise als ZVOLs. Thin Provisioning spart zunächst Speicherplatz, muss aber sorgfältig überwacht werden.
Beispiel: Thin Provisioning für eine VM
zfs create -s -b 16k -V 33554432k rpool/data/vm-301-disk-4Beispiel: Dataset für LXC
zfs create -o acltype=posixacl -o xattr=sa -o refquota=33554432k rpool/data/subvol-106-disk-1Bei LXC-Containern ist die Dimensionierung besonders wichtig, da Snapshots und Aufbewahrungszeiten den effektiv nutzbaren Platz beeinflussen.
Virtuelle Diskimages wie QCOW2, VMDK oder RAW-Dateien sollten normalerweise nicht innerhalb eines ZFS-Datasets abgelegt werden, außer bei speziellen NFS- oder iSCSI-Szenarien.
ZFS Pool Features aktualisieren
Wenn zpool status neue ZFS-Funktionen meldet, können diese grundsätzlich aktualisiert werden:
zpool upgrade -aWichtig: Vor einem Upgrade sollte geprüft werden, ob vorhandene Notfall-ISOs, Rettungssysteme und andere Hosts die neuen ZFS-Features bereits unterstützen.
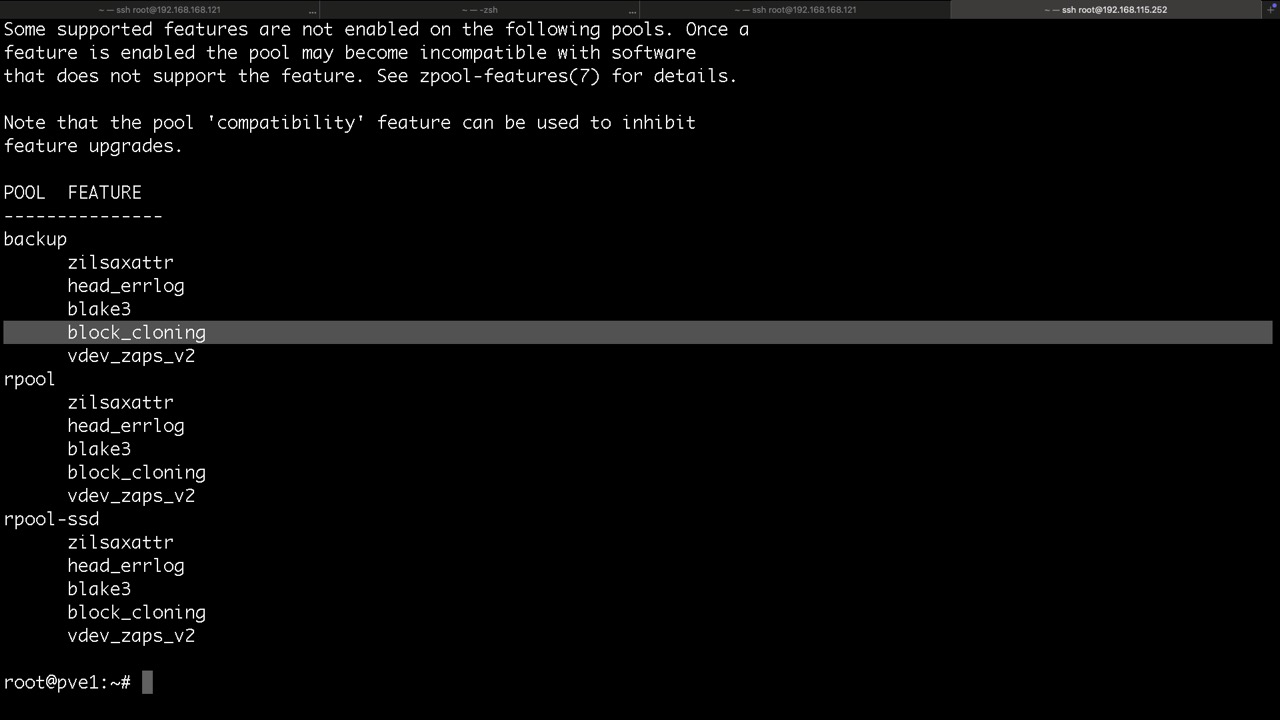
ZFS Parameter auslesen
Für Pools, Datasets, Volumes und Snapshots können Eigenschaften mit zfs get ausgelesen werden.
zfs get all poolname
zfs get compression poolname/dataset
zfs get used,available,referenced poolname/dataset 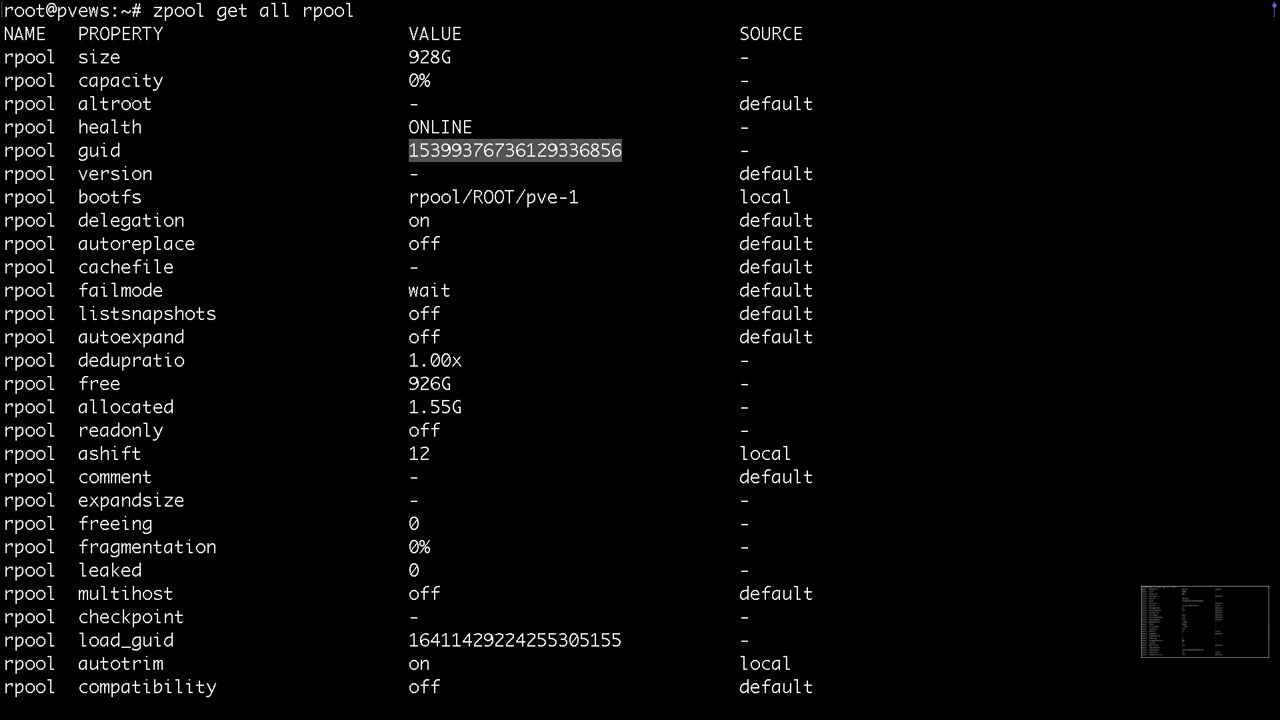
Fazit: ZFS als stabile Basis für Proxmox VE
ZFS ist für viele Proxmox-Umgebungen die beste Grundlage, wenn Datensicherheit, Snapshots, Replikation und Wiederherstellbarkeit im Vordergrund stehen.
Für produktive Systeme sind besonders wichtig:
- saubere Planung des RAID-Layouts
ashift=12- passende Volblocksize
- Kompression aktivieren
- Enterprise-Datenträger verwenden
- ECC-RAM einsetzen
- Snapshots und Replikation regelmäßig prüfen
- Backups und Wiederherstellung testen
Diese Dokumentation wird fortlaufend erweitert.
ZFS Schulung oder Beratung anfragen
Sie möchten ZFS mit Proxmox VE produktiv einsetzen, bestehende Systeme prüfen oder ein sicheres Storage- und Backup-Konzept entwickeln?
Die sysops GmbH unterstützt bei Planung, Migration, Betrieb, Monitoring und Schulung rund um Proxmox VE, ZFS, Backup und Open Source Infrastruktur.
📧 info@sysops.de
📞 +49 (0) 6021 2125-0
Das Ende von Hetzner DNS Robot und ACME API - Stand Januar 2026
Hetzner DNS Robot Abschaltung 2026 – wichtige Hinweise zu ACME, OPNsense und Proxmox
Wichtige Information für Kursteilnehmer und Kunden
Hallo liebe Kursteilnehmer,
zunächst wünschen wir euch ein frohes neues Jahr 🎉
Bitte schaut euch ergänzend die Sendung „Welche unnötigen Arbeiten müssen dieses Jahr erledigt werden?“ – Live vom 05.01.2026 an. Dort besprechen wir die anstehenden Änderungen, typische Stolperfallen und mögliche Lösungswege rund um DNS, Zertifikate und Automatisierungen.
Hetzner stellt den alten DNS Robot Service im Mai 2026 ein
Wir nutzen den Hetzner Robot DNS Service seit fast 20 Jahren. Dieser Dienst wird von Hetzner im Mai 2026 eingestellt. Bestehende DNS-Zonen müssen in die neue Verwaltung innerhalb der Hetzner Console migriert werden.
Hetzner nennt als Enddatum den 27.05.2026. Neue DNS-Zonen können in der alten DNS Console bereits nicht mehr angelegt werden. Auch bestehende Automatisierungen müssen rechtzeitig geprüft und angepasst werden.
Offizielle Statusmeldung von Hetzner:
Shutdown of DNS Console (dns.hetzner.com) in May 2026
Neue Hetzner Console:
https://console.hetzner.com/projects
Warum ist die Umstellung wichtig?
Viele Systeme erzeugen und verlängern TLS-Zertifikate automatisch per ACME DNS-01 Challenge. Wird dabei noch die alte Hetzner DNS API verwendet, funktionieren diese Automatisierungen spätestens nach der Abschaltung nicht mehr zuverlässig.
Betroffen sein können unter anderem:
- OPNsense Firewalls
- Proxmox VE Hosts
- Proxmox Backup Server
- Proxmox Mail Gateway
- Reverse Proxies
- Mailserver
- Monitoring-Systeme
- Automatisierte Zertifikatsverlängerungen mit acme.sh oder ähnlichen Tools
Wichtig: Prüft frühzeitig, ob eure Systeme noch den alten Hetzner DNS-Service verwenden. Ab Mai 2026 kann eine nicht angepasste Konfiguration dazu führen, dass Zertifikate nicht mehr verlängert werden.
ACME und Zertifikate – aktueller Stand
Die technische Situation unterscheidet sich je nach eingesetztem System und Version. Bitte prüft deshalb jedes System einzeln und verlasst euch nicht darauf, dass eine funktionierende Konfiguration automatisch zukunftssicher ist.
OPNsense Community Edition
In der OPNsense Community Edition funktioniert die Umstellung nach aktuellem Stand mit dem ACME-Plugin os-acme-client 4.11 und der neuen Hetzner Cloud Console.
Das grundsätzliche Vorgehen:
- DNS-Zone in die neue Hetzner Console migrieren
- Neuen API-Token in der Hetzner Console erstellen
- Neue ACME DNS-Challenge in OPNsense anlegen
- DNS-Service auf die neue Hetzner-Cloud-Variante umstellen
- Zertifikate entsprechend anpassen
- Testausstellung oder Erneuerung durchführen
OPNsense Business Edition
Bei der OPNsense Business Edition ist besondere Vorsicht geboten. Dort kann je nach Release noch eine ältere Version des ACME-Plugins enthalten sein, die die neue Hetzner API noch nicht korrekt unterstützt.
Wenn eure OPNsense Business Edition noch os-acme-client 4.10 verwendet, sollte die ACME-Funktion vor der Umstellung sorgfältig geprüft werden.
Workaround auf eigenes Risiko
Der folgende Workaround funktionierte bei uns im Test. Bitte nur verwenden, wenn ihr wisst, was ihr tut, vorher ein Backup erstellt habt und das Risiko einschätzen könnt.
pkg add -f https://pkg.opnsense.org/FreeBSD:14:amd64/25.7/latest/All/acme.sh-3.1.2.pkg
pkg add -f https://pkg.opnsense.org/FreeBSD:14:amd64/25.7/latest/All/os-acme-client-4.11.pkgNach der Installation sollte die ACME-Konfiguration geprüft, die Challenge neu angelegt und eine Testausstellung durchgeführt werden.
Proxmox VE, Proxmox Backup Server und Proxmox Mail Gateway
Auch bei Proxmox VE, Proxmox Backup Server und Proxmox Mail Gateway müssen ACME-Konfigurationen geprüft werden. Entscheidend ist, ob bereits ein DNS-Plugin für die neue Hetzner Cloud DNS API vorhanden ist oder ob noch die alte Hetzner DNS API genutzt wird.
Mögliche Lösungswege
- Umstellung auf HTTP-Challenge, sofern technisch möglich
- Umstellung auf die neue Hetzner Cloud DNS API
- Verwendung eines gekauften Zertifikats
- Zentrale Zertifikatserstellung über OPNsense
- Automatisierter Zertifikats-Upload auf PVE oder PBS
- Manuelle oder halbautomatische Zertifikatsverteilung
Hinweis: Proxmox VE und Proxmox Backup Server lassen sich in vielen Szenarien über API oder Zertifikatsupload automatisieren. Beim Proxmox Mail Gateway ist die Situation schwieriger, da hierfür keine vergleichbare API für alle notwendigen Schritte zur Verfügung steht.
PMG: Zwei getrennte Automationen notwendig
Für Proxmox Mail Gateway können zwei getrennte Schritte erforderlich sein:
- Zertifikat und Schlüssel auf das PMG übertragen
- Zertifikat für API und SMTP aktivieren
Beispiel für die Aktivierung auf einem Proxmox Mail Gateway:
sleep 90
pmgconfig cert set api /root/-.sysopservice.net/fullchain.pem /root/-.sysopservice.net/key.pem --force --restart 1
pmgconfig cert set smtp /root/-.sysopservice.net/fullchain.pem /root/-.sysopservice.net/key.pem --force --restart 1Die Pfade müssen selbstverständlich an die jeweilige Umgebung angepasst werden.
Empfohlene Vorgehensweise
Wir empfehlen, die Umstellung nicht bis Mai 2026 aufzuschieben. Zertifikatsprobleme fallen häufig erst dann auf, wenn eine Erneuerung fehlschlägt und Dienste bereits Warnungen anzeigen oder ausfallen.
- Alle DNS-Zonen in der alten Hetzner DNS Console identifizieren
- Migration in die neue Hetzner Console planen
- Neue API-Tokens erstellen
- OPNsense, Proxmox, PMG, PBS und weitere Systeme prüfen
- ACME-Challenges neu anlegen oder anpassen
- Zertifikatserneuerung aktiv testen
- Monitoring für Zertifikatslaufzeiten kontrollieren
- Dokumentation der neuen Zugangsdaten und Tokens aktualisieren
Support durch die sysops GmbH
Die sysops GmbH unterstützt Kunden, Kursteilnehmer und Partner bei der Umstellung von Hetzner DNS, ACME, OPNsense, Proxmox VE, Proxmox Backup Server und Proxmox Mail Gateway.
Wenn ihr Unterstützung benötigt, meldet euch bitte über unser Ticketsystem.
Neue Kurse und Workshops
Der neue Kursplan wird auf unserem Schulungsportal veröffentlicht. Dort findet ihr aktuelle Workshops zu Proxmox, ZFS, OPNsense, Monitoring, Mailservern, Open Source und modernen IT-Infrastrukturen.
Aktuelle Kurse auf cloudistboese.de ansehen
Liebe Grüße
Chriz
Information zur Sicherung und Wiederherstellung von Windows 10/11-Systemen
Information zur Sicherung und Wiederherstellung von Windows 10/11-Systemen
Bitte nehmt zur Kenntnis, dass die Sicherung und der Ersatz (z. B. Austausch der Hardware) eines Windows 10- oder Windows 11-PCs inzwischen sehr problematisch sein kann.
Hintergrund
Neue Windows 11-Systeme verschlüsseln die Festplatte standardmäßig.
Der Verschlüsselungsschlüssel ist dabei an die Hardware (Trusted Platform Module, TPM) gebunden.
Das bedeutet:
-
Beim Umbau der Festplatte oder bei einer Wiederherstellung auf einem neuen PC (z. B. über URBackup) kann das System nicht entschlüsselt werden.
-
Diese Basisverschlüsselung ist ohne die ursprüngliche Hardware nicht aufhebbar (Stand heute).
Mögliche Vorgehensweisen
1. Kein Bedarf an Verschlüsselung (z. B. PC steht in verschlossenen Räumen)
-
Prüfen, ob eine Verschlüsselung aktiv ist:
-
Deaktivieren der Verschlüsselung:
-
Alternative: Falls Verschlüsselung gewünscht ist → BitLocker über Einstellungen → System → Speicher → BitLocker aktivieren und den Wiederherstellungsschlüssel sicher aufbewahren.
2. Bedarf an Verschlüsselung (z. B. bei mobilen Geräten)
-
Prüfung wie oben:
-
Diese Verschlüsselung ist an die jeweilige Hardware gebunden.
-
Empfehlung: BitLocker aktivieren und den Wiederherstellungsschlüssel unbedingt sichern.
→ Nur mit diesem Schlüssel ist eine vollständige Wiederherstellung möglich.
3. Zentrale Sicherung der BitLocker-Schlüssel über Gruppenrichtlinie (GPO)
In einer Active-Directory-Umgebung können BitLocker-Wiederherstellungsschlüssel automatisch im AD gespeichert werden.
Dies ermöglicht eine zentrale Verwaltung und Wiederherstellung der Schlüssel, auch wenn ein Benutzer den lokalen Key verliert.
Einrichtung (Kurzfassung):
-
GPO öffnen →
Computerkonfiguration → Administrative Vorlagen → Windows-Komponenten → BitLocker-Laufwerkverschlüsselung -
Unter Betriebssystemlaufwerke Richtlinie aktivieren:
„Wiederherstellungsinformationen in Active Directory Domain Services speichern“ -
Optional: Speicherung erzwingen, bevor Verschlüsselung beginnt.
-
Anwendung prüfen mit
gpupdate /force.
Hinweis: In Azure AD-Umgebungen werden die Schlüssel standardmäßig im Benutzerkonto im Azure-Portal hinterlegt.
Hinweise zur Datensicherung
-
Plattensicherung (Image-Backup): Wiederherstellung nur mit vorhandenem Schlüssel möglich.
-
Dateisicherung: z. B. mit URBackup oder ähnlichen Tools.
-
Proxmox Backup Server: Rücksicherung ist nur komplett möglich, da einzelne Dateien aus verschlüsselten Systemen nicht direkt extrahiert werden können.
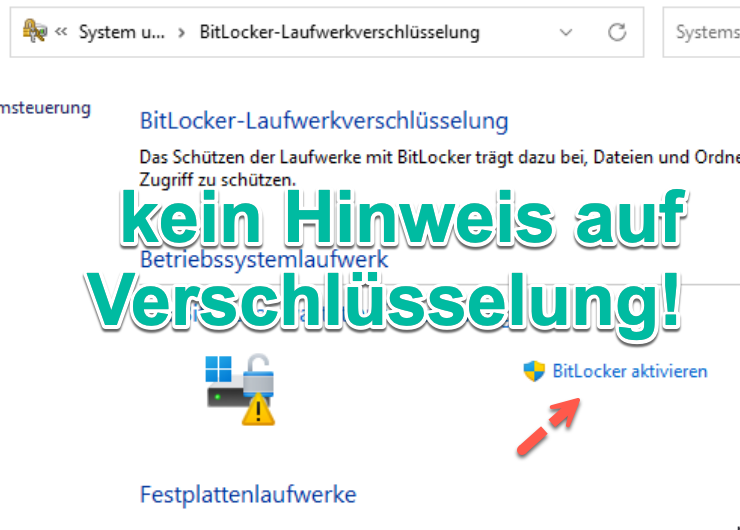
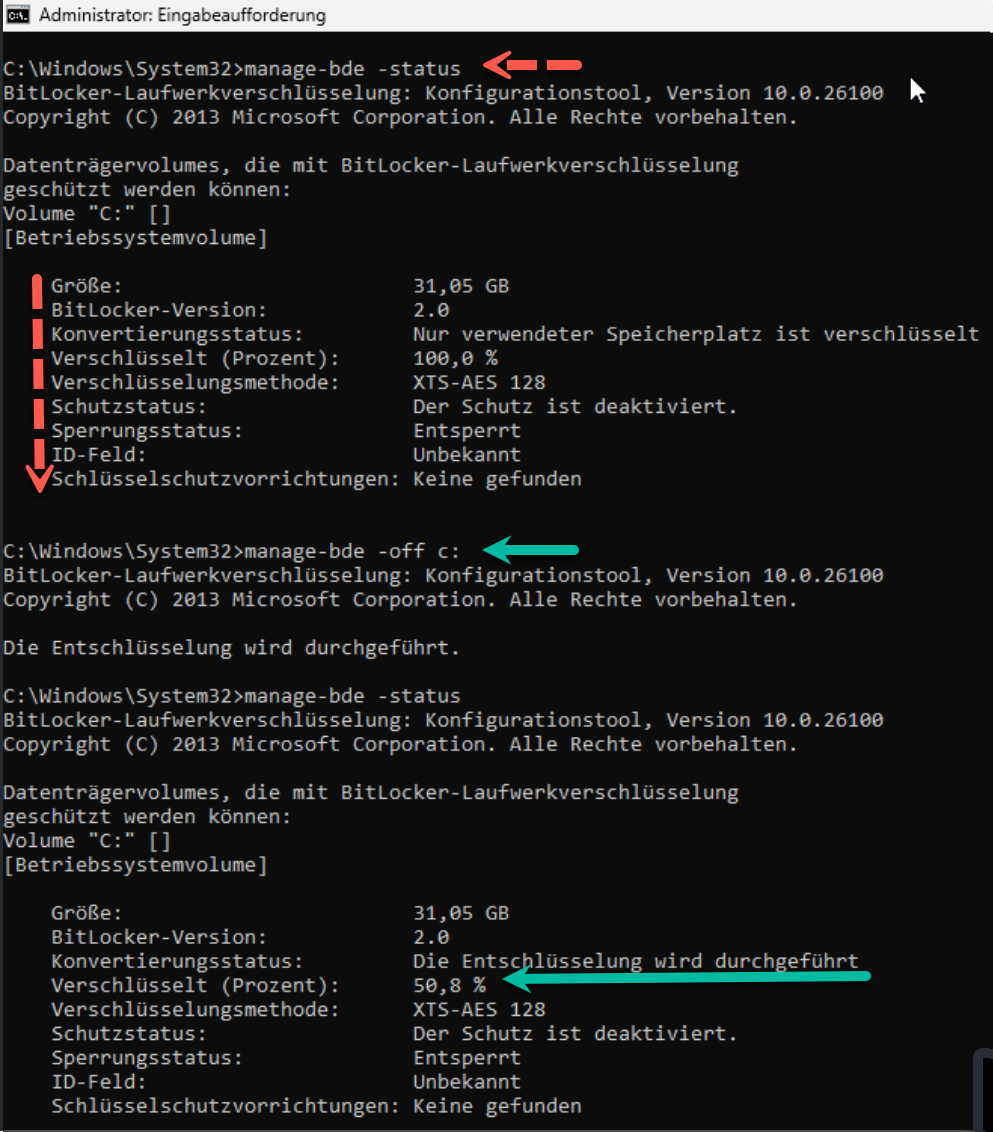
Stand der Technik nach DSGVO am Beispiel Kopano - Was sagt ChatGPT?
Auf Nachfrage interessierte mich die Meinung von ChatGPT zum Thema Übergangsfristen für abgelaufene Software, wie z. B. Kopano u. Ä. Nicht immer schafft man rechtzeitig die Migration auf aktuelle Systeme, meist wegen der Absprachen und Termin- und Kostengespräche mit Kunden
Nach der Datenschutz-Grundverordnung (DSGVO) gibt es keine ausdrücklichen Übergangsfristen für die Pflicht, Serversoftware auf dem Stand der Technik zu halten. Die Verordnung trat am 25. Mai 2018 in Kraft und gilt seither unmittelbar in allen EU-Mitgliedstaaten.
Was bedeutet "Stand der Technik" laut DSGVO?
Die DSGVO verlangt in Art. 32 Abs. 1 von Verantwortlichen und Auftragsverarbeitern geeignete technische und organisatorische Maßnahmen, um ein dem Risiko angemessenes Schutzniveau zu gewährleisten. Dabei ist „der Stand der Technik“ ein zentrales Kriterium.
Das bedeutet konkret:
-
Sicherheitslücken in Server- oder Anwendungssoftware müssen zeitnah geschlossen werden.
-
Der Einsatz nicht mehr unterstützter oder veralteter Software (z. B. alte PHP-Versionen, Windows 7, EOL-Linux-Distributionen) ist nicht zulässig, wenn dadurch Sicherheitsrisiken entstehen.
Gibt es trotzdem Spielräume oder Fristen?
Zwar gibt es keine festen Fristen in der DSGVO, aber:
-
In der Praxis kann bei Updates oder Umstellungen ein kurzer Zeitraum zur Umsetzung toleriert werden – solange ein Risikoanalyse- und Migrationsplan dokumentiert ist.
-
Bei Audits oder Vorfällen ist entscheidend, ob du als Verantwortlicher:
-
Risiken erkannt hast,
-
Maßnahmen geplant und priorisiert hast,
-
dokumentieren kannst, warum du etwas wie schnell umgesetzt hast.
-
Beispiele:
| Software | Stand der Technik? | Kommentar |
|---|---|---|
| Ubuntu 20.04 | Ja (bis 2025) | Unterstützt, wenn regelmäßig aktualisiert |
| Windows Server 2012 R2 | Nein (EOL) | Nicht mehr sicher, nicht DSGVO-konform |
| Apache 2.2 | Nein | Veraltet, seit Jahren nicht mehr unterstützt |
| Nextcloud (aktuelle LTS-Version) | Ja | Regelmäßige Updates, DSGVO-konform |
Fazit:
-
Keine Übergangsfristen – aber Planung und dokumentierte Risikobewertung sind wichtig.
-
Veraltete Software = hohes Bußgeldrisiko bei Datenschutzverstößen.
-
IT-Sicherheitsrichtlinien (z. B. vom BSI oder ISO 27001) helfen bei der Definition des „Stands der Technik“.
Wenn du willst, kann ich dir eine Checkliste zur DSGVO-konformen Server-Softwarepflege erstellen.
Das Problem mit Kopano Groupware unter Univention Corporate Server (UCS) 5.0 liegt mittelfristig vor allem beim Thema "Stand der Technik" im Sinne der DSGVO – insbesondere in Bezug auf:
🔧 1. Veraltete Softwarebasis von Kopano
-
Kopano Core (insbesondere
kopano-server,kopano-webapp,kopano-spoolerusw.) wird seit längerer Zeit kaum weiterentwickelt. -
Sicherheits- und Bugfix-Updates erscheinen selten oder gar nicht mehr regelmäßig.
-
Einige Komponenten (z. B.
kopano-webmeetings,kopano-dagent,kopano-z-push) sind teilweise nicht mehr kompatibel mit aktuellen PHP-Versionen, was ein Sicherheitsrisiko darstellt.
➡️ Risiko: Wenn Sicherheitslücken bekannt werden und keine Updates folgen, ist der „Stand der Technik“ nicht mehr gegeben.
📦 2. Eingeschränkte oder fehlende Wartung im UCS App Center
-
Kopano war lange im UCS App Center verfügbar, wurde aber teilweise nicht mehr aktiv gepflegt.
-
Mit der Umstellung auf UCS 5.0 wurden viele Altpakete nicht migriert oder sind nur mit manuellem Aufwand nutzbar.
-
Kopano4UCS, ein Community-Projekt, hat zwar Lösungen bereitgestellt, diese gelten nicht als offizieller Supportpfad.
➡️ Risiko: Kein garantierter Support, keine klare Roadmap, und Integration in UCS nur noch teilweise gepflegt.
🔒 3. Unklare Sicherheitsgarantie & Datenschutzfolgeabschätzung
-
Nach DSGVO musst du jederzeit nachweisen können, dass deine Systeme sicher sind.
-
Bei Kopano ist eine fundierte Datenschutzfolgeabschätzung (DSFA) kaum möglich, wenn:
-
keine Sicherheitsupdates veröffentlicht werden,
-
unklar ist, wie Daten verschlüsselt übertragen oder gespeichert werden,
-
keine aktuellen Dokumentationen verfügbar sind.
-
➡️ Risiko: Du trägst die volle Haftung bei Datenpannen – auch wenn die Ursache eine nicht gewartete Drittsoftware ist.
📆 4. Abhängigkeit von veralteten Komponenten
-
PHP, MariaDB/MySQL, Apache-Versionen, auf die Kopano setzt, sind oft nicht mehr im Mainstream-Support.
-
Anpassungen an moderne Umgebungen (z. B. systemd, PHP 8.2+, OpenLDAP unter UCS 5.0) erfolgen nicht zuverlässig.
➡️ Risiko: Du bleibst auf alten Softwareständen – was DSGVO-widrig ist.
✅ Fazit: Wo ist mittelfristig das Problem?
| Bereich | Risiko | DSGVO-Auswirkung |
|---|---|---|
| Sicherheitspatches fehlen | Hoch | Kein „Stand der Technik“ |
| Keine Updates über App Center | Mittel | Wartung erschwert |
| Keine klare Produkt-Roadmap | Hoch | Planbarkeit & DSFA unmöglich |
| Technische Abhängigkeiten | Mittel bis hoch | Zunehmende Inkompatibilität |
🔄 Empfehlung
Wenn du Kopano (noch) nutzt:
-
Erstelle eine Risikoanalyse und dokumentiere die Abhängigkeit.
-
Plane mittelfristig die Migration (z. B. auf Open-Xchange, EGroupware, Nextcloud Groupware + Mailcow).
-
Prüfe Alternativen mit aktivem Hersteller-Support und Sicherheitszertifizierungen.
Wenn du möchtest, kann ich dir eine Migrations-Checkliste oder Alternativen zu Kopano unter UCS zusammenstellen.
Virtuelle Maschine mit Windows 10 Bios auf Proxmox zu Windows 11 mit UEFI umstellen
Windows 11 Migration Bios zu UEFI
Win11 Upgrade BIOS -> UEFI ist keine einfache Aufgabe
Auch wenn es Workarounds gibt, möchten wir für virtuelle Windows 11 Maschinen die maximale Lebensspanne an Upgrades. Daher passen wir das System im Bereich Partitionstabelle, TPM und virtuelle Hardware an
Systemplatte erweitern
In Proxmox großzügig die Platte, wenn Thin Provisioning aktiviert ist, erweitern.
Danach die Partition in Windows vergrößern, da wir am Ende Platz für eine EFI Partition benötigen!
BCD neu schreiben
bcdboot c:\windows /s c: /f allWin Part als aktiv markieren
diskpart
select disk 0
select part 2
activeDisk zu GPT konvertieren
mbr2gpt.exe /convert /allowFullOS /disk:0VM Shutdown und neu konfigurieren
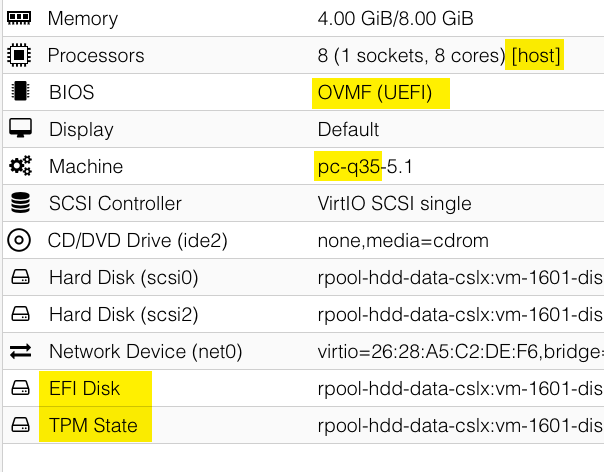
-
BIOS OVM (UEFI) # Bei VM Start mit ESC in die Einstellungen gehen und Secure Boot deaktivieren!
-
TPM 2.0 State hinzufügen
-
EFI Disk hinzufügen
-
Optional vorm ersten Boot alle Disks mit detach entfernen und mit IDE wieder hinzufügen, danach Bootreihenfolge nicht vergessen
-
Optional und empfohlen: virtio-iso mounten für aktuelle Treiber CD
VM einschalten
-
Bei VM Start mit ESC in die Einstellungen gehen und Secure Boot deaktivieren!
-
Wenn Inaccessible Boot Device, dann booten mit F8 unsignierten Treibern aktivieren
Shutdown
- Disks wieder auf SCSI stellen, wie oben beschrieben
VM Starten
- Windows 11 ISO einlegen
- Windows 11 Upgrade starten
ZFS Grundlagen am Beispiel Proxmox VE(Stand Januar 2025)
Der Verfasser des Artikels, Christian-Peter Zengel, hat zum Zeitpunkt des Artikels ca 15 Jahre Erfahrung mit ZFS und Proxmox. Er betreibt aktuell ca 150 Systeme mit Proxmox und ZFS
Das Einsatzgebiet geht von Standaloneinstallation bis zu ca 10 Hosts im Cluster. Es ist keine Ceph Expertise vorhanden!
Dieser Dokumentation basiert auf diesem online Kurse von cloudistboese.de
21. + 23.01.2025 (13.00 Uhr bis 17.00 Uhr) - ZFS Grundlagen
ZFS ist die perfekte Grundlage für kleine und mittlere Systeme um gegen Ausfälle, Dummheit anderer und Erpressungstrojanern ideal aufgestellt zu sein.
In diesem Kurs erhalten sie Grundkenntnisse für Systeme wie Proxmox, TrueNAS oder ähnliche Systeme.
Der Fokus liegt auf der Technologie und der permanenten Sicherheit im Umgang mit Daten, Linux und dem Terminal.
Themen:
- Begrifflichkeiten und Überblick
- Basisfunktionen von Proxmox und TrueNAS per GUI
- Erklärung und Beispiele Snapshots und Rollbacks
- Praxisbeispiele Replikation
- Prüfung der Replikationen
- Weitere Features die das Leben massiv erleichtern
Nach diesem Kurs bist Du bei Ausfällen und Datenverlust vor dem Schlimmsten geschützt und in Minuten wieder produktiv!
So erstellt Proxmox VE seinen ZFS Raid
zpool create -f -o cachefile=none -o ashift=12 rpool mirror disk1 disk2
Destruktives Anlegen (-f), kein automatisches Importieren beim Start (-o cachefile=none)
-o ashift=12 ist für 4k Festplatten, ashit=9 für 512e Disks, wobei man mit 12 nichts verkehrt macht
rpool ist der Name vom künftigen Pool, mirror der Raidlevel und die Disks wurden zweifelsfrei über Ihre ID definiertOptionen für Raidlevel wären noch: ohne als Stripe, raidz, raidz2 oder raidz3, also Raid Level 5-7
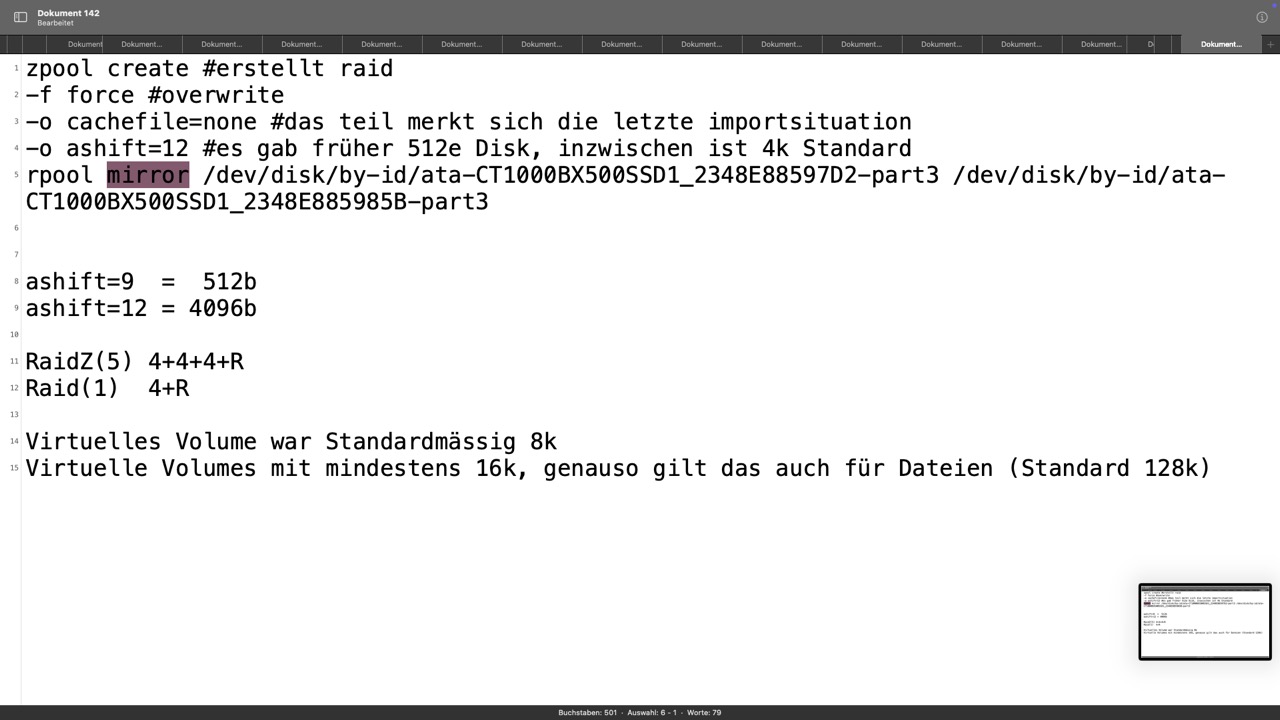
Die ersten Zpool Manöver und die endlose Aktionsliste sieht man mit
zpool history
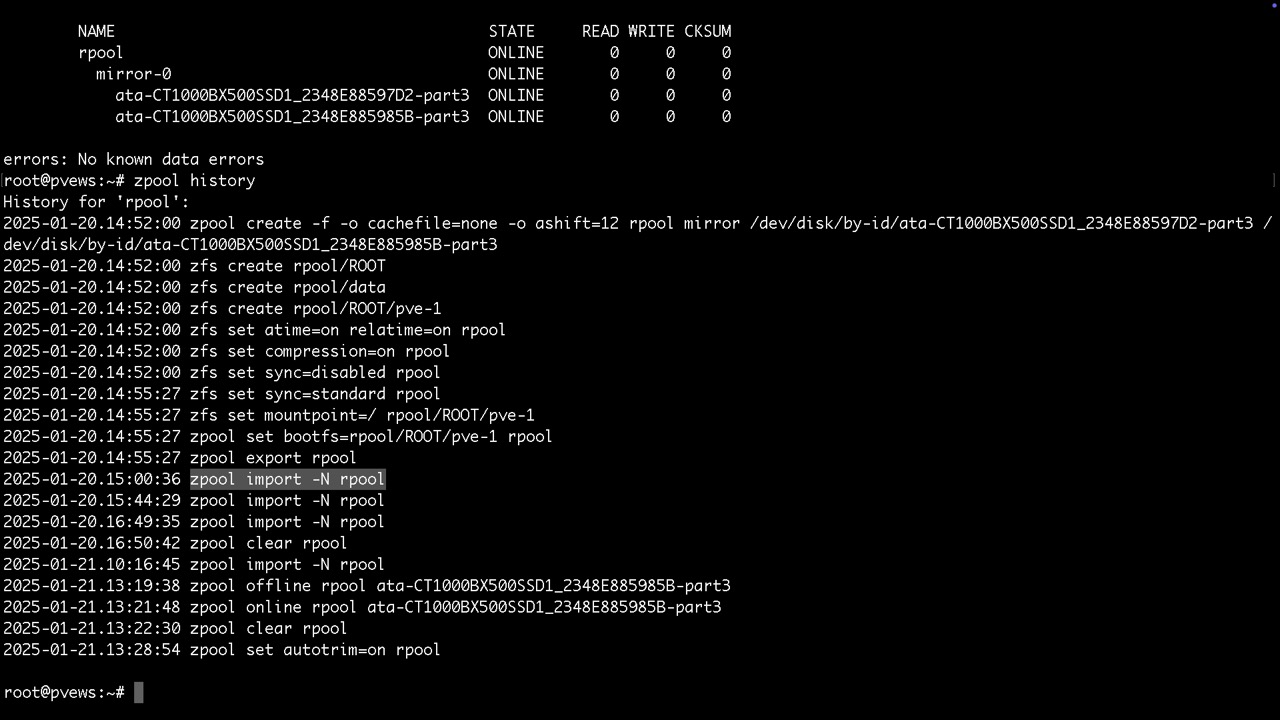
Manuelles Trimmen der SSDs um gelöscht Blöcke schner überschreiben zu können findet man unter /etc/cron.d
Ebenso wird nach diesem Zeitplan der sog. zpool scrub durchgeführt, der die Konsistenz der Redundanz prüft und ggf. korrigiert. Gefundene Fehler findet man dann mit zpool status
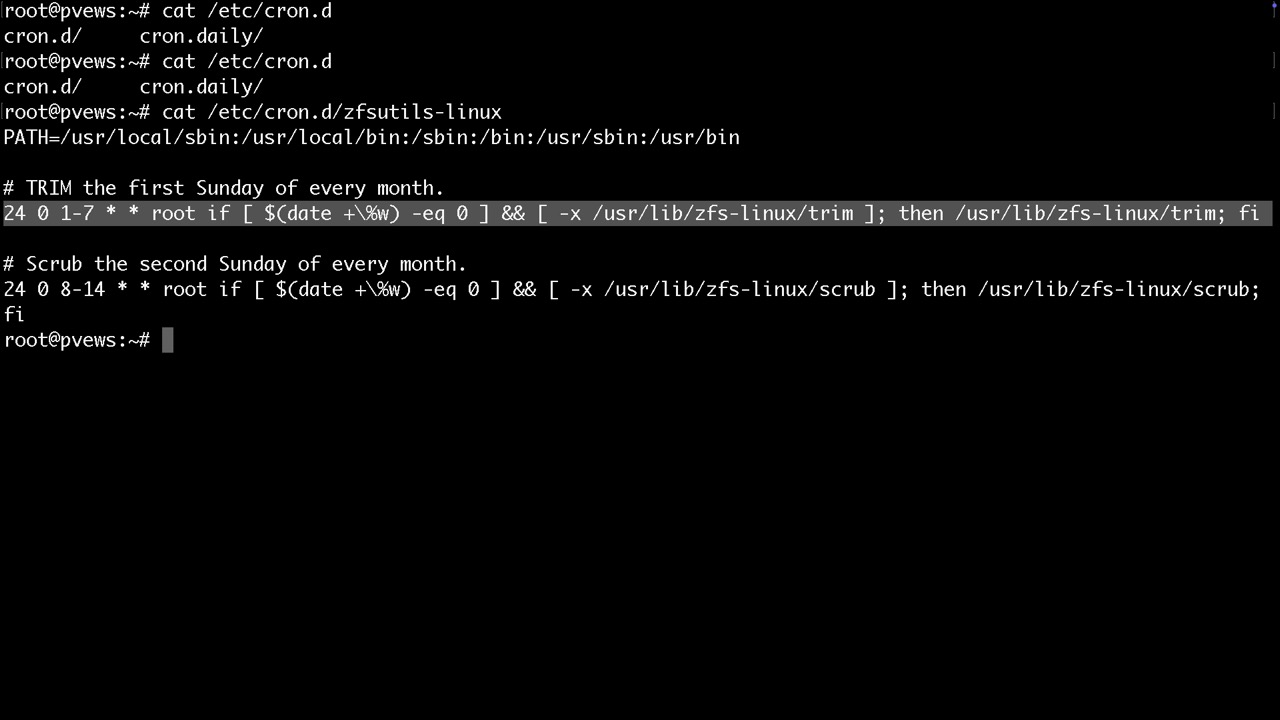
Zum identifizieren der Platten bieten sich neben der PVE GUI noch folgende Befehle an. Es wird dringend empfohlen bereits genutzte Platten via PVE GUI zu wipen
dmesg -Tw (live)
lsblk
ls -althr /dev/disk/by-id
Erstellen verschiedener Raidlevel und Ihrer Vorzüge
Mit ls -althr /dev/disk/by-id haben wir folgende Festplatten anhand ihrer aufgedruckten WWN Kennung identifiziert. Es ist dringend empfohlen bei HBAs sich die Slots und die Seriennummern beim Einbau zu notieren und in die Dokumentation aufzunehmen
wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 wwn-0x5000cca01a8417fc
Stripe, also Raid0
zpool create -f test wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8
Mirror, also Raid1
zpool create -f test mirror wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c
Striped Mirror, also Raid10
zpool create -f test mirror wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c mirror wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 mirror wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8
RaidZ, also Raid 5, Nettoplatz x-1
zpool create test raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 wwn-0x5000cca01a8417fc
RaidZ2, also Raid 6, Nettoplatz x-2
zpool create test raidz2 wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 wwn-0x5000cca01a8417fc
RaidZ-0, also Raid 5-0, Nettoplatz x-2, in diesem Beispiel
zpool create test raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8
oder mit Spare, wenn Du davon nicht booten musst
zpool create test raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 spare wwn-0x5000cca01a8417fc
Erweiterung eines RaidZ zum RaidZ-0
zpool add -n test raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8
Erweiterung eines Raid durch Ersetzen mit größeren Platten
Die Platten müssen die Gleiche Geometrie hanben, also 4k zu 4k oder 512e zu 512e
Bei Raid 1 und 10 reicht es zwei Disks zu tauschen, bei RaidZx müssen alle Disks getauscht werden
Replace Vorgänge können auch laufen ohne die Redundanz zu brechen, wenn weitere Slots frei sind
Bei Erweiterung durch Austausch von großen und vor allem älteren Raid 10 prüfen ob in einem Mirror ggf. neue Platten getauscht wurden, diese sollten weiter im Betrieb bleiben, während ältere Paare getauscht werden können
Caches und Logdevices
Vorsichtig formuloiert, Lese- und Schreibcache
First Level Cache, sog. ARC kommt aus dem RAM und bekommt idealerweise ca. 1GB für 1TB Nettodaten
Second Level Cache wird als Cachedevice als Partition auf einer schnelleren Disk als der Pool hat bereitgestellt, z. B. am idealsten mit NVMe
zpool add test -n cache sdl
Logdevice (Writecache muss gespiegelt werden)Damit der Log auch genutzt wird muss man noch mit zfs set sync den cache aktivieren
zpool add test -n log mirror sdl
zfs set sync=always test
Arc wird mit "arcstat 1" ausgelesen, er wird bei der Installation festgelegt oder später unter /etc/modprobe.d/zfs.conf geändert. update-initramfs -u macht das dann persistent und aktiviert die Änderungen beim nächsten reboot.Zur Laufzeit ändert man den Firstlevelcahce mitCache- und Logdevices mit zpool iostat 1
echo 2147483648 > /sys/module/zfs/parameters/zfs_arc_max
echo 1073741824 > /sys/module/zfs/parameters/zfs_arc_min
free -h && sync && echo 3 > /proc/sys/vm/drop_caches && free -h
arcstat 1
Test der Leistung eines Pools
zfs create -o compression=off test/speed
cd /test/speed
dd if=/dev/zero of=dd.tmp bs=256k count=16384 status=progress
dd if=/dev/zero of=dd.tmp bs=2M count=16384 status=progress


Erweiterung der Funktionen des Pools
zpool status meldet neue Funktionen im ZFS und kann leicht und schnell mit
zpool upgrade -a
erledigt werden
Jedoch würde ich in jedem Fall empfehlen zu prüfen ob meine Notfall ISO diese Funktionen bereits unterstützt!
Für das Auslesen der Parameter von Pools, Volumes, Datasets und Snapshots gibt es den Parameter get
Bereitstellen und entfernen von Pools ohne löschen
zpool import #zeigt was es zum importieren, also bereitstellen gibt
zpool import poolname oder -a für alle importiert den Pool oder alle verfügbaren Pools
Am elegantesten importiert man den Pool über
zpool import -d /dev/disk/by-id
damit man hinterher nicht sda, sdb, sondern die Bezeichner im Status sieht
Nach der Bereitstellung würde man hier lediglich einen Mountpoint /test finden, bei TrueNAS /mnt/test. Dazu noch die Systemdatasets vom Proxmox selbst. Danach legen wir gleich mal ein Dataset namens dateisystem und ein Volume namens volume an.
Datasets werden als Ordner gemountet und / oder /mnt
Volumes findet man unter /dev/zd... und zusätzlich mit vernünftigen Namen unter /dev/zvol/tankname/....
Datasets werden mit Linuxcontainern, Backupfiles, Vorlagen oder Serverdateien bespielt
Volumes verhalten sich wie eingebaute Datenträger, jedoch virtuell. Sie stehen nach dem Import des Pools bereit und können in einer VM genutzt werden. Manipulationen an Volumes zur Vorbereitung oder Datenrettung können jedoch ebenso auf dem PVE Host vorgenommen werden
Diese Schritte übernimmt üblicherweise der Installer in der VM und sollen nur aufzeigen wie diese ZVOLs genutzt werden

Proxmox legt seine Datasets für LXC so ab
und so die ZVOLs für VMs mit KVM, hier findet man die virtuellen Disk und /dev/zvol...
Thin- und Thickprovisioning für Datasets und Volumes
Am Beispiel von Proxmox VE via GUI wird hier eine Thinprovision Festplatte für VM 301 mit 32GB und einer Standardblockgröße von 16k erzeugt. 8k sind nur bei Raid1 und 10 möglich. Hakt man den Thinprovision Haken nicht an, wird beim Erzeugen noch die Option -o refreservation=32G ergänzt. Diese macht bei ZFS mit Autosnapshots aber keinen Sinn
zfs create -s -b 16k -V 33554432k rpool/data/vm-301-disk-4
rpool/data/vm-301-disk-4 56K 1.17T 56K - #hier kein Mount sonder unter /dev/zvol/...
Bei LXC werden Datasets genutzt und der Platz via Reservierung genutzt, wobei bei der genutzten Refquota auch die Snapshotaufhebezeiten den Nettoplatz verkleinern, daher größer dimensionieren, gerne mal doppelt so groß
zfs create -o acltype=posixacl -o xattr=sa -o refquota=33554432k rpool/data/subvol-106-disk-1
rpool/data/subvol-106-disk-1 96K 32.0G 96K /rpool/data/subvol-106-disk-1 #hostzugriff möglich
Virtuelle Diskimages wie QCOW2, VMDK oder RAW-Dateien legt man üblicherweise nicht in Datasets, bestenfalls für NFS oder iSCSI Server
Snapshots
Snapshots können jederzeit erstellt oder gelöscht werden. Die Datasets und Volumes befinden sich immer in einem Livezustand der sich durch die Vektorkette der eventuell vorhandenen Snapshots ergibt. Entfernt man einen Snapshot, so verändert sich der Weg der Vektoren. Das Ganze geschieht fast ohne Last!
ZFS selbst bringt weder Workflows für Snapshotting, noch Replikationen mit. Es stellt nur die Werkzeuge bereit
Snapshots generiert man bei Proxmox offiziell mit der GUI manuell oder für Replikationen, jedoch leistet dieser Workflow nicht genug.
Daher nutzen wir...
apt install zfs-auto-snapshot -y
ZFS-AUTO-SNAPSHOT legt seine Verknüpfungen in alle Cronordner. Proxmox VE weiß erst mal nichts davon. Zu berücksichtigen ist hier lediglich daß wir den Pool nicht über 80% befüllen wollen. Gehen wir darüber hinaus, müssen wir in den Cronordnern die Verknüpfungen anpassen um die Aufhebezeiten zu reduzieren.
nano /etc/crontab #kann angepasst werden, die viertelstündlichen finden sich unter cron.d!
# .---------------- minute (0 - 59)
# | .------------- hour (0 - 23)
# | | .---------- day of month (1 - 31)
# | | | .------- month (1 - 12) OR jan,feb,mar,apr ...
# | | | | .---- day of week (0 - 6) (Sunday=0 or 7) OR sun,mon,tue,wed,thu,fri,sat
# | | | | |
# * * * * * user-name command to be executed
17 * * * * root cd / && run-parts --report /etc/cron.hourly
25 6 * * * root test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.daily; }
47 6 * * 7 root test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.weekly; }
52 6 1 * * root test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.monthly; }
cat /etc/cron.hourly/zfs-auto-snapshot
exec zfs-auto-snapshot --quiet --syslog --label=hourly --keep=96 // #also in dem Fall 96 Stunden
Wir empfehlen für den Start folgende Settings: Drei Monate, sechs Wochen, zehn Tage, 96h und 12 Viertelstunden
Damit kommt man auf ca. 2,5x- 3x so viele Daten wie belegt wären ohne Snapshots. Erfahrungswert.
Das wären pro virtueller Disk oder LXC Mountpoint etwa 127 Snaphots, bei 20 Disks über 2540.
Nicht davon abschrecken lassen, es geht auch easy fünfstellig, wenn die IO stimmt!
Die in PVE eingebaute Snapshotfunktion sollte nicht mit den Autosnapshots kombiniert werden.
Im Problemfall stoppen wir die VM, manipulieren was zu machen ist und starten sie wieder!
Der eigentliche Vorteil der Snapshots in der GUI ist die Notierung der VM Definition zur Zeit der Erstellung, was wir über ein Backup im hauseigenen Postinstaller kompensieren. Dort findet man die Historie der PVE Config
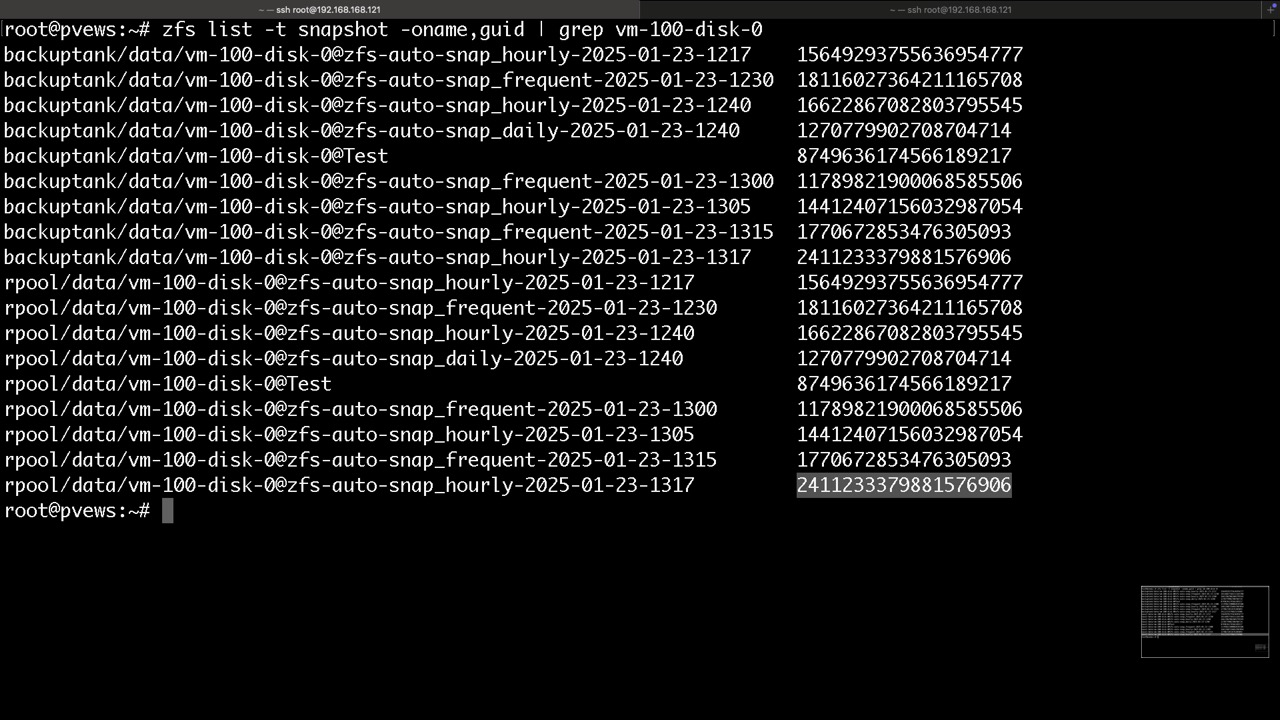
Kleines manuelles Beispiel, was für uns aber Z-A-S übernimmt
Snapshot
zfs snapshot tank/sub/datasetodervolume@snapshotname
Auflisten
zfs list -t snapshot tank/sub/datasetodervolume
VM oder LXC ausmachen
Rollback
zfs rollback -r rpool/data/vm-100-disk-0@Test #danach ist alles neuere weg!
VM oder LXC starten
Dynamik von Snapshots
Wir unterscheiden zwei Sorten von Datennutzung
- Zunehmende Datennutzung wie bei einem NAS
- Es kommt nur was dazu und wird selten gelöscht
- Viele Snapshots auf lange Zeit ändern nichts an der Gesamtnutzung des Pools
- Replikation außer Haus kann in kleinen Schritten passieren, da die Gesamtübertragung gleich groß ist
- Rotierende Datennutzung wie bei einem Datenbankserver
- Daten verändern sich permanent, wenig Zuwachs
- Viele Snapshots auf lange Zeit ändern brachial viel an der Gesamtnutzung des Pools
- Replikation außer Haus sollte in einem Schritt, ohne Zwischensnapshots passieren, da die Gesamtübertragung sonst ein vielfaches größer sein kann
- Nur essenzielle Wiederherstellungspunkte sollten aufgehoben werden um das System nicht unnötig zu befüllen
Dynamik von Snapshots
Dank ZFS kann man langfristig Replikationen inkrementell vornehmen, jedoch dauert die erste Replikation natürlich länger, wenn schon Datenbestand da war
Übliche Vorgehensweise einer Datenübertragung
PC NTFS>SMB> Datei > SAMBA Server BTRFS LVM > EXT4 Datei = Konsistent? Bitrod?
Zu viele Köche verderben die Köchin
Funktion von Snapshotreplikation
Von ZFS zu Datei, was wenig Praxis findet
zfs send tank/dataset@snapshot > datei.zfs
zfs recv tank < datei.zfs
Von ZFS zu ZFS, was üblich ist
zfs send | zfs recv #laufen immer gleichzeitig
zfs send rpool/data/vm-100-disk-0@Test | zfs recv -dvF backuptank
#überträgt den Zustand Test auf ein lokalen weiteren Pool, wobei das zfs Tool immer doppelt läuft
Pushreplikation
zfs send -pvwRI rpool/data/vm-100-disk-0@Test rpool/data/vm-100-disk-0@zfs-auto-snap_hourly-2025-01-23-1317 | zfs recv -dvF backuptank
#Fortschritt, Infos, Rohdaten plus Historie, ideal für verschlüsselte Volumes, erspart das De- und Komprimieren
Workflow
- Erzeugen eines Datasets oder Volumes
- Snapshot auf Dataset oder Volume ausführen
- Übertragung des Snapshotzustands auf Ziel, optional mit Zwischenständen
Trojanerproblem: Wer auf Quelle sitzt kann Pushziele löschen
Lösung: Pullreplikation, ähnlich Backupsoftware, Transport SSH, Daten ZFS
Quelle |> Pullserver
zfs recv | ssh root@quelle zfs send #Pull Replikation via SSH
Von PVE zu PVE, was uns zu wenig ist
Proxmox baut selbst keine Notfallpunkte auf und nutzt ZFS nur als Transport, nimmt jedoch manuelle und automatisierte Snapshots mit, auch von Z-A-S!
Weitere Kopien per ZFS sind nur per Pushverfahren möglich, was ideal für Angreifer ist wenn sie alles löschen möchten. Ein Backupserver ist hier unverzichtbar, bei Pullreplikation gehts ggf. auch ohne. Außer Haus ist es nicht möglich ein ZFS Replikat zu senden, da sich der Partner im lokalen Cluster befinden muss!
Nondestruktiver Rollback nach Trojanerbefallt bei Forensikbedarf
Proxmox
Die Dokumentation für "Proxmox Produktiv mit ZFS betreiben" basiert auf einem kostenpflichtigen Kurs und soll dessen Inhalte wiedergeben, kann aber nicht die Betreuung und Beantwortung von Fragen, wie sie der Besuch des Kurses bietet, ersetzen. Es soll das Wissen von den hauptberuflichen Sysops Admins an Interessierte weitergegeben werden, die es danach auf den von Ihnen betreuten Systemen umsetzen können.
https://cloudistboese.de - Das Schulungsportal von sysops.tv
Proxmox VE - Alternative zu vSphere und Hyper-V mit Support aus Deutschland und Österreich
Was ist Proxmox VE
- Proxmox VE ist eine Gesamtlösung zur Virtualisierung
- Einsatzbereiche Standalone bis Cluster
- Es beinhaltet entscheidende Storagefunktionen mit ZFS und Ceph
- Umfangreiche Virtualisierung und Containering Lösung
- Moderner Unterbau mit aktuellem Debian Linux
- Reichhaltige Funktionen die durch eigene Kommandozeilenlösungen erweitert werden
Wo sind die Grenzen von Proxmox VE
- Kaum bis keine Funktionen in der GUI für Storage Steuerung und Monitoring
- Viele Funktionen lassen sich nur per Kommandozeile ausführen
- Es gibt keine Möglichkeit ein defektes System per Installation zu reparieren, Reparaturkenntnisse müssen vorhanden sein
- Das Eigenmonitoring ist so gut wie nicht vorhanden. Defekte Replikationen, Raids oder Datenträger nur mühsam feststellbar
Weitere Funktionen, die eher weniger Sinn machen
- SAN mit iSCSI (keine GUI)
- SAN mit NFS (beste Option)
- Hardware Raid mit LVM (kein Vorteil zu ZFS / CEPH)
- Multipath nur per manueller Konfiguration
Indikation für Einsatz
- Kleinere Anzahl von PVE Systemen mit direkt angeschlossenen Datenträgern (kein Hardware Raid!)
- Hoher Bedarf an Reparatur durch Snapshots (tausende Snapshots kein Problem)
- Leichte Replikation der Daten auf zweites System und eventuelle weitere Ziele (mit Bashclub Tools und GUI möglich, Pull Replikation nur mit unseren Tools)
- Hauseigene Datensicherungslösung auf Hypervisor Ebene
- Eigenes Monitoring und Reporting bevorzugt - Zentrales Monitoring wie Check_MK ist zwingend notwendig
** Bei Proxmox kommt alles aus den Kernel (ZFS, Ceph, LXC, KVM, uvm.) **
Linux Kommandos die man kennen sollte
- lsblk #zeigt Datenträger und Partitionen an
- ls -althr /dev/disk/by-id # zeigt Festplatten Aliase zum eindeutigen Zuweisen von Raids an
- ls -althr /sys/class/net #zeigt aktuelle Netzwerkkarten an
- ls -althr /dev/zvol/rpool/data # zeigt ZVOL Namenszuordnungen zu /dev/zdxxx an
- dmesg -Tw #zeigt Hardwareänderungen wie Diskwechsel oder Netzwerkkabel stecken live an
- systemctl --failed #zeigt hängende dienste an
- htop #zeigt load an. hier sollten die drei Zahlen unter der Anzahl der logischen Kerne sein. Also 16 Kerne, Load unter 16. Erste Zahl letze Minute, zweite Zahl letze fünf Minuten, dritte für letzte Viertelstunde
- zpool list # hier muss der Wert Cap unter 80% liegen, sonst müssen Snapshots oder sogar produktive Daten gelöscht werden
- zpool status #Raid Status
- zfs list -t snapshot #z. B. mit -oname,written,creation rpool/data/vm-100-disk-1
- qm stop 100 && zfs rollback rpool/data/subvol-100-disk-0@zfs-auto-snap_hourly-2024-10-24-0217 && qm start 100 # Rollback ohne Widerkehr der Daten einer VM
Proxmox Installation
Um Proxmox mit ZFS nutzen zu können, müssen die Platten direkt an Proxmox angebunden werden. Es sollte kein RAID Controller mit RAID 0 genutzt werden, da dies früher oder später zu Problemen und Datenverlusten führen wird! Damit auch eine Update von Promox 7.x auf 8.x gezeigt werden kann, wird im Kurs mit der Installation einer Proxmox Version 7.x begonnen und später auf 8 aktualisiert. Das Postinstall Script aus dem Bashclub wird installiert, um auch alle benötigten Tools für die tägliche Arbeit und im Problemfall im Zugriff zu haben. (z.B. ohne ein Netzwerkverbindung kann nichts mehr nachinstalliert werden)
Spickzettel für Installation
- Kein RAID Controller
- Platten direkt an Proxmox geben, es müssen die Herstellerbezeichnung der Platten im Linux Betriebssystem sichtbar sein. (z.B. nvme-INTEL_... über das Kommando
ls /dev/disk/by-id) - ISO Installation mit Version 7.x
- Install Proxmox starten
- Die Standardauswahl im Installer würde LVM auf eine Disk installieren, was nur für Hardware Raid Sinn machen würde
- ZFS RAID 1 oder ZFS RAID 10 sind die empholenen Level für die Beste Leistung, haben jedoch einen Platzverlust von 50%, was in der Natur liegt
- Advanced Options - ZFS Optionen können default gelassen werden, ashift=12 + compression=on passt für alle Platten über 2TB
- Passwort muss sich in der HTML Console gut tippen lassen - HTML und JAVA Konsolen sind hier sehr schwierig mit deutsch Tastatur! Testen!
- Die Installation mit sorgfältig gewählten Namen und IP Adressen durchführen
- Install Proxmox starten
Proxmox GUI Zugriff
-
Im Browser: https://<ip>:8006
- Single PAM - ssh login # Benutzer auf Linux Ebene und PVE GUI
- Proxmox VE - Weboberfläche Cluster User
-
Proxmox CLI gegen root SSH Zugriff schützen (macht auch das SSH Hardening unseres Postinstallers)
-
/etc/ssh/.sshd_config
- PermitRootLogin without-password
- service sshd reload
Proxmox GUI
-
TOTP (time-based one-time password) kann über die Proxmox GUI gesetzt werden
- Datacenter - Permissions - Two Factor
- Selbst bei kompromitierem Passwort kann kein Dritter zugreifen!
- Für PAM und PVE User möglich
Update nach Proxmox 8.x - Für Einsteiger am einfachsten bei Erstinstallation zu üben
Das Pre-Upgrade Check Script pve7to8 sollte ausgeführt werden, um mögliche Probleme vor dem Upgrade erkennen zu können. Erstmal ohne Parameter und anschließend mit Parameter (--full: alle Checks).
** Für das Upgrade muss entweder eine Subskription erorben werden. Alternativ kann man auch das Enterprise Repository deaktivieren und das No-Subkription Repository aktivieren. Nur so erhält man Proxmox Updates!!! Ohne diese Auswahl kommen nur Debian Security Fixes!!!
Hier der Stand Version 7 zu 8
-
pve7to8 -
ve7to8 -- full
Wir empfehlen die VMs und Container zu stoppen und einen zeitnahen Reboot - Der neue Kernel passend zur GUI kann nur so aktiviert werden
apt update apt dist-upgrade pveversion
Letzte Version PVE 7 sollte nun installiert sein, kein Reboot notwendig hier
Upgradeprozedur bei Standardsystem
sed -i 's/bullseye/bookworm/g' /etc/apt/sources.list # ändert alle Repositories von Bullseye (Debian 11) zu Bookworm (Debian 12)
Enterprise Repo anpassen
echo "deb https://enterprise.proxmox.com/debian/pve bookworm pve-enterprise" > /etc/apt/sources.list.d/pve-enterprise.list
Debian update
screen # falls etwas schief geht kann man mit screen -r zurück zur Sitzung apt update apt dist-upgrade #sollte hier mehrere hundert Aktualisierungen ankündigen
Während des Upgrades sollte man alles mit N beantworten und den Diensteneustarts zustimmen. Es kommt ggf. auch ein Textdokument was mit w zu verlassen ist
Unser Postinstaller sorgt in kürzester Zeit für alle notwendigen Sicherheits- und Komforfunktionen für den Notfall
Postinstall aus bashclub (proxmox-zfs-postinstall) auf github
-
Bashclub Postinstaller Proxmox
- ZFS L1ARC Size wird von PVE nur lieblos berechnet, empfohlen sind 1GB RAM für 1TB netto Datastore als first Level Cache
- Swappiness auf 10 Prozent oder kleiner, damit PVE nicht zu früh auslagert, jedoch am besten nicht den RAM überprovisioneieren!
- ZFS auto snapshots - die Werte können frei konfiguriert werden. Empfehlung für den Start (PVE weiß nichts davon!)
- monthly: 3
- weekly: 6
- daily: 10
- frequent: 12
- hourly: 96 --> wegen Weihnachten und Ostern
- Repo
- No Subscription auswählen, falls keine Subskription vorhanden
Wir sichern extra die /etc Ordner nach rpool/pveconf, da der Ordner /etc/pve aus einer Datenbank live erstellt wird. Er wäre bei einer Reparatur via Boot ISO leer!!!
Die ZFS auto Snapshots werden über die crontab ausgeführt. Dafür gibt es verschiedene Verzeichnisse:
- /etc/cron.hourly
- /etc/cron.daily
- /etc/cron.weekly
- /etc/cron.monthly
- /etc/cron.d (viertelstündlich)
In den Ordner liegt dann für jede "Aufgabe" ein eigene Datei (z.B. zfs-auto-snapshot), in welcher die auszuführen Kommandos enthalten sind. Dort ist auch hinterlegt wieviele auto snapshots aufgehoben werden sollenn. (--keep=96)
Die Zeitpunkte wann dieses ausgeführt werden sind in der Datei
/etc/crontabdefiniert. z. B. könnte dort der tägliche Zeitpunkt angepasst werden
Ebenfalls finden sich Skripte ab Werk unter /etc/cron.d für z. B. Scrubbing und Trimming am Sonntag. Nicht jedem taugt dieser Zeitpunkt!
cat /etc/crontab
# /etc/crontab: system-wide crontab
# Unlike any other crontab you don't have to run the `crontab'
# command to install the new version when you edit this file
# and files in /etc/cron.d. These files also have username fields,
# that none of the other crontabs do.
SHELL=/bin/sh
PATH=/usr/local/sbin:/usr/local/bin:/sbin:/bin:/usr/sbin:/usr/bin
# Example of job definition:
# .---------------- minute (0 - 59)
# | .------------- hour (0 - 23)
# | | .---------- day of month (1 - 31)
# | | | .------- month (1 - 12) OR jan,feb,mar,apr ...
# | | | | .---- day of week (0 - 6) (Sunday=0 or 7) OR sun,mon,tue,wed,thu,fri,sat
# | | | | |
# * * * * * user-name command to be executed
17 * * * * root cd / && run-parts --report /etc/cron.hourly
25 6 * * * root test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.daily; }
47 6 * * 7 root test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.weekly; }
52 6 1 * * root test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.monthly; }
#
Zusätzlich gibt es für jeden User (z.B. root) noch eine eigene crontab, diese liegen unter cd /var/spool/cron/crontabs/. Dort gibt es dann eine Datei root für den User root, falls diese erzeugt wurde. Diese Datei wird z.B. auf den Linux VMs genutzt, um das Trimming zeitgesteuert ausgeführen zu können.
proxmox-boot-tool / ZFS Feature Upgrade / Trimming einschalten
Mit dem
promox-boot-toolkönnten Platten nach einen Hardwaretausch wieder bootfähig gemacht werden. Heute sollte nach Möglichkeit uefi Boot eingesetzt werden und nicht mehr legacy Boot, damit werden die Boot Platten automatisch erkannt und müssen nicht einzeln durch probiert werden, wie bei legacy boot. Autotrim sollte auf den SSD ZFS Datasets eingeschaltet sein, damit gelöschte Blöcke wieder im Dateisystem schnell verfügbar gemacht werden.
Optionale Funktionen zur ZFS Storage Optimierung
- zpool set autotrim=on rpool # für SSD Pools
- zpool set autoexpand=on rpool #vor Plattentausch auf größere Disks
- zpool upgrade #regelmäßig prüfen ob hier bei zpool status ein Hinweis ist. Der aktuelle PVE ISO Installer muss aber mit der Version bestückt sein, daher ggf. immer eine Version abwarten
- zpool trim rpool #test ob Trimming das System ausbremst
- zpool iostat -v 1 # Live Status
Einige wichtige Ordner vom Proxmox:
- Proxmox Konfiguration unter /etc/pve #Wie bereits oben erwähnt wird dieser Ordner nur zur Laufzeit von PVE aktiviert und ist bei einer Wiederherstellung per ISO leer! Daher unser Backup unter rpool/pveconf
- Template Ordner /var/lib/vz
- ISO Ablage Ordner /var/lib/vz/template/iso - z.B. virtio-win.iso
- Cache /var/lib/vz/cache/ z.B. *.tar.gz Proxmox Mailgateway
PVE startet noch, hat aber defekte Installation oder Konfiguration - Rollback vom Debian mit PVE
Wenn der Proxmox nicht mehr richtig funktioniert, werden die folgenden Schritte durchgeführt, um ihn wieder herzustellen zu können. Die erforderlichen ZFS snapshots werden durch die "Tools" des Postinstaller erzeugt.
Beim PVE Ordner (/etc/pve) handelt es sich um eine Datenbank (/dev/fuse 128M 20K 128M 1% /etc/pve), die ohne den Postinstaller nicht gesichert würden (rpool/pveconf 884G 128K 884G 1% /rpool/pveconf).
Daher sollte der Postinstaller aus dem Bashclub auf jeden Promox PVE installiert sein, damit die Konfigurationsverzeichnisse von Proxmox auf ZFS gesichert und mit Auto Snapshosts versehen werden !!!
-
Proxmox CD bzw. ISO booten - Debug auswählen
-
exit - damit nicht der Installer bootet zpool status zpool import # zeigt ob der Pool komplett und fehlerfrei ist, könnte ja ein Hardware Problem sein zpool import rpool # würde wegen letztem Zugriff durch Fremdsystem nicht reichen zpool import -f rpool zpool status zpool list zfs list -t snapshot rpool/ROOT/pve-1 Dann z. B. auf funktionierenden Stand zurückrollen... zfs rollback -r rpool/ROOT/pve-1@zfs-auto-snap.hourly\_2023-09-26-1251 # entsprechender snapshot - boot und Proxmox geht wieder ``` Reboot oder Reset Server
**Sollte der Rollback Punkt z. B. auf einen Punkt von PVE 7 zeigen, so kann man beim Booten einen älteren Kernel auswählen
Nach erfolgreichem Neustart empfehle ich
- proxmox-boot-tool refresh
- apt update
- apt dist-upgrade
- reboot als Test
Installation Windows mit VirtIO Treiber
** Inzwischen installiert der Postinstaller einmalig eine aktuelle Virtio Treiber ISO als stabile Version - Für spätere Downloads...**
-
VirtIO Treiber im Internet finden
- Proxmox Windows Driver im Browser suchen
-
Auf Proxmox Seite nach Stable suchen
- Link kopieren
- In ProxMox GUI
- Download URL eintragen unter pvews - local (pvews) - ISO Images
- Filename: VirtIO-win.iso
- ISO Ablage Ordner **/var/lib/vz/**template/iso
- Download URL eintragen unter pvews - local (pvews) - ISO Images
-
Create VM
- General
- Node: pvews
- VM ID: 101
- Name: win
- Start at boot: Haken
- OS
- Use CD/DVD disc image file (iso)
- Storage: local
- ISO Image: Win10_22H2_German_x64.iso
- Use CD/DVD disc image file (iso)
- System
- Maschine q35 # nicht i440fx
- BIOS: OVMF (UEFI)
- Add EFI Disk: Haken
- Emu Agent Haken
- EFI Storage: local-zfs
- SCSI Controller: VirtIO SCSI Single # Achtung bei Hotplug weiterer Platten muss im Geräte Manager der neue Controller gefunden werden oder Reboot!
- Disks
- Bus/Device: SCSI 0
- VirtIO Block ist obsolet !!!
- SCSI - VirtIO SCSI Single - steht auf der Seite davor - SCSI Contoller kann ein Prozessorkern pro Festplatte exklusiv nutzen
- Discard: Haken # für Trimming der VM
- SSD emulation: # Haken für Trimming
- Cache: - Default (no cache) - keine Cache einschalten !!!
- Bus/Device: SCSI 0
- CPU
- Socket: 1
- Cores: 4 # relativer Wert zu anderen VMs
- Type: Host (Standard: x64-64-v2-AES) # mit Host wird die CPU 1:1 abgebildet, AES und Co. reduzieren den Funktionsumfang der virtuellen CPU, erhöhen aber die Kompatibilität bei Migration zwischen nur ähnlichen PVE Hosts
- Memory
- Memory: 4096
- Network
- Bridge: vmbr0
- Model VirtIO (paravirtualized) - kann mehr wie 1Gbit, 100Gbit möglich
- General
Inzwischen kann man die geladene virtio.iso als zweites Laufwerk in die VM einklinken
q35 Version 5.2 - weniger Probleme als mit Version 8.0 wegen deutschen Treibern - ist für US optimiert ... - Probleme mit Netzwerkkarten möglich
EFI hat feste Bildschirmauflösung - kann nur im EFI der VM eingestellt werden (EFI BIOS) - Im Bootvorgang in der Console (Proxmox GUI) - ESC drücken
Während der Installation am einfachsten nur die VIOSCSI Treiber installieren, da sonst keine Disks angeboten werden Den Rest des Setups von der VIRTIO ISO kann nach der Installation erledigt werden. Das spart die dummen Sicherheitsfragen und geht schneller.
Am Ende sollte auf der VM Statusseite die IP Adresse zu sehen sein, ansonsten noch prüfen ob der Haken bei Guest Agent an ist!
Für alle die von den APPS genervt sind etwas lustiges zum nachbasteln
Get-appxPackage | Remove-appxPackage # man verliert Taschenrechner - alle App werden entfernt - auch der Storage wird entfernt - Nach Feature Update wieder alles da
**Windows installiert am Ende des Setups eine Wiederherstellungspartition. Diese ist eventuell zu entfernen, da ansonsten kein Resize möglich ist. Der Resize ist auf der Disk in PVE jederzeit möglich
** Windows ist inzwischen in der Lage freie Blöcke an ZFS zurückzugeben, für den Fall daß wie beschreiben SCSI Single + SSD Emulation plus Discard gewählt wurde**
Optional noch Hilbernation Mode aus
-
attrib powercfg -h off # evtl. darf es der User nicht - powershell als administrator starten
Unser Datastore Swap kann genutzt werden um die Auslagerungsdatei auf eine eigene Disk zu legen. Das spart bei ramhungrigen Systemen viel Platz, da dort keine automatischen Snapshots ausgeführt werden. Die Platte muss nicht gesichert werden. Bei Linux bitte die Swap Disks mit Backup einmal sichern
Trimming unter Linux
-
Unter Linux wird nicht mehr benötigter Storage einer SDD wie folgt an ZFS freigeben
- Linux
/sbin/fstrim -av# für Linux VM, nicht LXC!
- Linux
-
Eine automatisierte Freigabe von nicht mehr benötigtem Storage, kann über die crontab in Linux gesteuert werden
- crontab -e # crontab für den User root
- 5 * * * * /sbin/fstrim -a # Der crontab Eintrag bedeutet, daß jede fünfte Minute der vollen Stunde getrimmt wird
- crontab -e # crontab für den User root
fstrim -av # muss eine Ausgabe bringen - sonst ist die VM falsch konfiguriert - VM Platten auf SSD und Discard umstellen
Festplatten Tausch bei Defekt oder S.M.A.R.T Fehler
- Artikel von ProMox - ist nicht ganz korrekt: https://pve.proxmox.com/wiki/ZFS_on_Linux
Es reicht nicht mit zpool replace eine fehlende oder defekte Disk zu ersetzen. Sie könnte danach nicht booten. Wir benötigen ebenfalls zwei Partitionen mit dem Bootimage!
Der Fall beschreibt den Tausch optional gleich gegen eine größere Festplatte oder SSD
Erklärung zum Kommando sgdisk ... -- R ...
-
sgdisk \<gutes boot device\> - R \<neue Platte\># Partitionen werden kopiert und die GUID wird beibehalten - Soll eine neue GUID verwendet werden
sgdisk -G \<neue Platte\>
dmesg -Tw
Platte einbauen und Output prüfen, sdf ist neue Disk
zpool set autoexpand=on rpool # Erweiterung des Pools erfolgt am Ende automatisch! Bei Raid 10 reicht es zwei Disks zu Tauschen, bei RaidZx müssen allte getauscht werden um den Platz zu erweitern!
ls -althr /dev/disk/by-id | grep sdf (sdf wurde als neue Disk erkannt)
zpool status
Output zeigt aktive oder defekte Disks
rpool ONLINE 0 0 0
mirror-0 ONLINE 0 0 0
ata-INTEL_SSDSC2KB019T8_PHYF951101ZS1P9DGN-part3 ONLINE 0 0 0
ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3 ONLINE 0 0 33
Wir tauschen nun die zweite Disk vorsorglich
-part3 zeigt deutlich daß es sich hier um die dritte Partion handelt die ersetzt werden muss, folglich sind Parition 1 und 2 zum booten!!!
ls -althr /dev/disk/by-id | grep ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3
lrwxrwxrwx 1 root root 10 Oct 15 17:38 ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3 -> ../../sdb3
Wir müssen also sdb3 ersetzen
Als erstes Paritionstabelle übernehmen und erweitern, falls größere Disk
sgdisk /dev/sdb -R /dev/sdf #sdb ist eine gute Disk, sdf die neue Disk
sgdisk -G /dev/sdf # neue GUID damit EFI die Disk unterscheiden kann
proxmox-boot-tool format /dev/sdf2 #format mit fat32
proxmox-boot-tool init /dev/sdf2 #kopiert Bootimage und notiert die Disk für künftige Updates
Optional
cfdisk /dev/sda # Partition vergrößern
** Beim nächsten sgdisk der Paritionstabelle einfach die große Disk als Vorlage nehmen
Jetzt den eigentlichen Datenbestand ersetzen
ls -althr /dev/disk/by-id | grep sdf | grep part3
zpool replace rpool ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3 ata-INTEL_SSDSC2KB019T8_PHYF95111111PXXX-part3
** Kontrolle des Erfolgs mit
zpool status # da soll dann die alte Disk raus sein und keine Fehler
zpool list # eventuell mehr freier Speicher nach Austausch von zwei Disks oder mehr
proxmox-boot-tool status #sollte zwei Treffer und einen Fehler melden, wegen gezogener defekter Disk
proxmox-boot-tool clean entfernt tote Bootdatenträger
Windows kaputt machen - Trojanersimulation
- Netwerkkarte disablen durch Trojaner
- VM herunterfahren
- Entwicklung der Größe der snapshot‘s - als Indikator
- Trojaner verursacht eine größere Änderung in den snapshots
- Rollback snapshot über Cockpit oder über command Line
ZFS Cache
- Parameter -n: dry-run
- erstmal anschauen, was das Kommando machen würde
zpool add -n rpool cache ata-intense..
zpool add -nf rpool cache ata-intense.. # wenn schon Daten auf der Platte
zpool add -f rpool cache ata-intense..
zpool iostat -v 3
zpool iostat -v 1 # 1 sec
Das Wort "cache" im Kommando ist sehr wichtig, da sonst die Platte evt. als einzel Mirror an den stehenden Mirror angehängt wird und das wollen wir nicht, daher immer mit -n testen !!!
Proxmox Cluster
-
GUI - Cluster - create cluster
-
pvecm create „clustername“
-
GUI - Cluster - „add Cluster“
-
pvecm add clusterserver1
-
Kein Cluster mehr
-
https://pve.proxmox.com/wiki/Cluster_Manager#_remove_a_cluster_node
-
Auf der Seite zu den folgendem Punkt springen: First, stop the corosync and pve-cluster services on the node:◦
-
cd /etc/pve
-
storage.cfg
-
qemu-server/*.conf
-
lxc/*.conf
-
nodes/... # Ordner mit den Cluster Member
-
top ps aux ps aux | grep qm # Herstellung aller Maschinen anhand dieser Ausgabe -
Login in den Cluster funktioniert nach dem Fehlschlag nicht mehr
service pveproxy restart
- Neues Zertifikat - zwei Faktor Authentification der lokal User fliegt heraus
cd /rpool/pveconf
zfs list -t snapshot rpool/ROOT/pve-1
- PVE Config zurück rollen
zfs rollback -r rpool/ROOT/pve-1@zfs-auto-snap_hourly-2023-09-28-1017 # panic Variante und Stromkabel nach 2 s
-
besser von cd booten, rollback wie oben
-
Ordner .zfs unter /rpool/pveconf
-
cd snapshot # dieser Ordner nur in datasets vorhanden # Snapshot Order auswählen cd zfs-auto-snap_hourly-2023-09-28-0717 cd etc/pve/nodes/pvews cd lxc ls cp 100.conf /etc/pve/lxc cd .. cd qemu-server cp 101.conf /etc/pve/qemu-server # evtl. Alternativ cp 101.conf /etc/pve/nodes/pvews/qemu-server vi /etc/pve/nodes/pvews/qemu-server/101.conf # Anpassung von Namen -
Boot Partitionen löschen
- Über dd
dd if=/dev/zero of=/dev/sda2 bs=1M count=511
dd if=/dev/zero of=/dev/sdd2 bs=1M count=511
proxmox-boot-tool status
-
Boot über CD/DVD - Advanced - debug mode console
-
Type exit - damit Installer nicht startet
-
https://pve.proxmox.com/wiki/ZFS:_Switch_Legacy-Boot_to_Proxmox_Boot_Tool
-
Aus der Webseite:
- Repairing a System Stuck in the GRUB Rescue Shell
-
If you end up with a system stuck in the grub rescue> shell, the following steps should make it bootable again:
-
Boot using a Proxmox VE version 6.4 or newer ISO
-
Select Install Proxmox VE (Debug Mode)
-
Exit the first debug shell by typing Ctrl + D or
exit -
The second debug shell contains all the necessary binaries for the following steps
-
Import the root pool (usually named rpool) with an alternative mountpoint of /mnt:
-
zpool import -f -R /mnt rpool zfs list -
Find the partition to use for proxmox-boot-tool, following the instructions from Finding potential ESPs
-
Bind-mount all virtual filesystems needed for running proxmox-boot-tool:
-
mount -o rbind /proc /mnt/proc
-
mount -o rbind /sys /mnt/sys
-
mount -o rbind /dev /mnt/dev
-
mount -o rbind /run /mnt/run
-
ls /mnt
-
change root into /mnt
-
chroot /mnt /bin/bash
-
- Repairing a System Stuck in the GRUB Rescue Shell
-
cat /etc/network/interfaces
- Zeigt die Netzwerk Interface Einstellungen
-
proxmox-boot-tool status lsblk proxmox-boot-tool format /dev/sdb2 proxmox-boot-tool format /dev/sdc2 proxmox-boot-tool init /dev/sdb2 proxmox-boot-tool init /dev/sdc2 proxmox-boot-tool status proxmox-boot-tool clean zpool export rpool # Falls der `zpool export` vergessen wurde, nach dem reboot `zpool import -f rpool` -
<CTRL> <ALT> <ENF> # reboot auslösen
-
zpool import -f rpool # letzter Besitzer war CD exit # erneuter reboot zpool status -
Wichtige Dateien:
- /etc/network/interfaces
- storage.cfg
- qemu-server/*.conf
- lxc/*.conf
-
Boot Partitionen löschen
- cfdisk /dev/sdb
- Partition 1 und Partition 2 löschen ◦
- fdisk /dev/sdc
- Partition 1 in Partition 2 löschen
- reboot
- cfdisk /dev/sdb
-
Proxmox neu installieren auf cache SSD ohne ZFS
-
Boot von CD
-
Install Proxmox ohne ZFS auf SSD
-
Würde mit ZFS installiert, hätten wir wieder ein rpool und müssten den original Pool rpool in z.B. rpool1 umbenennen und local-zfs anpassen !!!!
-
Profi Tipp: Alle anderen Platten ziehen, damit auf keiner falschen Platten installiert wird
-
Installation mit ext4 mit lvm
-
Neues Zertifikat
-
Passwort neu
-
ssh meckert wegen known_hosts # Neu Installation
-
zfs list # zeigt leere Liste zpool import -fa # alle importieren zfs list # rpool ist wieder da cd /rpool/pveconf cd etc cd pve ls cp storage.cfg /etc/pve cd qemu-server cp 101.conf /etc/pve/qemu-server # Produktiv System cp *.conf /etc/pve/qemu- server cd .. cd lxc cp 100.conf /etc/pve/lxc # Produktiv System cp *.conf /etc/pve/lxc
-
-
ISO‘s als DVD heraus werfen, da vermutlich nicht gesichert
-
zpool remove rpool <cache ssd> # cache ssd entfernen # atach und detach nur mirror - alles andere wird removed
-
Am Abend wieder ganz machen
- Booten von CD/DVD
- Advanced Mode - Debug mode
-
Partitionstabelle wiederherstellen
-
Anderen Proxmox anschauen
-
https://pve.proxmox.com/wiki/ZFS:_Switch_Legacy-Boot_to_Proxmox_Boot_Tool
-
Repairing a System Stuck in the GRUB Rescue Shell
-
zpool import -f -R /mnt rpool zfs list -
Find the partition to use for proxmox-boot-tool, following the instructions from Finding potential ESPs
-
Bind-mount all virtual filesystems needed for running proxmox-boot-tool:
-
mount -o rbind /proc /mnt/proc mount -o rbind /sys /mnt/sys mount -o rbind /dev /mnt/dev mount -o rbind /run /mnt/run chroot /mnt /bin/bash # Partitionstabelle eines anderen ProxMox Systems anschauen sgdisk /dev/sdd -R /dev/sdb # muss resized werden cfdisk /dev/sdb -
Partition 3 wieder vergrößern # Werte überprüfen mit Foto falls vorhanden
-
sgdisk /dev/sdb -R /dev/sdc sgdisk -G /dev/sdb sgdisk -G /dev/sdc -
Änderungen haben nicht gegriffen - reboot erforderlich # alternativ parted - partprobe bekommt das im laufenden Betrieb hin
-
Reboot
-
Evtl. mit
proxmox-boot-toolPartitionen wieder herstellen, zuvor muss die Proxmox Umgebung über die chroot Umgebung gebaut werden ... -
reboot zpool import -fa exit # reboot vom ProxMox zpool status proxmox-boot-tool status
-
-
-
-
-
Variante für das Arbeiten
- Externe SSD - True NAS installieren - geht aber nur für VM‘s - VM‘s per SCSI freigeben
-
Backup Proxmox Datenbank - Wie funktioniert das ?
-
cat /etc/cron.d/pve-conf-backup-
rsync. -va --delete /etc /rpool/pveconf# alle 15 min - ab 3. Minute
-
-
Import Daten
-
vmdk vhdx raw qcow2 > mounten vom original (VM aus!) /mnt/pve/nfsstore oder smbshare
-
zvol / lvm / usb / hdd /ssd
-
qm importdisk 100 /mnt/hypervfreigabe/dc.vhdx local-zfs# (via samba) -
qm importdisk 100 /mnt/pve/nfsstore/vmfs/id/dc/dc.vmdk local-zfs #(via NFS oder SSHFS) -
Echte Systeme (physikalische Server)
-
Clonezilla
-
https://pve.proxmox.com/wiki/Migration_of_servers_to_Proxmox_VE
- Clonezilla Live CDs
-
Disks erscheinen erst mal unused - mit Doppelklick hinzufügen und booten
-
-
Backup und Monitoring
- Backup Dataset dürfen keine auto snapshots machen
-
zfs set com.sun:auto-snapshot=false backup# siehe Codeblock
-
zfs list # Ziel Backup Disk - Pool Backup
zfs create backup/repl -o com.sun:auto-snapshot=false
zfs set com.sun:auto-snapshot=false backup
bash-club-zfs-push-pull # auf Ziel ausführen
- bashclub zfs-push-pull installieren
git clone https://github.com/bashclub/bashclub-zfs-push-pull.git
cd bashclub-zfs-push-pull
chmod +x 02pull
bashclub-zfs
cp bashclub-zfs /usr/bin
vi 02pull # Anpassen - In for Schleife ein echo zum Testen
bashclub-zfs # Parameter I und R - alte Snapshot und Zwischen-snapshots mitnehmen # Prinzipiell pull !!! - Quelle kommt nicht auf das Ziel, sondern nur Ziel kommt auf Quelle
cp 02pull /etc/cron.hourly
Für Trojaner sicher immer die "pull Methode" anwenden. Nur Ziel kommt auf die Quelle und nicht umgekehrt.
Monitoring
- ID: backup-repl
- ZFS Pool: backup/repl
- Thin provision: Haken
- Block Size: 16k
- https://github.com/bashclub/check-zfs-replication
wget -O /usr/local/bin/checkzfs https://raw.githubusercontent.com/bashclub/check-zfs-replication/main/checkzfs.py
chmod +x /usr/local/bin/checkzfs
checkzfs --sourceonly
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90 --columns +message
-
wget -O /usr/local/bin/checkzfs https://raw.githubusercontent.com/bashclub/check-zfs-replication/main/checkzfs.py-
Keep: Hours 96, dayly 14
-
ProxMox GUI
- Storage - Add ZFS
-
cd /etc/pve/qemu-server cp 101.conf 9101.conf vi 9101.conf -
Kommando im vi ausführen - local-zfs durch backup-repl ersetzen
- :%s/local-zfs/backup-repl/g # vi command
-
Swap entfernen
-
DVD Laufwerke entfernen
-
Name am Anfang repl- anfügen
-
- GUI der VM 9101
- Netzwerkkarte deaktivieren # Befehl kann man nachher in der conf nachschauen
- Autostart disablen
- VM 9101 starten # aber Replikationszeit beachten - cron.hourly
- LXC Container kann mittlerweile die Netzwerkkarte deaktivieren - alternativ in anderen vswitch
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90 --columns +message --output checkmk
# Datei generieren und auf anderen Server kopieren - über scp
zfs mount -a
ls /backup/repl/subvol-100-disk-0/etc/pmg
mkdir /mnt/restore
mount /dev/zvol/backup/repl/vm-101-disk-1-part3 /mnt/restore
ls /mnt/restore # Damit kann man Daten aus dem Windows zurückspielen
umount /mnt/restore
zfs create backup/klon -o com.sun:auto-snapshot=false
zfs list -t snapshot backup/repl/vm-101-disk-1
zfs clone backup/repl/vm-101-disk1@bashclub-zfs_2023-09-28_16:21:30 backup/klon/vm-101-disk-1
mount /dev/zvol/backup/klon/vm-101-disk-1-part3 /mnt/restore
ls /mnt/restore
vi /etc/pve/qemu-server/9101.conf # Anpassung das der Klon verwendet wird
- VM aus Klon booten und sich anschauen ...
umount /mnt/restore
zfs get guid
zfs get guid | grep bashclub-zfs_2023-09-28_16:46:50
zfs get creation rpool/data/subvol-100-disk-0@bashclub-zfs_2023-09-28_16:46:50
-
zfs Replication für arme
-
backup/repl # pull - Trojaner sicher
zfs snapshot rpool/data/vm-100-disk-0@snap1 # snapshot auslösen
zfs send rpool/data/vm-100-disk-0@snap1 | zfs recv -dvF backup/repl # local
zfs send rpool/data/vm-100-disk-0@snap1 | ssh rot@zielip zfs recv -dvF # anderes System
- backup/repl # push - Quelle kommt auf Ziel !!! (Risiko Securtiy)
ssh root@sourceip zfs send rpool/data/vm-100-disk-0@snap1 | zfs recv -dvF backup/repl # pull
- checkzfs mit Mail - dafür muss Mail konfiguriert sein
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90 --columns+message --output mail
Verschlüsselung mit Proxmox, ZFS und Debian / Windows
Hier mal zur Überlegung was für einen Sinn macht
Physischer PC
- Festplatte
- Partition mit FS
- Mount / c:\
- Partition mit FS
Proxmox LXC
- Festplatte+Festplatte als Raid
- Dataset
- Mountpoint /rpool/data/subvol-100-disk-0
- Dataset
Proxmox LXC ZFS verschlüsselt
- Festplatte+Festplatte als Raid
- Dataset entsperrt
- Mountpoint /rpool/data/subvol-100-disk-0
- Dataset entsperrt
zfs create rpool/encrypted -o keylocation=prompt -o keyformat=passphrase -o encryption=on
#Datastore im PVE anlegen auf rpool/encrypted
nach Reboot zfs load-key #Passphrase eingeben, dann pct start xxx
Alternativ kann man das auch von außen alle Stunde auf Verdacht oder nach Prüfung per SSH auslösen
Proxmox VM
- Festplatte+Festplatte als Raid
- ZVOL
- Gast Partition mit FS
- Mount / c:\
- Gast Partition mit FS
- ZVOL
Proxmox VM ZFS verschlüsselt
- Festplatte+Festplatte als Raid
- ZVOL entsperrt
- Gast Partition mit FS
- Mount / c:\
- Gast Partition mit FS
- ZVOL entsperrt
zfs create rpool/encrypted -o keylocation=prompt -o keyformat=passphrase -o encryption=on
#Datastore im PVE anlegen auf rpool/encrypted
nach Reboot zfs load-key #Passphrase eingeben, dann qm start xxx
Alternativ kann man das auch von außen alle Stunde auf Verdacht oder nach Prüfung per SSH auslösen
Proxmox VM Gast verschlüsselt
- Festplatte+Festplatte als Raid
- ZVOL
- Volumemanager
- LV mit encrypted FS
- entsperrter Mount / c:\
- LV mit encrypted FS
Verschlüsselung wird bei der Installation vorgenommen. Nach jedem Reboot muss das Passwort in KVM Konsole von Proxmox eingegeben werden. Automatisierung nicht möglich
Abschließend ist das Ziel zu prüfen. Verschlüsselung gegen Diebstahl ist die ZFS Lösung völlig ausreichend. Replikation geht mit Raw (send -w), Backup nur wenn entsperrt ist. Eine Sicherung einer intern verschlüsselten VM ist jederzeit, mit jeder Methode (PBS, ZFS) möglich, muss halt in jeder VM vorgenommen werden, LXCs lassen sich verschlüsselt nur gegen Diebstahl schützen, nicht gegen Einsicht.