# Dokumentation

Dokumentation von den Kursen von sysops

# Dauerhafter Schutz mit ZFS Auto Snapshots

<header id="bkmrk-betriebsdokumentatio"><div class="eyebrow">Betriebsdokumentation · Proxmox &amp; ZFS</div># ZFS-Snapshots in Proxmox: Aufbewahrung und Wiederherstellung

Wie wir mit ZFS Auto Snapshot ältere Datenstände erhalten und im Notfall VMs, LXC-Container und NAS-Dateien wiederherstellen.

<nav>- [Grundlagen](#bkmrk-was-ist-ein-zfs-snap-1)
- [Aufbewahrung](#bkmrk-unsere-snapshot-aufb)
- [Auto Snapshot](#bkmrk-wie-arbeitet-zfs-aut)
- [80-%-Kontrolle](#bkmrk-mit-zpool-list-die-8)
- [SSD-TRIM](#bkmrk-warum-snapshots-auch)
- [Wiederherstellung](#bkmrk-proxmox%3A-rollback%2C-s)
- [VM klonen](#bkmrk-alle-vm-disks-nach-r)
- [Quellen](#bkmrk-weiterf%C3%BChrende-dokum)

</nav></header><main id="bkmrk-was-ist-ein-zfs-snap"><article><section id="bkmrk-was-ist-ein-zfs-snap-1">## Was ist ein ZFS-Snapshot?

Ein ZFS-Snapshot ist eine schreibgeschützte Momentaufnahme eines Dateisystems oder ZVOLs. ZFS nutzt **Copy-on-Write**: Änderungen werden in neue Blöcke geschrieben. Der Snapshot hält die Verweise auf die bisherigen Blöcke fest.

Es entsteht keine vollständige Datenkopie. Zusätzlichen Speicher benötigen vor allem ältere Blöcke, die nach Änderungen oder Löschungen nur noch für Snapshots erhalten bleiben. Unveränderte Blöcke werden gemeinsam genutzt.

### ZFS-Snapshots und VMware-Snapshots

<div class="table-wrap"><table><caption>Unterschied zur klassischen VMware-Snapshot-Technik</caption><thead><tr><th scope="col">Merkmal</th><th scope="col">ZFS</th><th scope="col">VMware vSphere / ESXi</th></tr></thead><tbody><tr><th scope="row">Ebene</th><td>Dateisystem oder ZVOL</td><td>Virtuelle Maschine</td></tr><tr><th scope="row">Verfahren</th><td>Alte Datenblöcke bleiben referenziert.</td><td>Neue Schreibzugriffe landen bei klassischen Snapshots in Delta-Dateien.</td></tr><tr><th scope="row">Arbeitsspeicher</th><td>Wird nicht erfasst.</td><td>Kann optional erfasst werden.</td></tr><tr><th scope="row">Löschen</th><td>Gibt nicht mehr benötigte Blöcke frei.</td><td>Konsolidiert die Delta-Daten; der aktuelle Stand bleibt erhalten.</td></tr></tbody></table>

</div>Klassische VMware-Snapshots sind für kurzfristige Rückkehrpunkte gedacht; Broadcom empfiehlt höchstens 72 Stunden Aufbewahrung. Diese Empfehlung lässt sich nicht auf ZFS-Snapshots übertragen. Die VMware-Umsetzung kann je nach Speicherplattform abweichen. [VMware-Empfehlungen](https://knowledge.broadcom.com/external/article/318825/best-practices-for-using-vmware-snapshots.html)

</section><section id="bkmrk-unsere-snapshot-aufb">## Unsere Snapshot-Aufbewahrung: ungefähr drei Monate

Die Crontab bestimmt die Ausführungszeitpunkte. Pro Zeitstufe behalten wir eine feste Anzahl von Snapshots:

<div class="table-wrap"><table><thead><tr><th scope="col">Intervall</th><th scope="col">Reihe</th><th scope="col">Anzahl</th><th scope="col">Ungefähres Fenster</th></tr></thead><tbody><tr><td>Alle 15 Minuten</td><td>`frequent`</td><td>12</td><td>3 Stunden</td></tr><tr><td>Stündlich</td><td>`hourly`</td><td>96</td><td>4 Tage</td></tr><tr><td>Täglich</td><td>`daily`</td><td>21</td><td>3 Wochen</td></tr><tr><td>Wöchentlich</td><td>`weekly`</td><td>6</td><td>6 Wochen</td></tr><tr><td>Monatlich</td><td>`monthly`</td><td>3</td><td>3 Monate</td></tr></tbody></table>

</div>**Je neuer der Datenstand, desto feiner die Auswahl.** Für heutige Fehler gibt es viele Rückkehrpunkte. Für spät bemerkte Fehler bleiben ältere Tages-, Wochen- und Monatsstände.

Die Fenster sind Richtwerte, keine garantierten Mindestzeiten. Die tatsächliche Reichweite hängt vom Cron-Zeitpunkt und erfolgreichen Ausführungen ab. Eine bestimmte Dateiversion ist nur wiederherstellbar, wenn mindestens ein noch vorhandener Snapshot sie erfasst hat.

</section><section id="bkmrk-wie-arbeitet-zfs-aut">## Wie arbeitet ZFS Auto Snapshot?

Cron startet das Programm. Es wählt die vorgesehenen Datenbereiche aus, erstellt einen Snapshot mit Zeitstufe und Zeitstempel und entfernt ältere passende Snapshots nach der eingestellten Anzahl.

Bei der Stundenreihe bleibt beispielsweise mit `--label=hourly --keep=96` nach dem Aufräumen eine Auswahl von 96 Stundenständen. Die Reihen sind unabhängig: Ein Viertelstunden-Snapshot wird nicht später zum Tages- oder Monatssnapshot umgewandelt.

### Die verwendeten ZFS-Befehle

<div class="table-wrap"><table><thead><tr><th scope="col">Befehl</th><th scope="col">Aufgabe</th></tr></thead><tbody><tr><td>`zpool status`</td><td>Poolzustand und laufende Scrubs prüfen.</td></tr><tr><td>`zfs list`</td><td>Datenbereiche, Auto-Snapshot-Eigenschaften und vorhandene Snapshots auslesen.</td></tr><tr><td>`zfs snapshot`</td><td>Neue Momentaufnahme erstellen; mit `-r` auch für untergeordnete Datasets.</td></tr><tr><td>`zfs destroy -d`</td><td>Alte Snapshots entfernen oder deren Löschung vormerken, wenn Holds oder Clones sie noch benötigen.</td></tr><tr><td>`zfs get`</td><td>Optional die seit dem letzten Snapshot geschriebenen Daten prüfen.</td></tr></tbody></table>

</div>Die Auswahl lässt sich über Eigenschaften wie `com.sun:auto-snapshot` und `com.sun:auto-snapshot:hourly` steuern. Diese Beschreibung bezieht sich auf die Linux-Implementierung von [zfsonlinux/zfs-auto-snapshot](https://github.com/zfsonlinux/zfs-auto-snapshot/blob/master/src/zfs-auto-snapshot.sh).

</section><section id="bkmrk-mit-zpool-list-die-8">## Mit zpool list die 80-%-Grenze prüfen

Unser Betriebsziel ist, den Pool **unter 80 % Belegung** zu halten. Die Reserve lässt Platz für neue Daten, Snapshot-Wachstum und Änderungen an Clones. 80 % ist eine betriebliche Richtlinie, keine feste ZFS-Funktionsgrenze.

```
zpool list -o name,size,alloc,free,cap,health rpool
```

Entscheidend ist `CAP`: Steht dort `78%`, bleibt wenig Reserve bis zu unserem Grenzwert. Bei `80%` oder mehr reduzieren wir die Belegung. `ALLOC` zeigt den belegten, `FREE` den freien Poolplatz. Der tatsächlich für Datasets nutzbare Platz kann wegen Reservierungen und anderer Faktoren abweichen.

Zur Einordnung prüfen wir zusätzlich, wo Platz belegt wird:

```
zfs list -r -o name,used,avail,usedbysnapshots,usedbydataset rpool
zfs list -t snapshot -r -o name,used,referenced -s creation rpool
zfs list -t volume -r -o name,used,referenced,refreservation rpool
```

`usedbysnapshots` zeigt den von Snapshots gebundenen Platz eines Datasets. Snapshot-Werte dürfen nicht einfach addiert werden, da Blöcke gemeinsam genutzt werden. Bei ZVOLs prüfen wir auch `refreservation`, also reservierten Platz. [OpenZFS: zpool list](https://openzfs.github.io/openzfs-docs/man/master/8/zpool-list.8.html)

### Aufbewahrung bei Platzmangel reduzieren

In den bestehenden Cron-Aufrufen ändern wir `--keep`. Die Ausführungszeiten bleiben erhalten. Eine mögliche kürzere Aufbewahrung ist:

<div class="table-wrap"><table><thead><tr><th scope="col">Reihe</th><th scope="col">Bisher</th><th scope="col">Kürzeres Beispiel</th><th scope="col">Ungefähres Fenster</th></tr></thead><tbody><tr><td>frequent</td><td>12</td><td>8</td><td>2 Stunden</td></tr><tr><td>hourly</td><td>96</td><td>48</td><td>2 Tage</td></tr><tr><td>daily</td><td>21</td><td>14</td><td>2 Wochen</td></tr><tr><td>weekly</td><td>6</td><td>4</td><td>4 Wochen</td></tr><tr><td>monthly</td><td>3</td><td>2</td><td>2 Monate</td></tr></tbody></table>

</div>Beispiel für eine Benutzer- oder Root-Crontab; den Programmpfad gegebenenfalls anpassen. In `/etc/cron.d/` steht zusätzlich nach den fünf Zeitfeldern der Benutzer `root`. Bestehende Aufgaben ersetzen, keine parallelen doppelten Aufgaben anlegen.

```
*/15 * * * * /usr/sbin/zfs-auto-snapshot --quiet --syslog --label=frequent --keep=8 //
0 * * * * /usr/sbin/zfs-auto-snapshot --quiet --syslog --label=hourly --keep=48 //
0 0 * * * /usr/sbin/zfs-auto-snapshot --quiet --syslog --label=daily --keep=14 //
0 0 * * 0 /usr/sbin/zfs-auto-snapshot --quiet --syslog --label=weekly --keep=4 //
0 0 1 * * /usr/sbin/zfs-auto-snapshot --quiet --syslog --label=monthly --keep=2 //
```

Die Zeitfelder sind ein Beispiel. Bei unserer Installation übernehmen wir die vorhandenen Zeiten, Dataset-Auswahl und sonstigen Optionen und ändern nur die gewünschten Aufbewahrungszahlen. Auto Snapshot räumt jede Reihe beim nächsten erfolgreichen Aufruf auf. Die Monatsreihe wird deshalb nicht sofort durch eine Änderung der Crontab verkürzt.

Für zeitnahes Aufräumen kann ein entsprechender normaler Aufruf außerhalb von Cron erfolgen: zuerst mit `--dry-run` prüfen, dann nach Prüfung ohne diese Option ausführen. Dieser Aufruf erstellt auch einen neuen Snapshot. Für jede betroffene Reihe ist ein eigener Aufruf nötig; er sollte nicht gleichzeitig mit dem regulären Cron-Lauf erfolgen.

```
# Vorschau für die Stundenreihe:
zfs-auto-snapshot --dry-run --label=hourly --keep=48 //
# Nach Prüfung: neuer Snapshot und Aufräumen der Stundenreihe
zfs-auto-snapshot --label=hourly --keep=48 //
# Anschließend Belegung erneut kontrollieren:
zpool list -o name,size,alloc,free,cap,health rpool
```

<div class="note caution">Eine kürzere Aufbewahrung entfernt Wiederherstellungspunkte dauerhaft. Sie gibt nur Blöcke frei, die danach niemand mehr benötigt. Clones und Holds können alte Blöcke weiter binden; die Freigabe kann verzögert erfolgen. Bleibt der Pool zu voll, müssen zusätzlich aktuelle Daten, Reservierungen und nicht mehr benötigte Wiederherstellungs-Clones geprüft werden. TRIM allein verringert `CAP` nicht.</div></section><section id="bkmrk-warum-snapshots-auch">## Warum Snapshots auch bei SSD-TRIM erhalten bleiben

TRIM meldet der SSD, welche Speicherbereiche der Pool nicht mehr benötigt. Die SSD darf deren Inhalt anschließend intern verwerfen.

**Blöcke, die ein Snapshot noch benötigt, bleiben für ZFS belegt und werden nicht zum Trimmen freigegeben.** Eine im aktuellen Dateisystem gelöschte Datei bleibt dadurch aus einem vorhandenen Snapshot wiederherstellbar.

Erst wenn keine Referenz mehr besteht, können die Blöcke freigegeben und später getrimmt werden. Snapshot-Löschung und TRIM sind getrennte Vorgänge; Auto Snapshot führt keinen eigenen Pool-TRIM aus.

<div class="note">Wir bewahren Snapshots für die Wiederherstellung auf. Unbegrenzte Aufbewahrung zur Vermeidung von TRIM bietet keinen pauschalen Vorteil für SSD-Leistung oder Lebensdauer und bindet Speicher.</div>[OpenZFS-Dokumentation zu TRIM](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Operations/TRIM.html)

</section><section id="bkmrk-proxmox%3A-rollback%2C-s">## Proxmox: Rollback, Snapshot-Verzeichnis oder Clone?

Wir verwenden ZFS Auto Snapshot. Unsere Wiederherstellung erfolgt auf ZFS-Ebene; Proxmox stoppt und startet die Gäste.

<div class="table-wrap"><table><thead><tr><th scope="col">Ziel</th><th scope="col">Geeigneter Weg</th></tr></thead><tbody><tr><td>Einzelne LXC- oder NAS-Dateien retten</td><td>Aus dem Snapshot-Verzeichnis herauskopieren.</td></tr><tr><td>Alten Stand untersuchen oder reparieren</td><td>Separaten beschreibbaren Clone erstellen.</td></tr><tr><td>Produktiven Speicher vollständig zurücksetzen</td><td>Gast stoppen, Rollback durchführen, Gast starten.</td></tr></tbody></table>

</div>### Rollback einer VM oder eines LXC-Containers

Die folgenden Befehle sind Vorlagen. IDs, Speicherbereiche und Snapshot-Namen müssen zum Gast passen. Vorher wird sichergestellt, dass beispielsweise HA den Gast nicht automatisch neu startet.

**VM mit ZVOL:**

```
qm stop 100
zfs rollback rpool/data/vm-100-disk-0@SNAPSHOTNAME
# Erst nach erfolgreichem Rollback starten:
qm start 100
```

**LXC mit Dateisystem-Dataset:**

```
pct stop 200
zfs rollback rpool/data/subvol-200-disk-0@SNAPSHOTNAME
# Erst nach erfolgreichem Rollback starten:
pct start 200
```

<div class="note caution">**Rollback verwirft spätere Änderungen.** `qm stop` und `pct stop` stoppen unmittelbar. Anwendungen werden vorher möglichst geordnet beendet. Bei mehreren Festplatten oder Datasets müssen alle benötigten Bereiche auf zusammenpassende Stände gebracht werden; erst danach startet der Gast.</div>Ohne Zusatzoption erlaubt ZFS nur den neuesten Snapshot. Für einen älteren Stand ermöglicht `zfs rollback -r` das Zurücksetzen, löscht dabei aber neuere Snapshots und Bookmarks des betroffenen Speicherbereichs. Untergeordnete Datasets werden nicht automatisch zurückgesetzt. [OpenZFS: Rollback](https://openzfs.github.io/openzfs-docs/man/master/8/zfs-rollback.8.html)

### Snapshot-Verzeichnis für LXC und NAS

Bei Dateisystem-Datasets erreichen wir die alten Dateien auf dem Host unter:

```
<MOUNTPOINT>/.zfs/snapshot/<SNAPSHOTNAME>/
```

Der Inhalt ist schreibgeschützt. Wir kopieren benötigte Dateien zunächst in ein separates Wiederherstellungsverzeichnis. Beim Zurückkopieren bleiben Eigentümer und Rechte erhalten, insbesondere bei unprivilegierten LXC-Containern. Vor dem Ersetzen aktiver Anwendungsdateien stoppen wir die betroffene Anwendung.

`snapdir=visible` macht `.zfs` in Verzeichnislisten sichtbar. Bei `hidden` funktioniert normalerweise der direkte Pfad. Ein ZVOL für eine VM besitzt kein solches Dateiverzeichnis.

### Clones für eine separate Wiederherstellung

Ein ZFS-Clone ist ein beschreibbarer Speicherbereich aus einem Snapshot. Für LXC oder NAS mounten wir ihn separat. Einen ZVOL-Clone können wir als zusätzliche Festplatte einer Wiederherstellungs-VM zuordnen und darin auf das Gast-Dateisystem zugreifen.

Der aktuelle Datenbestand bleibt erhalten. Clones benötigen anfangs kaum zusätzlichen Platz, eigene Änderungen belegen neue Blöcke. Der Ursprungssnapshot bleibt erforderlich, solange der Clone davon abhängt.

Ein manueller ZFS-Clone ist noch kein startfertiger Proxmox-Gast. Speicherzuordnung und Konfiguration müssen eingerichtet werden. Ein daraus gestarteter Testgast erhält zunächst ein getrenntes Netzwerk, damit keine doppelten IP-Adressen oder gleichzeitig aktiven Dienste entstehen.

[OpenZFS: Snapshot-Zugriff und Clones](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Datasets/Snapshots%20and%20Clones.html)

### Grenzen der Wiederherstellung

Auto-Snapshots erfassen die ausgewählten Speicherbereiche. RAM, separat gespeicherte Proxmox-Gastkonfigurationen und externe Mounts gehören nicht automatisch dazu. Ein konsistenter ZFS-Snapshot garantiert außerdem keine Anwendungskonsistenz einer laufenden Datenbank.

<div class="note">**Bei Verlust des Pools brauchen wir ein separates Backup.** ZFS Auto Snapshot allein repliziert keine Daten. Eine Übertragung mit `zfs send` und `zfs receive` auf ein anderes System muss zusätzlich eingerichtet werden.</div></section><section id="bkmrk-alle-vm-disks-nach-r">## Alle VM-Disks nach rpool/clone klonen und eine neue VM anlegen

Wir erstellen aus den Auto-Snapshots beschreibbare ZVOL-Clones und ordnen sie einer neuen Proxmox-VM zu. Die produktive VM und ihre aktuellen Disks bleiben erhalten. Die folgenden Schritte sind eine **Vorlage für VM 100 → VM 900** auf dem Host mit `rpool`; VMID 900 und die Zielnamen müssen frei sein.

### 1. Alle Disks und den Wiederherstellungsstand erfassen

```
qm config 100
zfs list -t volume -r rpool
zfs list -t snapshot -r -o name,creation -s creation rpool/data
```

Aus `qm config` übernehmen wir jede Festplatten-Zuordnung, einschließlich vorhandener `efidisk0` und `tpmstate0`. Speicherpfade lassen sich mit `pvesm path <VOLUME-ID>` auflösen. CD-ROM-ISOs werden nicht als ZVOL geklont. Eine vorhandene Cloud-Init-Disk und zusätzliche ZVOLs müssen ebenfalls berücksichtigt werden.

Für jede Disk muss der gewählte Snapshot existieren. Derselbe Snapshot-Name bedeutet bei einzeln erstellten Snapshots nicht zwingend denselben Erstellungszeitpunkt. Für Datenbanken über mehrere Disks benötigen wir einen koordinierten, anwendungskonsistenten Stand oder müssen nach dem Start mit Wiederherstellungsarbeiten rechnen.

<div class="table-wrap"><table><caption>Beispiel-Zuordnung – anhand der echten VM-Konfiguration prüfen</caption><thead><tr><th scope="col">Anschluss</th><th scope="col">Quell-ZVOL</th><th scope="col">Ziel-ZVOL</th></tr></thead><tbody><tr><td>scsi0</td><td>rpool/data/vm-100-disk-0</td><td>rpool/clone/vm-900-disk-0</td></tr><tr><td>scsi1</td><td>rpool/data/vm-100-disk-1</td><td>rpool/clone/vm-900-disk-1</td></tr><tr><td>efidisk0</td><td>rpool/data/vm-100-disk-2</td><td>rpool/clone/vm-900-disk-2</td></tr><tr><td>tpmstate0</td><td>rpool/data/vm-100-disk-3</td><td>rpool/clone/vm-900-disk-3</td></tr></tbody></table>

</div>### 2. ZFS-Bereich und Proxmox-Storage einrichten

Einmalig anlegen, wenn noch nicht vorhanden. `rpool/clone` ist der ZFS-Bereich; `zfs-clone` ist die Storage-ID in Proxmox. Hier ist mit „Datastore“ ein Proxmox-VE-Storage gemeint, kein Proxmox-Backup-Server-Datastore.

```
zfs create -o mountpoint=none -o com.sun:auto-snapshot=false rpool/clone

# PVE-NODENAME durch den tatsächlichen Proxmox-Knotennamen ersetzen:
pvesm add zfspool zfs-clone --pool rpool/clone --content images --sparse 1 --nodes PVE-NODENAME
pvesm status
```

Die Beschränkung auf den richtigen Knoten ist besonders im Cluster wichtig: Dieser Storage liegt lokal. `com.sun:auto-snapshot=false` schließt den Wiederherstellungsbereich über die geerbte Eigenschaft von der normalen Auto-Snapshot-Rotation aus.

### 3. Für jede Disk einen ZFS-Clone erstellen

`SNAPSHOTNAME` durch den tatsächlich vorhandenen Auto-Snapshot-Namen ersetzen. Die vier Befehle decken alle Disks unseres Beispiels ab. Hat die VM weitere ZVOLs, wird die Liste entsprechend erweitert.

```
zfs clone -o refreservation=none -o com.sun:auto-snapshot=false rpool/data/vm-100-disk-0@SNAPSHOTNAME rpool/clone/vm-900-disk-0
zfs clone -o refreservation=none -o com.sun:auto-snapshot=false rpool/data/vm-100-disk-1@SNAPSHOTNAME rpool/clone/vm-900-disk-1
zfs clone -o refreservation=none -o com.sun:auto-snapshot=false rpool/data/vm-100-disk-2@SNAPSHOTNAME rpool/clone/vm-900-disk-2
zfs clone -o refreservation=none -o com.sun:auto-snapshot=false rpool/data/vm-100-disk-3@SNAPSHOTNAME rpool/clone/vm-900-disk-3

zfs list -t volume -r -o name,origin,used,referenced,refreservation rpool/clone
pvesm list zfs-clone --vmid 900
```

`refreservation=none` vermeidet eine vollständige Platzreservierung pro Clone. Eigene Schreibzugriffe brauchen trotzdem echten freien Poolplatz. Die Namen `vm-900-disk-N` ordnen die Volumes der neuen VMID zu. ZFS-Clones müssen innerhalb desselben Pools bleiben.

### 4. Neue VM anlegen und geklonte Disks anschließen

Dieses Beispiel setzt eine UEFI-VM mit Q35, VirtIO-SCSI, einer EFI-Disk des Typs 4m und TPM 2.0 voraus. BIOS, Maschinenmodell, Controller, Disk-Anschlüsse, EFI-/TPM-Version und Disk-Optionen müssen zur Quell-VM passen. Bei einer BIOS-VM entfällt beispielsweise die EFI-Disk. Die VM wird zunächst ohne Netzwerkkarte angelegt.

```
qm create 900 --name recovery-vm100 --memory 4096 --cores 2 --bios ovmf --machine q35 --scsihw virtio-scsi-pci --onboot 0
qm set 900 --scsi0 zfs-clone:vm-900-disk-0
qm set 900 --scsi1 zfs-clone:vm-900-disk-1
qm set 900 --efidisk0 zfs-clone:vm-900-disk-2,efitype=4m,pre-enrolled-keys=1
qm set 900 --tpmstate0 zfs-clone:vm-900-disk-3,version=v2.0
qm set 900 --boot 'order=scsi0'
qm config 900
# Erst nach Prüfung aller Zuordnungen starten:
qm start 900
```

Die Befehle verbinden bestehende Clones; sie importieren oder kopieren keine neuen Disk-Inhalte. Die aktuelle Konfiguration der Quell-VM dient nur als Vorlage: Bei alten Datenständen kann die damalige Hardware-Konfiguration nötig sein. Bei verschlüsselten Gästen können außerdem Wiederherstellungsschlüssel erforderlich sein.

Über die Proxmox-Konsole prüfen wir den Start und die Daten. Für Dateirettung kann stattdessen eine vorhandene Wiederherstellungs-VM die geklonten Daten-Disks als zusätzliche Laufwerke erhalten. Erst wenn nötig, verbinden wir den Testgast mit einem isolierten Netz.

### 5. Abhängigkeiten und Speicherplatz nach der Rettung

Der Clone bleibt von seinem Ursprungssnapshot abhängig. Auto Snapshot kann diesen deshalb nicht sofort vollständig entfernen. Nicht mehr benötigte Recovery-VMs und ihre Clone-Disks werden nach geprüfter Datenrettung über Proxmox entfernt; anschließend kontrollieren wir `rpool/clone` und `zpool list`. Soll die Recovery-VM dauerhaft bestehen, planen wir eine unabhängige vollständige Kopie statt eines dauerhaften Recovery-Clones.

<div class="note">`rpool/clone` nutzt denselben Pool. Es ist eine separate Arbeitskopie, aber kein unabhängiges Backup und kein zusätzlicher physischer Speicher.</div>Referenzen: [Proxmox-ZFS-Storage](https://github.com/proxmox/pve-docs/blob/master/pve-storage-zfspool.adoc), [pvesm](https://github.com/proxmox/pve-docs/blob/master/generated/pvesm.1-synopsis.adoc), [qm](https://github.com/proxmox/pve-docs/blob/master/generated/qm.1-synopsis.adoc), [ZFS-Clone](https://openzfs.github.io/openzfs-docs/man/master/8/zfs-clone.8.html).

</section><section id="bkmrk-weiterf%C3%BChrende-dokum">## Weiterführende Dokumentation

- [OpenZFS: Snapshots, Clones und Zugriff auf ältere Dateien](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Datasets/Snapshots%20and%20Clones.html)
- [OpenZFS: SSD-TRIM](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Operations/TRIM.html)
- [ZFS Auto Snapshot für Linux](https://github.com/zfsonlinux/zfs-auto-snapshot)
- [Proxmox: VM-Verwaltung mit qm](https://pve.proxmox.com/pve-docs/qm.1.html)
- [Proxmox: LXC-Verwaltung mit pct](https://pve.proxmox.com/pve-docs/pct.1.html)
- [OpenZFS: Replikation mit zfs send](https://openzfs.github.io/openzfs-docs/man/master/8/zfs-send.8.html)

</section></article></main><footer id="bkmrk-">[![ZFS Auto Snapshot – Kurzreferenz.png](https://aow.de/uploads/images/gallery/2026-10/scaled-1680-/zfs-auto-snapshot-kurzreferenz.png)](https://aow.de/uploads/images/gallery/2026-10/zfs-auto-snapshot-kurzreferenz.png)</footer><footer id="bkmrk-ein-klonscript-zum-t">Ein Klonscript zum Testen (KI-Generiert) könnt ihr hier mal probieren  
```python
#!/usr/bin/env python3
"""Clone a local Proxmox VM from external ZFS snapshots; no source rollback.

Run as root on the source node. Python 3 and the Proxmox/ZFS CLI are required.
Example: python3 proxmox-zfs-clone.py 100 900 zfs-auto-snap_daily-2026-10-08-0000
Use --dry-run to inspect without changing anything. The new VM stays stopped
and has no network interfaces. No Proxmox-internal snapshot is required.
"""

import argparse
import fcntl
import json
import os
import re
import shlex
import shutil
import socket
import subprocess
import sys
import uuid
from dataclasses import dataclass


class CloneError(Exception):
    pass


def read(*command):
    result = subprocess.run(command, text=True, capture_output=True)
    if result.returncode:
        raise CloneError(f"{' '.join(command[:2])}: {result.stderr.strip() or result.stdout.strip()}")
    return result.stdout.strip()


def api(path, *options):
    return json.loads(read("pvesh", "get", path, *options, "--output-format", "json"))


def change(command, dry_run):
    print(("VORSCHAU: " if dry_run else "> ") + shlex.join(command), flush=True)
    if not dry_run:
        subprocess.run(command, check=True)


def config(vmid):
    result = {}
    for line in read("qm", "config", str(vmid), "--current", "1").splitlines():
        key, sep, value = line.partition(": ")
        if sep:
            result[key] = value
    return result


@dataclass
class Disk:
    slot: str
    source: str
    target: str
    options: list
    creation: int


def plan_disks(source_config, target_id, snapshot, dataset):
    disks = []
    skipped = []
    sources = set()
    for slot, value in sorted(source_config.items()):
        if not re.fullmatch(r"(?:scsi|sata|ide|virtio)\d+|efidisk0|tpmstate0", slot):
            continue
        parts = value.split(",")
        volume = parts[0].removeprefix("file=")
        options = parts[1:]
        if volume in {"none", "cdrom"} or ":iso/" in volume:
            skipped.append(slot)
            continue
        if ":" not in volume:
            raise CloneError(f"{slot}: kein verwaltetes ZFS-Volume ({volume}).")
        path = read("pvesm", "path", volume)
        if not path.startswith("/dev/zvol/"):
            raise CloneError(f"{slot}: {volume} ist kein lokales ZVOL. Alle Disks müssen auf ZFS liegen.")
        zvol = path[len("/dev/zvol/"):]
        if zvol.split("/", 1)[0] != dataset.split("/", 1)[0]:
            raise CloneError(f"{slot}: {zvol} liegt nicht im Ziel-Pool. ZFS-Clones können Pools nicht wechseln.")
        if zvol in sources:
            raise CloneError(f"Das ZVOL {zvol} ist mehrfach angeschlossen; Zuordnung manuell prüfen.")
        sources.add(zvol)
        snap = f"{zvol}@{snapshot}"
        # Missing snapshots abort here, before any mutation.
        creation = int(read("zfs", "get", "-Hp", "-o", "value", "creation", snap))
        kind = read("zfs", "get", "-H", "-o", "value", "type", zvol)
        if kind != "volume":
            raise CloneError(f"{zvol} ist kein ZVOL.")
        # No source replication flags or reservations are transferred.
        options = [p for p in options if p.split("=", 1)[0] not in
                   {"size", "replicate", "shared", "import-from"}]
        disks.append(Disk(slot, zvol, f"{dataset}/vm-{target_id}-disk-{len(disks)}",
                          options, creation))
    if not disks:
        raise CloneError("Keine klonbaren ZVOL-Disks gefunden.")
    return disks, skipped


HARDWARE = {
    "acpi", "agent", "arch", "balloon", "bios", "bootdisk", "cores", "cpu",
    "hotplug", "keyboard", "kvm", "localtime", "machine", "memory", "numa",
    "ostype", "scsihw", "sockets", "tablet", "tdf", "vga", "smbios1",
    "vmgenid", "serial0", "serial1", "serial2", "serial3",
}


def creation_command(args, source_config, slots):
    command = ["qm", "create", str(args.target), "--name", args.name,
               "--onboot", "0", "--description",
               f"ZFS-Recovery von VM {args.source}; Snapshot {args.snapshot}; ohne Netzwerk."]
    for key in sorted(HARDWARE):
        if key not in source_config:
            continue
        value = source_config[key]
        if key == "smbios1":
            # Keep hardware identifiers for guest compatibility; assign a new VM UUID.
            fields = [p for p in value.split(",") if not p.startswith("uuid=")]
            value = ",".join([f"uuid={uuid.uuid4()}"] + fields)
        elif key == "vmgenid":
            value = str(uuid.uuid4())
        elif key.startswith("serial") and value != "socket":
            raise CloneError(f"{key}: physische serielle Schnittstelle wird nicht automatisch übernommen.")
        elif key == "bootdisk" and value not in slots:
            continue
        command += [f"--{key}", value]
    boot = source_config.get("boot", "")
    if boot.startswith("order="):
        devices = [p for p in boot[6:].split(";") if p in slots]
        if devices:
            command += ["--boot", "order=" + ";".join(devices)]
    elif boot:
        command += ["--boot", boot]
    return command


def main(args):
    for tool in ("qm", "pvesh", "pvesm", "zfs", "zpool"):
        if not shutil.which(tool):
            raise CloneError(f"{tool} fehlt. Auf dem Proxmox-Quellknoten ausführen.")
    if os.geteuid() != 0:
        raise CloneError("Auf dem Proxmox-Knoten als root ausführen (auch für die Vorschau).")
    # Serializes this script's local executions, not other PVE or ZFS operations.
    with open("/run/lock/proxmox-zfs-clone.lock", "a") as lock:
        try:
            fcntl.flock(lock, fcntl.LOCK_EX | fcntl.LOCK_NB)
        except BlockingIOError:
            raise CloneError("Ein anderer Lauf dieses Scripts ist bereits aktiv.")
        execute(args)


def execute(args):
    resources = api("/cluster/resources", "--type", "vm")
    if any(int(r["vmid"]) == args.target for r in resources):
        raise CloneError(f"VMID {args.target} ist im Cluster bereits belegt.")
    source = next((r for r in resources if int(r["vmid"]) == args.source), None)
    if not source or source.get("type") != "qemu":
        raise CloneError(f"VM {args.source} nicht gefunden oder kein QEMU-Gast.")
    if source["node"] != args.node:
        raise CloneError(f"Quell-VM liegt auf {source['node']}; Script dort ausführen.")
    source_config = config(args.source)
    if source_config.get("lock"):
        raise CloneError("Die Quell-VM ist gesperrt; laufende Operation abwarten.")
    # Hidden storage or passthrough in custom arguments cannot be safely inferred.
    if any(k in source_config for k in ("args", "amd-sev", "intel-tdx")):
        raise CloneError("Spezielle QEMU-Argumente/Confidential-VM-Konfiguration: manuelle Wiederherstellung nötig.")
    disks, skipped = plan_disks(source_config, args.target, args.snapshot, args.dataset)
    command = creation_command(args, source_config, {d.slot for d in disks})
    pool = args.dataset.split("/", 1)[0]
    capacity = int(read("zpool", "list", "-Hp", "-o", "capacity", pool).rstrip("%"))
    print(f"Pool {pool}: {capacity}% belegt. Ziel: unter 80%.")
    if capacity >= 80:
        print("HINWEIS: Pool hat wenig Reserve; Clone-Schreibzugriffe benötigen zusätzlichen Platz.")
    datasets = set(read("zfs", "list", "-H", "-o", "name", "-r", pool).splitlines())
    if any(d.target in datasets for d in disks):
        raise CloneError("Mindestens ein Ziel-ZVOL existiert bereits; nichts wird überschrieben.")
    if args.dataset in datasets:
        if read("zfs", "get", "-H", "-o", "value", "type", args.dataset) != "filesystem":
            raise CloneError("Zielbereich ist kein ZFS-Dateisystem.")
        if read("zfs", "get", "-H", "-o", "value", "com.sun:auto-snapshot", args.dataset) != "false":
            raise CloneError(f"Vorhandenes {args.dataset}: com.sun:auto-snapshot muss false sein.")
    storage = next((s for s in api("/storage") if s["storage"] == args.storage), None)
    if storage:
        nodes = storage.get("nodes", "")
        if isinstance(nodes, str):
            nodes = nodes.split(",") if nodes else []
        if (storage.get("type") != "zfspool" or storage.get("pool") != args.dataset
                or "images" not in storage.get("content", "").split(",")
                or int(storage.get("disable", 0)) or int(storage.get("shared", 0))
                or (nodes and args.node not in nodes)):
            raise CloneError("Vorhandener Ziel-Storage passt nicht zum lokalen Clone-Bereich.")
    print(f"VM {args.source} -> VM {args.target}; Snapshot: {args.snapshot}")
    for d in disks:
        print(f"  {d.slot}: {d.source} -> {d.target}")
    if skipped:
        print("Nicht übernommen (ISO/leeres CD-Laufwerk): " + ", ".join(skipped))
    print("Netzwerk, Passthrough, Hooks und unused-Volumes werden nicht übernommen.")
    if any("cloudinit" in source_config[d.slot].split(",")[0] for d in disks):
        print("Cloud-Init-ZVOL wird als statischer Snapshot-Inhalt geklont; keine Cloud-Init-Neugenerierung.")
    if len({d.creation for d in disks}) > 1:
        print("HINWEIS: Snapshot-Zeitpunkte der Disks unterscheiden sich; Anwendungskonsistenz prüfen.")
    print("Hardware-Vorlage ist die aktuelle Quell-Konfiguration, nicht die historische Snapshot-Konfiguration.")
    held = []
    created = []
    tag = "recovery-clone-" + uuid.uuid4().hex
    try:
        # Holds prevent auto-snapshot pruning between validation and cloning.
        for d in disks:
            snap = f"{d.source}@{args.snapshot}"
            change(["zfs", "hold", tag, snap], args.dry_run)
            if not args.dry_run:
                held.append(snap)
        if config(args.source) != source_config:
            raise CloneError("Quell-Konfiguration hat sich während der Prüfung geändert; erneut ausführen.")
        if args.dataset not in datasets:
            change(["zfs", "create", "-o", "mountpoint=none", "-o",
                    "com.sun:auto-snapshot=false", args.dataset], args.dry_run)
        if not storage:
            change(["pvesm", "add", "zfspool", args.storage, "--pool", args.dataset,
                    "--content", "images", "--sparse", "1", "--nodes", args.node], args.dry_run)
        for d in disks:
            change(["zfs", "clone", "-o", "refreservation=none", "-o", "readonly=off",
                    "-o", "com.sun:auto-snapshot=false", f"{d.source}@{args.snapshot}",
                    d.target], args.dry_run)
            if not args.dry_run:
                created.append(d.target)
        change(command, args.dry_run)
        for d in disks:
            volume = f"{args.storage}:{d.target.rsplit('/', 1)[1]}"
            specification = ",".join([volume] + d.options)
            change(["qm", "set", str(args.target), f"--{d.slot}", specification], args.dry_run)
        if not args.dry_run:
            print(read("qm", "config", str(args.target)))
        print(f"{'Vorschau abgeschlossen' if args.dry_run else 'Fertig'}: VM {args.target} bleibt gestoppt, ohne Netzwerk.")
        print(f"Nach Prüfung starten: qm start {args.target}")
        print("Clones binden ihre Ursprungssnapshots. Nach der Rettung Recovery-VM und Disks aufräumen.")
    except (Exception, KeyboardInterrupt):
        if not args.dry_run:
            print("ABBRUCH: Bereits erstellte Ressourcen bleiben zur Prüfung erhalten.", file=sys.stderr)
            print(f"Ziel-VM prüfen: qm config {args.target}", file=sys.stderr)
            for target in created:
                print(f"Erstellter Clone: {target}", file=sys.stderr)
        raise
    finally:
        for snap in held:
            try:
                change(["zfs", "release", tag, snap], False)
            except (OSError, subprocess.CalledProcessError):
                print(f"Hold manuell lösen: zfs release {shlex.quote(tag)} {shlex.quote(snap)}", file=sys.stderr)


def arguments():
    parser = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawDescriptionHelpFormatter)
    parser.add_argument("source", type=int, help="Quell-VMID")
    parser.add_argument("target", type=int, help="Freie Ziel-VMID")
    parser.add_argument("snapshot", help="Snapshot-Name ohne Dataset und ohne @")
    parser.add_argument("--name", help="Name der neuen VM")
    parser.add_argument("--dataset", default="rpool/clone", help="ZFS-Zielbereich (Standard: rpool/clone)")
    parser.add_argument("--storage", default="zfs-clone", help="Proxmox-Storage-ID (Standard: zfs-clone)")
    parser.add_argument("--node", default=socket.gethostname().split(".")[0], help="Lokaler Proxmox-Knotenname")
    parser.add_argument("--dry-run", action="store_true", help="Nur prüfen und Befehle anzeigen; keine Änderungen")
    args = parser.parse_args()
    if not (100 <= args.source <= 999999999 and 100 <= args.target <= 999999999) or args.source == args.target:
        parser.error("Unterschiedliche VMIDs zwischen 100 und 999999999 angeben.")
    if not re.fullmatch(r"[A-Za-z0-9_.:-]+", args.snapshot):
        parser.error("Snapshot-Name ohne @, / oder Leerzeichen angeben.")
    if not re.fullmatch(r"[A-Za-z][A-Za-z0-9_-]*(?:/[A-Za-z0-9_.:-]+)+", args.dataset):
        parser.error("Ziel muss ein Dataset unterhalb eines Pools sein, z. B. rpool/clone.")
    if not re.fullmatch(r"[A-Za-z][A-Za-z0-9_-]*", args.storage):
        parser.error("Ungültige Storage-ID.")
    args.name = args.name or f"recovery-vm{args.source}-{args.target}"
    if not re.fullmatch(r"[A-Za-z0-9][A-Za-z0-9.-]*", args.name):
        parser.error("VM-Name ohne Leerzeichen oder Sonderzeichen angeben.")
    return args


if __name__ == "__main__":
    try:
        main(arguments())
    except (CloneError, subprocess.CalledProcessError, OSError, ValueError) as error:
        print(f"FEHLER: {error}", file=sys.stderr)
        sys.exit(1)
    except KeyboardInterrupt:
        print("Abgebrochen.", file=sys.stderr)
        sys.exit(130)
```

  
</footer><footer id="bkmrk-stand%3A-8.-oktober-20">Stand: <time datetime="2026-10-08">8. Oktober 2026</time> · Betriebsstrategie: ZFS Auto Snapshot mit fünf Aufbewahrungsstufen.</footer>

# Proxmox best Practice Cluster mit ZFS, CepH, SAN - Themenübersicher von KI analysiert

> Dieser Artikel ist KI generiert. Als Basis diente die Sprache des Referenten und die ca 800 Screenshots!

<section id="bkmrk-dieser-artikel-ist-k-1">## Zusammenfassung des Proxmox VE Workshops

Der zweitägige Workshop behandelt Proxmox VE nicht nur als Oberfläche zum Starten virtueller Maschinen, sondern als vollständige Virtualisierungsplattform. Im Mittelpunkt stehen Architektur, Storage, ZFS, Netzwerk, Cluster, High Availability, Backup, Monitoring und die praktische Fehlersuche.

Dabei werden verschiedene Betriebsmodelle miteinander verglichen: vom einzelnen Proxmox-Host über zwei Systeme mit ZFS-Replikation bis hin zu Clustern mit Ceph oder klassischem SAN-Storage.

### 1. Proxmox Grundlagen und Architektur

Proxmox VE basiert auf Debian Linux und verwendet KVM für virtuelle Maschinen sowie Linux-Container für containerisierte Systeme. Dadurch unterscheidet sich Proxmox in einigen Punkten deutlich von klassischen VMware- oder Hyper-V-Umgebungen.

- **Standalone-System:** Ein einzelner Proxmox-Host ist einfach und kostengünstig, bietet aber bei einem Hardwareausfall zunächst keinen zweiten Host für den Wiederanlauf.
- **ZFS-Replikation:** Zwei oder mehr Hosts können lokale VM-Daten regelmäßig untereinander replizieren. Dadurch lässt sich ohne zentrales SAN bereits eine relativ einfache Wiederanlaufstrategie realisieren.
- **Cluster:** Mehrere Proxmox-Systeme werden gemeinsam verwaltet und teilen wichtige Konfigurationsinformationen. Ein Cluster allein bedeutet jedoch noch keine automatische Hochverfügbarkeit.
- **Ceph oder SAN:** Shared Storage ermöglicht mehreren Hosts den Zugriff auf dieselben VM-Daten und vereinfacht dadurch unter anderem Live-Migration und HA.

### 2. Storage und ZFS

ZFS ist einer der Schwerpunkte des Workshops. Es verbindet RAID-Funktionen, Volume-Management, Datenintegrität, Snapshots, Kompression und Caching in einem Storage-System.

- **Mirror und RAID-Z:** Je nach gewünschter Leistung, Kapazität und Ausfallsicherheit können unterschiedliche ZFS-VDEV-Strukturen aufgebaut werden.
- **Checksummen:** ZFS prüft Daten und Metadaten mit Checksummen und kann dadurch nicht nur einen ausgefallenen Datenträger, sondern auch beschädigte Daten erkennen.
- **Kompression:** Daten können transparent komprimiert werden. Gerade VM-Datenträger erreichen dabei teilweise erhebliche Kompressionsraten.
- **ARC und L2ARC:** ZFS verwendet freien Arbeitsspeicher intensiv als Cache. Optional können zusätzliche schnelle Datenträger als weiterer Lesecache eingesetzt werden.
- **SLOG:** Für synchrone Schreibzugriffe kann ein separates schnelles Log-Gerät eingesetzt werden. Das ist vor allem bei entsprechenden Storage-Workloads relevant.
- **SMART und Wearout:** Neben dem eigentlichen ZFS-Pool müssen auch die physischen SSDs und HDDs überwacht werden. Besonders bei SSDs sind Schreibvolumen und Verschleißwerte wichtige Betriebsparameter.

### 3. Snapshots und Recovery

ZFS-Snapshots ermöglichen sehr schnelle Wiederherstellungspunkte. Sie ersetzen kein Backup, sind aber besonders hilfreich bei Updates, Fehlkonfigurationen oder versehentlich veränderten Daten.

- **Automatische Snapshots:** Mit zfs-auto-snapshot können beispielsweise stündliche, tägliche und wöchentliche Wiederherstellungspunkte automatisch erzeugt werden.
- **Rollback:** Ein Dataset kann direkt auf einen früheren Snapshot zurückgesetzt werden. Da dies destruktiv sein kann, muss vor dem Rollback geprüft werden, welche neueren Änderungen dadurch verloren gehen.
- **Clone statt Rollback:** Für eine nicht-destruktive Wiederherstellung kann ein Snapshot geklont und separat bereitgestellt werden. Daten lassen sich anschließend gezielt aus diesem Zustand zurückholen.

### 4. Installation und Post-Installation

Die Proxmox-Installation wurde vollständig durchgeführt. Dabei ging es nicht nur darum, den Installer durchzuklicken, sondern bereits bei der Installation Storage- und Netzwerkentscheidungen bewusst zu treffen.

- **ZFS RAID1 als Systemstorage:** Zwei Datenträger können direkt während der Installation als ZFS-Mirror eingerichtet werden. Dadurch ist auch das Proxmox-System selbst redundant.
- **Management-Netzwerk:** Hostname, feste IP-Adresse, Gateway und DNS sollten vor der Installation geplant sein. Spätere Änderungen sind möglich, können bei Clustern aber deutlich aufwendiger werden.
- **Repositories:** Nach der Installation muss entschieden werden, ob das Enterprise-Repository oder beispielsweise das No-Subscription-Repository verwendet wird.
- **Post-Install-Konfiguration:** Zusätzlich wurden unter anderem VirtIO-Treiber, ZFS-Hilfsprogramme, AutoTrim, Snapshot-Einstellungen und weitere Systemparameter eingerichtet.

### 5. Virtuelle Maschinen richtig konfigurieren

Die virtuelle Hardware beeinflusst Leistung, Kompatibilität und spätere Migrationen. Deshalb wurden VMs nicht einfach mit beliebigen Standardwerten angelegt.

- **Q35 und UEFI:** Für moderne Betriebssysteme bietet sich eine moderne virtuelle Hardwareplattform mit UEFI und EFI-Disk an.
- **VirtIO SCSI:** VirtIO-Geräte vermeiden unnötige Hardwareemulation und bieten bei Storage- und Netzwerkzugriffen eine wesentlich geeignetere virtuelle Schnittstelle.
- **CPU-Konfiguration:** Der CPU-Typ beeinflusst sowohl die verfügbare Leistung und Features als auch die Möglichkeit, eine VM später auf einen anderen Host zu migrieren.
- **Ballooning und KSM:** Proxmox kann Arbeitsspeicher zwischen VMs flexibler verwalten. Diese Funktionen sollten jedoch bewusst eingesetzt und nicht als Ersatz für ausreichenden physischen RAM verstanden werden.
- **QEMU Guest Agent:** Der Agent verbessert die Kommunikation zwischen Proxmox und dem Gastsystem und liefert beispielsweise zusätzliche Statusinformationen.

### 6. Linux- und Windows-Gastsysteme

Im Workshop wurden sowohl Linux- als auch Windows-Systeme praktisch installiert. Dadurch konnten unterschiedliche Anforderungen an virtuelle Hardware und Treiber direkt gezeigt werden.

- **Linux:** Installation, EFI, Partitionierung, zusätzliche virtuelle Datenträger und QEMU Guest Agent wurden praktisch behandelt.
- **Windows:** Windows benötigt für optimale Leistung VirtIO-Treiber. Während der Installation wurden Storage-Treiber sowie anschließend Netzwerk- und weitere VirtIO-Treiber eingebunden.

### 7. Netzwerk und Bridges

Virtuelle Maschinen kommunizieren in Proxmox normalerweise über Linux Bridges. Eine Bridge verbindet dabei virtuelle Netzwerkkarten der VMs mit physischen Interfaces oder VLANs.

- **Management-Netz:** Die Weboberfläche und SSH-Zugänge des Hypervisors sollten möglichst nicht im normalen Client- oder Gastnetz erreichbar sein. Ein getrenntes Management-Netz reduziert die Systeme, von denen ein Angriff auf den Hypervisor überhaupt möglich ist.
- **VM-Netze:** Virtuelle Server können über eigene Bridges und VLANs in getrennte Netzwerksegmente eingebunden werden.
- **Storage-Netze:** Ceph, iSCSI oder Replikation erzeugen teilweise erheblichen Netzwerkverkehr. Separate Interfaces oder VLANs verhindern, dass dieser Verkehr das normale Management- oder VM-Netz unnötig belastet.
- **/etc/network/interfaces:** Wenn die Weboberfläche wegen einer fehlerhaften Netzwerkkonfiguration nicht mehr erreichbar ist, kann die Linux-Netzwerkkonfiguration direkt auf der Konsole analysiert und repariert werden.

### 8. Cluster, Quorum und Migration

Mehrere Hosts können zu einem Proxmox-Cluster verbunden werden. Dadurch werden wesentliche Konfigurationen über die Nodes verteilt und die Systeme gemeinsam verwaltet.

- **Corosync:** Corosync übernimmt einen wichtigen Teil der Kommunikation und Mitgliedschaftsverwaltung innerhalb des Clusters.
- **Quorum:** Das Mehrheitsprinzip verhindert, dass getrennte Teile eines Clusters unabhängig voneinander widersprüchliche Änderungen vornehmen.
- **VM-Migration:** Laufende VMs können zwischen Nodes verschoben werden. Wie viel dabei übertragen werden muss, hängt stark davon ab, ob lokaler oder gemeinsam genutzter Storage verwendet wird.
- **Shared Storage:** Liegt die virtuelle Festplatte bereits auf Ceph oder SAN, muss bei einer Live Migration nicht zusätzlich die gesamte virtuelle Disk zwischen den Hosts kopiert werden.

### 9. ZFS-Replikation und High Availability

ZFS-Replikation und Proxmox HA lösen unterschiedliche Probleme und können miteinander kombiniert werden.

- **ZFS-Replikation:** Nach einer ersten vollständigen Übertragung werden nur die Unterschiede zwischen ZFS-Snapshots übertragen. Dadurch kann ein zweiter Host relativ aktuell gehalten werden.
- **Replikationsintervall:** Da die Replikation nicht permanent synchron erfolgt, bestimmt das eingestellte Intervall den möglichen Datenverlust bei einem plötzlichen Ausfall.
- **HA-Ressourcen:** Proxmox kann festlegen, welche VMs nach einem Node-Ausfall automatisch auf einem anderen Host gestartet werden sollen.
- **Node Affinity:** Über Prioritäten lässt sich definieren, auf welchen Hosts bestimmte virtuelle Maschinen bevorzugt laufen sollen.
- **Fencing und Watchdog:** Vor einem automatischen Neustart einer VM muss der Cluster sicherstellen, dass die VM nicht gleichzeitig noch auf dem ausgefallenen beziehungsweise isolierten Host aktiv ist.

### 10. SAN, iSCSI und Multipath

Als Alternative zu lokalem ZFS und Ceph wurde klassisches Shared Storage mit TrueNAS und iSCSI behandelt.

- **ZVOL:** TrueNAS stellt ein ZFS-Volume als Blockgerät bereit, das anschließend per iSCSI an die Proxmox-Hosts exportiert werden kann.
- **Shared Storage:** Mehrere Proxmox-Nodes können auf denselben zentralen Speicher zugreifen. Das erleichtert Live-Migration und klassische Clusterkonzepte.
- **Multipath:** Produktiver SAN-Zugriff sollte nicht von einem einzigen Netzwerkpfad abhängen. Multipath kombiniert mehrere unabhängige Wege zum selben Storage-Gerät.
- **WWID:** Anstelle wechselnder Linux-Gerätenamen wie /dev/sde oder /dev/sdf wird das Storage-Gerät über seine eindeutige WWID identifiziert.
- **Pfadausfall:** Fällt eine Netzwerkverbindung aus, kann ein korrekt konfiguriertes Multipath-System den Zugriff über einen verbleibenden Pfad fortsetzen.

### 11. Ceph

Ceph stellt verteilten Storage direkt über mehrere Cluster-Nodes bereit. Dadurch wird kein separates klassisches SAN benötigt.

- **Datenverteilung:** Daten werden auf mehrere Systeme verteilt und entsprechend der konfigurierten Replikation mehrfach gespeichert.
- **Shared Storage:** Alle beteiligten Proxmox-Nodes greifen auf denselben logischen Storage-Bestand zu.
- **Netzwerk:** Ceph erzeugt zusätzlichen internen Datenverkehr. Netzwerkbandbreite und Latenz sind deshalb entscheidende Faktoren für die Gesamtleistung.
- **Kapazität:** Durch die Replikation steht nicht die gesamte physisch installierte Rohkapazität für Nutzdaten zur Verfügung.

### 12. Backup und Disaster Recovery

HA, Replikation und Snapshots reduzieren Ausfallzeiten, ersetzen aber kein unabhängiges Backup. Ein Fehler oder Angriff kann ansonsten sehr schnell auf mehrere replizierte Systeme übertragen werden.

- **Proxmox Backup Server:** PBS integriert sich direkt in Proxmox VE und bietet deduplizierte und komprimierte Backups von VMs und Containern.
- **ZFS Send/Receive:** ZFS-Snapshots können vollständig oder inkrementell auf ein anderes ZFS-System übertragen werden.
- **Offsite-Sicherung:** Mindestens eine Sicherung sollte räumlich getrennt vom Produktivsystem liegen, damit beispielsweise Brand, Diebstahl oder ein größerer Hardwareausfall nicht Produktion und Backup gleichzeitig trifft.
- **Offline- beziehungsweise getrennte Backups:** Eine Sicherung, auf die das Produktivsystem nicht dauerhaft schreiben kann, bietet zusätzlichen Schutz gegen Ransomware und Fehlbedienung.

### 13. Monitoring

Ein Virtualisierungscluster darf nicht nur anhand der grünen Symbole in der Proxmox-Weboberfläche überwacht werden. Gerade Storage- und Hardwareprobleme müssen aktiv kontrolliert werden.

- **ZFS Pool Status:** Ein Pool kann bereits DEGRADED sein, obwohl die darauf laufenden VMs zunächst weiterhin funktionieren.
- **SMART und SSD-Wearout:** Physische Datenträger müssen auf Fehlerwerte, Betriebsstunden und Verschleiß überwacht werden.
- **Multipath:** Ein SAN kann weiterhin funktionieren, obwohl bereits einer von zwei redundanten Pfaden ausgefallen ist. Ohne Monitoring würde dieser Zustand möglicherweise erst beim Ausfall des zweiten Pfades auffallen.
- **Checkmk:** Ein externes Monitoring sammelt diese Zustände zentral und kann Alarmierungen auslösen, bevor aus einer verlorenen Redundanz ein tatsächlicher Ausfall wird.

### 14. Sicherheit und Hardening

Der Proxmox-Hypervisor ist die zentrale Kontrolle über viele virtuelle Server. Ein kompromittierter Proxmox-Host kann deshalb wesentlich größere Auswirkungen haben als der Angriff auf eine einzelne virtuelle Maschine.

- **Separates Management-Netz:** Proxmox-Webinterface und SSH sollten möglichst nur aus einem administrativen Netz oder über VPN erreichbar sein. Anwender-PCs und normale Server benötigen normalerweise keinen direkten Zugriff auf die Managementoberfläche.
- **SSH Hardening:** Nicht benötigte oder unsichere Anmeldeverfahren werden abgeschaltet. Gleichzeitig sollte der SSH-Dienst nur aus Netzen erreichbar sein, aus denen tatsächlich administriert wird.
- **SSH Keys:** Schlüsselbasierte Anmeldung vermeidet die Übertragung und regelmäßige Eingabe administrativer Passwörter. Private Schlüssel müssen allerdings ebenso sorgfältig geschützt werden wie Passwörter.
- **Passwort-Login für root deaktivieren:** Ist eine funktionierende Schlüsselanmeldung eingerichtet, kann der direkte SSH-Login von root per Passwort abgeschaltet werden. Damit entfällt ein besonders offensichtliches Ziel für automatisierte Passwortangriffe.
- **Zugriff auf das Webinterface begrenzen:** Port 8006 sollte nicht unnötig aus beliebigen Netzen oder direkt aus dem Internet erreichbar sein. Firewall-Regeln und Netzwerksegmentierung beschränken die erreichbaren Management-Systeme.
- **Proxmox Firewall:** Die integrierte Firewall kann Regeln auf Datacenter-, Host- und VM-Ebene anwenden. Dadurch lassen sich sowohl Managementdienste als auch virtuelle Systeme gezielt absichern.
- **Zwei-Faktor-Authentifizierung:** Für administrative Konten ergänzt ein zweiter Faktor das Passwort. Ein gestohlenes oder erratenes Passwort reicht damit allein nicht mehr zur Anmeldung an der Proxmox-Oberfläche.

### 15. Updates und Troubleshooting

Proxmox basiert auf Debian. Deshalb sind Linux-Kenntnisse gerade bei Updates und Fehleranalysen ein wesentlicher Vorteil.

- **Updates:** Paket- und Kernelupdates werden über die Debian-Paketverwaltung eingespielt. Vor größeren Versionswechseln sollten Kompatibilität, Clusterzustand und vorhandene Backups geprüft werden.
- **ZFS Feature Upgrades:** Neue ZFS-Pool-Features sollten bewusst aktiviert werden. Ein einmal aktualisierter Pool kann gegebenenfalls nicht mehr mit älteren ZFS-Versionen importiert werden.
- **Kommandozeile:** Befehle wie zpool, zfs, smartctl, multipath, lsblk, ip und qm zeigen häufig wesentlich genauer als die Weboberfläche, was im System tatsächlich passiert.
- **Recovery:** Behandelt wurden unter anderem ausgefallene ZFS-Datenträger, beschädigte Netzwerkkonfigurationen, Clusterprobleme und das Wiederherstellen früherer Zustände.

## Fazit

Der Workshop verfolgt bewusst keinen Ansatz nach dem Motto „drei Hosts installieren und auf HA klicken“. Stattdessen werden die einzelnen Bausteine einer Proxmox-Infrastruktur getrennt betrachtet und anschließend kombiniert.

Dadurch wird nachvollziehbar, welche Aufgabe ZFS, Replikation, Ceph, SAN, Multipath, Cluster, HA und Backup jeweils übernehmen – und welche Funktion sie ausdrücklich nicht ersetzen.

Das Ziel ist eine Proxmox-Infrastruktur, deren Verhalten auch bei Festplatten-, Netzwerk-, Host- oder Storage-Ausfällen verstanden und vorhersehbar bleibt.

</section><section id="bkmrk-quellen-und-technisc">## Quellen und technische Referenzen

Die folgenden Quellen dienen als technische Referenz und Vertiefung zu den im Workshop behandelten Themen. Verlinkt sind überwiegend die offiziellen Dokumentationen der eingesetzten Projekte und Hersteller.

### Proxmox VE

- [ Proxmox VE Administration Guide ](https://pve.proxmox.com/pve-docs/pve-admin-guide.html) – Zentrale Dokumentation zu Installation, virtuellen Maschinen, Containern, Storage, Netzwerk, Cluster, High Availability, Firewall und Benutzerverwaltung.
- [ Proxmox VE Cluster Manager ](https://pve.proxmox.com/pve-docs/chapter-pvecm.html) – Technische Referenz zu Cluster-Aufbau, Corosync, Quorum und der Verwaltung mehrerer Proxmox-Nodes.
- [ Proxmox Cluster File System – pmxcfs ](https://pve.proxmox.com/pve-docs/chapter-pmxcfs.html) – Erläutert das verteilte Cluster-Dateisystem hinter `/etc/pve` und die gemeinsame Konfiguration innerhalb eines Proxmox-Clusters.
- [ Proxmox VE High Availability ](https://pve.proxmox.com/pve-docs/chapter-ha-manager.html) – Dokumentation zu HA-Ressourcen, Fencing, Watchdog, Failover und automatischem Wiederanlauf von virtuellen Maschinen.
- [ Proxmox VE Storage Replication ](https://pve.proxmox.com/pve-docs/chapter-pvesr.html) – Beschreibung der ZFS-basierten Replikation virtueller Festplatten zwischen Proxmox-Nodes.
- [ Proxmox VE Storage ](https://pve.proxmox.com/pve-docs/chapter-pvesm.html) – Überblick über lokale und gemeinsame Storage-Systeme wie ZFS, LVM, NFS, iSCSI, Ceph und Proxmox Backup Server.
- [ Proxmox VE Ceph ](https://pve.proxmox.com/pve-docs/chapter-pveceph.html) – Einrichtung und Betrieb von verteiltem Ceph-Storage innerhalb eines Proxmox-Clusters.
- [ Proxmox VE Network Configuration ](https://pve.proxmox.com/wiki/Network_Configuration) – Dokumentation zu Linux Bridges, VLANs, Bonds sowie Management-, VM- und Storage-Netzen.

### Proxmox Backup Server

- [ Proxmox Backup Server Dokumentation ](https://pbs.proxmox.com/docs/) – Offizielle Dokumentation zu Backup, Restore, Deduplizierung, Kompression, Pruning, Garbage Collection und Datastores.
- [ Proxmox VE und PBS Integration ](https://pbs.proxmox.com/docs/pve-integration.html) – Beschreibt die Einbindung eines Proxmox Backup Servers in einzelne Proxmox-Hosts oder Cluster.

### OpenZFS

- [ OpenZFS Dokumentation ](https://openzfs.github.io/openzfs-docs/) – Zentrale technische Referenz zu Pools, Datasets, Snapshots, Kompression, ARC, Scrubs, Resilvering und Fehlerbehandlung.
- [ OpenZFS – zpool status ](https://openzfs.github.io/openzfs-docs/man/master/8/zpool-status.8.html) – Referenz für die Prüfung des Gesundheitszustands eines ZFS-Pools sowie für Scrub- und Resilver-Vorgänge.
- [ OpenZFS – ZFS Snapshots ](https://openzfs.github.io/openzfs-docs/man/master/8/zfs-snapshot.8.html) – Dokumentation zur Erstellung und Verwaltung von ZFS-Snapshots.
- [ OpenZFS – Send and Receive ](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Operations/Send%20and%20Receive.html) – Beschreibung vollständiger und inkrementeller Übertragungen von ZFS-Snapshots für Replikation und Backup.

### TrueNAS, iSCSI und Multipath

- [ TrueNAS Dokumentation ](https://www.truenas.com/docs/) – Zentrale Dokumentation zu ZFS, Storage Pools, Datasets, ZVOLs, Netzwerk und iSCSI.
- [ TrueNAS – ZVOLs ](https://www.truenas.com/docs/scale/25.04/scaletutorials/datasets/addmanagezvols/) – Erläutert das Erstellen und Verwalten von ZFS Block Devices, die unter anderem als Grundlage für iSCSI-Storage dienen.
- [ TrueNAS – Networking und Multipath ](https://www.truenas.com/docs/solutions/optimizations/networking/) – Hinweise zu redundanten Storage-Netzen, iSCSI-Pfaden und Multipath-Konfigurationen.

### Checkmk Monitoring

- [ Checkmk Dokumentation ](https://docs.checkmk.com/latest/de/) – Zentrale Dokumentation zu Hosts, Services, Agenten, Monitoring-Regeln und Benachrichtigungen.
- [ Checkmk – Linux überwachen ](https://docs.checkmk.com/latest/de/agent_linux.html) – Installation und Betrieb des Checkmk-Agenten auf Linux-Systemen.
- [ Checkmk – Windows überwachen ](https://docs.checkmk.com/latest/de/agent_windows.html) – Installation und Betrieb des Checkmk-Agenten auf Windows-Systemen.

### Weitere technische Referenzen

- [ Debian Dokumentation ](https://www.debian.org/doc/) – Technische Grundlage für viele administrative Aufgaben auf dem Proxmox-Hostsystem.
- [ QEMU Dokumentation ](https://www.qemu.org/docs/master/) – Hintergrundinformationen zur Virtualisierungsschicht und zur virtuellen Hardware von QEMU/KVM.
- [ KVM – Kernel-based Virtual Machine ](https://www.linux-kvm.org/) – Hintergrundinformationen zur Linux-Virtualisierung mit KVM.

<small> Hinweis: Menübezeichnungen, Versionsstände und einzelne Funktionen können sich mit zukünftigen Versionen von Proxmox VE, OpenZFS, TrueNAS und Checkmk ändern. Für produktive Installationen sollte deshalb immer zusätzlich die Dokumentation der tatsächlich eingesetzten Version geprüft werden. </small>

</section><section id="bkmrk-im-kurs-verwendete-w">## Im Kurs verwendete wichtige Links

- [ Proxmox VE – Cluster Manager ](https://pve.proxmox.com/wiki/Cluster_Manager) – Offizielle Proxmox-Dokumentation zum Aufbau und zur Verwaltung eines Proxmox-Clusters, inklusive Corosync, Quorum und Cluster-Kommunikation.
- [ Proxmox VE – Full Mesh Network for Ceph Server ](https://pve.proxmox.com/wiki/Full_Mesh_Network_for_Ceph_Server) – Beschreibung eines direkten Full-Mesh-Netzwerks zwischen Ceph-Nodes, um Storage-Verkehr ohne zentralen Switch zwischen den Hosts zu übertragen.
- [ Proxmox VE – Deploy Hyper-Converged Ceph Cluster ](https://pve.proxmox.com/wiki/Deploy_Hyper-Converged_Ceph_Cluster) – Praxisanleitung zum Aufbau eines hyperkonvergenten Proxmox-Ceph-Clusters, bei dem Compute- und Storage-Funktionen auf denselben Nodes betrieben werden.

</section>

# Kostenvergleich Lizenzierte vs. Freie Software

<div class="container" id="bkmrk-analyse-%2F-meinungsbe"><article><header><span class="opinion-label">Analyse / Meinungsbeitrag</span># IT-Kostenvergleich für 20 Mitarbeiter: Microsoft 365 Cloud-only vs. Proxmox, Mailcow und OPNsense

> ##### Stand: September 2026 · Alle Preise netto und gerundet · Kalkulatorischer Stundensatz: 100 € pro Stunde
> 
> ##### Was kostet eine professionelle IT-Infrastruktur für einen Betrieb mit rund 20 Mitarbeitern tatsächlich? Der reine Vergleich einzelner Lizenzpreise reicht dafür nicht aus.
> 
> ##### In dieser Analyse werden zwei IT-Modelle gegenübergestellt, die 2026 tatsächlich in kleinen und mittelständischen Unternehmen eingesetzt werden: ein weitgehend serverloses Microsoft-365-Cloud-Modell und eine selbst betriebene Proxmox- und Open-Source-Infrastruktur.
> 
> ##### Betrachtet werden nacheinander die **laufenden Lizenzkosten**, **Hardware- und Betriebskosten**, **Einrichtungskosten**, **Kosten späterer Versionswechsel** sowie die **Total Cost of Ownership über fünf Jahre**.

</header><section>## Die beiden IT-Lösungen im Überblick

### System 1: Microsoft 365 Cloud-only

<div class="comparison-grid"><div class="card">- Microsoft Entra ID statt lokalem Active Directory
- SharePoint Online und OneDrive statt Fileserver
- Exchange Online
- Microsoft 365 Apps
- Intune
- Windows Autopilot
- Windows Autopatch
- Defender for Business
- Tactical RMM
- Hornetsecurity 365 Total Protection Plan 3
- optional Synology Active Backup for Microsoft 365
- OPNsense Business Edition
- Branchensoftware als SaaS
- keine lokale Virtualisierung

</div><div class="card">  
</div></div>### System 2: Proxmox und Open Source

<div class="comparison-grid"><div class="card">- Proxmox VE Basic
- Samba Active Directory
- Samba Fileserver
- Mailcow Dockerized
- LibreOffice / OnlyOffice
- Tactical RMM mit Amidaware Code Signing
- Proxmox Backup Server
- Checkmk Raw
- Mailpiler für Mail-Archivierung
- OPNsense Business Edition
- Branchensoftware als VM auf Proxmox

</div></div><div class="note">**Bewusst nicht betrachtet wird eine klassische Hybrid-Umgebung** aus Windows Server, Hyper-V, lokalem Active Directory, Exchange Hybrid und gleichzeitig Microsoft 365 Business Premium.</div>Bei einem 20-Mitarbeiter-Betrieb überschneiden sich dabei zahlreiche Funktionen. Active Directory, Exchange, Endpoint-Schutz und Geräteverwaltung sind zumindest teilweise bereits über Microsoft 365 Business Premium abgedeckt.

Ein Vergleich gegen eine solche Doppelstruktur würde die Microsoft-Seite entsprechend verteuern.

</section><section>## 1. Laufende Lizenz- und Subscriptionkosten

Grundlage sind **20 Benutzer und etwa 20 verwaltete Arbeitsplätze**.

<table><thead><tr><th>Funktion</th><th>System 1: Cloud-only</th><th>Kosten / Jahr</th><th>System 2: Open Source</th><th>Kosten / Jahr</th></tr></thead><tfoot><tr><th colspan="2">Summe wiederkehrend</th><th>ca. 6.900 €</th><th>mit kommerziellem EDR</th><th>ca. 1.600–1.900 €</th></tr></tfoot><tbody><tr><td>Identität, Fileserver, Mail, Office, Intune und Defender</td><td>Microsoft 365 Business Premium  
20 × 19,06 € × 12</td><td>**ca. 4.574 €**</td><td>Samba AD, Samba Fileserver, Mailcow und LibreOffice</td><td>0 €</td></tr><tr><td>Virtualisierung</td><td>keine</td><td>0 €</td><td>Proxmox VE Basic, 1 Sockel</td><td>370 €</td></tr><tr><td>Mail-Security, Archivierung und Backup</td><td>Hornetsecurity 365 Total Protection Plan 3  
20 × 7 € × 12</td><td>**ca. 1.680 €**</td><td>Mailpiler + Proxmox Backup Server</td><td>0 € Lizenzkosten</td></tr><tr><td>Fernwartung / RMM</td><td>Tactical RMM / Amidaware Tier 1</td><td>ca. 515 €</td><td>Tactical RMM / Amidaware Tier 1</td><td>ca. 515 €</td></tr><tr><td>Monitoring</td><td>Microsoft-Plattform und OPNsense-Bordmittel</td><td>0 €</td><td>Checkmk Raw</td><td>0 €</td></tr><tr><td>Firewall</td><td>OPNsense Business Edition</td><td>149 €</td><td>OPNsense Business Edition</td><td>149 €</td></tr><tr><td>Endpoint Security</td><td>Defender for Business in Business Premium</td><td>0 € zusätzlich</td><td>separates EDR erforderlich</td><td>ca. 600–900 €</td></tr></tbody></table>

### Alternative: Microsoft 365 mit lokalem Synology-Backup

Wer Microsoft 365 lieber lokal sichert, kann beispielsweise eine Synology DS925+ mit Active Backup for Microsoft 365 einsetzen. Für Active Backup fallen keine zusätzlichen Benutzerlizenzen an.

Damit sinken die jährlichen Softwarekosten im Cloud-Modell auf ungefähr **5.450 Euro**, sofern zusätzlich eine günstige Offsite-Kopie vorgesehen wird.

<div class="warning">Dabei fehlen jedoch Funktionen wie zusätzliche Mail-Continuity und revisionssichere Mail-Archivierung. Diese müssen gegebenenfalls separat realisiert werden.</div>### Lizenzkosten im direkten Vergleich

<table><thead><tr><th> </th><th>Microsoft Cloud-only</th><th>Proxmox / Open Source</th></tr></thead><tbody><tr><td>Kosten pro Jahr</td><td>ca. 6.900 € mit Hornetsecurity  
ca. 5.450 € mit lokalem Synology-Backup</td><td>ca. 1.035 € ohne EDR  
ca. 1.600–1.900 € mit EDR</td></tr><tr><td>Kosten pro Mitarbeiter / Monat</td><td>ca. 23–29 €</td><td>ca. 4–8 €</td></tr></tbody></table>

Betrachtet man ausschließlich die Lizenz- und Subscriptionkosten, ist die selbst betriebene Open-Source-Infrastruktur deutlich günstiger. Dieser Vergleich bildet jedoch noch nicht die gesamten Betriebskosten ab.

</section><section>## 2. Hardware, Strom und Infrastruktur

Beim Hardwarebedarf kehrt sich das Bild um: Das Cloud-Modell benötigt beim Kunden keinen klassischen Virtualisierungshost.

<table><thead><tr><th>Kostenblock</th><th>Microsoft Cloud-only</th><th>Proxmox / Open Source</th></tr></thead><tbody><tr><td>Server / Virtualisierungshost</td><td>–</td><td>ca. 10.000–12.000 €</td></tr><tr><td>Backup-Ziel</td><td>optional Synology DS925+ mit HDDs: ca. 1.200 €</td><td>Proxmox Backup Server: ca. 3.000–5.000 €</td></tr><tr><td>Firewall-Appliance</td><td>ca. 500–900 €</td><td>ca. 500–900 €</td></tr><tr><td>**Einmalige Hardwarekosten**</td><td>**ca. 500–2.100 €**</td><td>**ca. 15.500–18.000 €**</td></tr><tr><td>Strom Server und Backup</td><td>0 €</td><td>ca. 600–900 € / Jahr</td></tr><tr><td>USV, Klimatisierung, Serverschrank</td><td>0 €</td><td>ca. 100–200 € / Jahr</td></tr></tbody></table>

Über fünf Jahre werden für den Open-Source-Stack in dieser Kalkulation allein für Hardware, Strom und Infrastruktur ungefähr **19.000 bis 23.500 Euro** angesetzt.

Das Cloud-Modell liegt in diesem Bereich bei ungefähr **500 bis 2.100 Euro**.

<div class="note">Ein Hochverfügbarkeitscluster ist in dieser Kalkulation nicht berücksichtigt. Ein zusätzlicher Proxmox-Host würde die Hardwarekosten entsprechend erhöhen.</div></section><section>## 3. Einrichtungskosten

Als kalkulatorischer Dienstleistungssatz werden **100 Euro netto pro Stunde** verwendet.

### Einrichtung Microsoft 365 Cloud-only

Eine Cloud-Migration ist kein reiner Kopiervorgang. Berechtigungsmodelle ändern sich, Geräte werden von klassischem Domain Join auf Entra Join umgestellt und der Microsoft-365-Tenant muss abgesichert werden.

<table><thead><tr><th>Komponente</th><th>Arbeitszeit</th><th>Kosten</th></tr></thead><tfoot><tr><th>Gesamt</th><th>ca. 33–47 Stunden</th><th>ca. 3.300–4.700 €</th></tr></tfoot><tbody><tr><td>Tenant, Conditional Access, MFA und Admin-Konzept</td><td>4–6 Stunden</td><td>400–600 €</td></tr><tr><td>Intune-Baseline, Autopilot und Compliance</td><td>6–8 Stunden</td><td>600–800 €</td></tr><tr><td>SharePoint-Struktur und Datenmigration</td><td>8–12 Stunden</td><td>800–1.200 €</td></tr><tr><td>Mailmigration nach Exchange Online</td><td>6–10 Stunden</td><td>600–1.000 €</td></tr><tr><td>20 Geräte auf Entra Join umstellen</td><td>4–6 Stunden</td><td>400–600 €</td></tr><tr><td>Hornetsecurity konfigurieren</td><td>ca. 2 Stunden</td><td>200 €</td></tr><tr><td>Tactical RMM</td><td>ca. 1 Stunde</td><td>100 €</td></tr><tr><td>OPNsense</td><td>ca. 2 Stunden</td><td>200 €</td></tr></tbody></table>

### Einrichtung Proxmox und Open Source

Durch standardisierte Installationswege und vorbereitete Templates lässt sich die lokale Infrastruktur in dieser Kalkulation deutlich schneller bereitstellen.

<table><thead><tr><th>Komponente</th><th>Arbeitszeit</th><th>Kosten</th></tr></thead><tfoot><tr><th>Gesamt</th><th>ca. 15–17 Stunden</th><th>ca. 1.500–1.700 €</th></tr></tfoot><tbody><tr><td>Proxmox VE inklusive Proxmox Backup Server</td><td>ca. 2 Stunden</td><td>200 €</td></tr><tr><td>Samba DC und Fileserver inklusive Datenübernahme</td><td>ca. 3–4 Stunden</td><td>300–400 €</td></tr><tr><td>Mailcow inklusive Datenübernahme</td><td>ca. 4 Stunden</td><td>400 €</td></tr><tr><td>Checkmk Raw</td><td>ca. 1 Stunde</td><td>100 €</td></tr><tr><td>Tactical RMM</td><td>ca. 1 Stunde</td><td>100 €</td></tr><tr><td>OPNsense</td><td>ca. 2 Stunden</td><td>200 €</td></tr><tr><td>Mail-Archivierung und EDR-Rollout</td><td>ca. 2–3 Stunden</td><td>200–300 €</td></tr></tbody></table>

### Einrichtungskosten im direkten Vergleich

<table><thead><tr><th> </th><th>Microsoft Cloud-only</th><th>Proxmox / Open Source</th></tr></thead><tbody><tr><td>Arbeitsaufwand</td><td>33–47 Stunden</td><td>15–17 Stunden</td></tr><tr><td>Einrichtungskosten</td><td>**3.300–4.700 €**</td><td>**1.500–1.700 €**</td></tr></tbody></table>

</section><section>## 4. Kosten von Generations- und Versionswechseln

### Microsoft Cloud-only

Bei Exchange Online, SharePoint, Entra ID und Intune gibt es keinen klassischen Server-Generationswechsel beim Kunden mehr. Microsoft aktualisiert die Plattform fortlaufend.

<table><thead><tr><th>Komponente</th><th>Aufwand</th><th>Kosten</th></tr></thead><tfoot><tr><th>Gesamt pro Jahr</th><th>ca. 4–5 Stunden</th><th>ca. 400–500 €</th></tr></tfoot><tbody><tr><td>Windows Feature Updates über Intune / Autopatch</td><td>ca. 2–3 Stunden / Jahr</td><td>200–300 €</td></tr><tr><td>OPNsense Major Upgrade</td><td>ca. 1 Stunde</td><td>100 €</td></tr><tr><td>Tactical RMM Upgrade</td><td>ca. 1 Stunde</td><td>100 €</td></tr><tr><td>Neue Server- oder CAL-Lizenzen</td><td>–</td><td>0 €</td></tr></tbody></table>

### Proxmox und Open Source

Versionswechsel erfolgen weitgehend über Paketverwaltung, dokumentierte Upgrade-Pfade oder Docker.

<table><thead><tr><th>Komponente</th><th>Aufwand</th><th>Kosten</th></tr></thead><tfoot><tr><th>Generationswechsel</th><th>max. 7 Stunden plus Client-Updates</th><th>max. 700 € plus 200–300 € / Jahr</th></tr></tfoot><tbody><tr><td>Proxmox VE</td><td>max. 1 Stunde</td><td>100 €</td></tr><tr><td>Proxmox Backup Server</td><td>max. 1 Stunde</td><td>100 €</td></tr><tr><td>Samba DC / Fileserver</td><td>max. 1 Stunde</td><td>100 €</td></tr><tr><td>Mailcow</td><td>max. 1 Stunde</td><td>100 €</td></tr><tr><td>Checkmk Raw</td><td>max. 1 Stunde</td><td>100 €</td></tr><tr><td>Tactical RMM</td><td>max. 1 Stunde</td><td>100 €</td></tr><tr><td>OPNsense</td><td>max. 1 Stunde</td><td>100 €</td></tr><tr><td>Windows Feature Updates auf Clients</td><td>ca. 2–3 Stunden / Jahr</td><td>200–300 €</td></tr></tbody></table>

</section><section>## 5. Laufender Betrieb

Einer der wichtigsten Kostenblöcke ist der laufende Betrieb. In reinen Lizenzvergleichen wird dieser häufig nicht berücksichtigt.

<table><thead><tr><th>Tätigkeit</th><th>Microsoft Cloud-only</th><th>Proxmox / Open Source</th></tr></thead><tbody><tr><td>Server-, Hypervisor- und Backup-Updates</td><td>–</td><td>ja</td></tr><tr><td>Mailserver-Pflege</td><td>–</td><td>ja</td></tr><tr><td>Defender, Intune, Entra und Hornetsecurity prüfen</td><td>ja</td><td>–</td></tr><tr><td>Firewall und Netzwerk</td><td>ja</td><td>ja</td></tr><tr><td>Hardware, RAID, Platten und USV überwachen</td><td>nur Firewall</td><td>ja</td></tr><tr><td>**Geschätzter Aufwand ohne Anwendersupport**</td><td>**ca. 2–4 Stunden / Monat**</td><td>**ca. 6–10 Stunden / Monat**</td></tr><tr><td>**Kosten pro Jahr bei 100 €/h**</td><td>**ca. 2.400–4.800 €**</td><td>**ca. 7.200–12.000 €**</td></tr></tbody></table>

Anwendersupport ist in beiden Modellen nicht eingerechnet.

</section><section>## Gesamtkosten über fünf Jahre

<table><thead><tr><th>Kostenblock</th><th>Microsoft Cloud-only</th><th>Proxmox / Open Source</th></tr></thead><tfoot><tr><th>Gesamtkosten über 5 Jahre</th><th>ca. 53.000–68.000 €</th><th>ca. 67.000–96.000 €</th></tr><tr><th>pro Mitarbeiter / Monat</th><th>ca. 44–57 €</th><th>ca. 56–80 €</th></tr></tfoot><tbody><tr><td>Lizenz- und Subscriptionkosten</td><td>ca. 34.500 €</td><td>ca. 8.800 €</td></tr><tr><td>Hardware, Strom und Infrastruktur</td><td>ca. 1.000–2.000 €</td><td>ca. 19.000–23.500 €</td></tr><tr><td>Einrichtung</td><td>ca. 3.300–4.700 €</td><td>ca. 1.500–1.700 €</td></tr><tr><td>Versions- und Generationswechsel</td><td>ca. 2.000–2.500 €</td><td>ca. 1.700–2.200 €</td></tr><tr><td>Betrieb ohne Anwendersupport</td><td>ca. 12.000–24.000 €</td><td>ca. 36.000–60.000 €</td></tr></tbody></table>

### Kaufmännische Kernaussage dieser Kalkulation

Betrachtet man ausschließlich Lizenzkosten, ist der Proxmox- und Open-Source-Stack deutlich günstiger.

Werden jedoch zusätzlich Serverhardware, Backup-Hardware, Strom, Infrastruktur und insbesondere laufende Betriebsstunden berücksichtigt, verschiebt sich die Rechnung.

In dieser Kalkulation liegt die Microsoft-365-Cloud-Lösung über fünf Jahre bei etwa 53.000 bis 68.000 Euro, der selbst betriebene Open-Source-Stack bei etwa 67.000 bis 96.000 Euro.

Dieser Unterschied basiert wesentlich auf den angesetzten Hardware- und Betriebsstunden und ist deshalb stark von der tatsächlichen Betriebsorganisation abhängig.

</section><section>## Was eine Microsoft-365-Cloud-only-Lösung voraussetzt

Ein serverloses Cloud-Konzept funktioniert nicht in jeder Umgebung. Vor einer Entscheidung sollten insbesondere folgende Punkte geprüft werden:

- **Branchensoftware:** Gibt es eine SaaS-Version oder benötigt die Anwendung weiterhin einen Server?
- **Datenmengen:** CAD-Daten, Videoarchive oder große Bildbestände eignen sich nicht immer ideal für SharePoint und OneDrive.
- **Internetanbindung:** Eine zweite Internetleitung oder LTE-/5G-Fallback sollte berücksichtigt werden.
- **Drucker und Scanner:** klassische Scan-to-Folder-Konzepte müssen gegebenenfalls ersetzt werden.
- **WLAN-Authentifizierung:** ohne lokalen NPS/RADIUS werden alternative Authentifizierungskonzepte benötigt.
- **Telefonanlage:** eine lokale PBX kann zum letzten lokalen Serversystem werden.
- **Mail-Archivierung:** Backup und revisionssichere Archivierung sind getrennte Anforderungen.
- **Sicherheitskonfiguration:** Conditional Access, MFA, Break-Glass-Konten und LAPS müssen aktiv konfiguriert werden.
- **Datenschutz:** Auftragsverarbeitung, Verfahrensverzeichnis und Datenstandorte müssen dokumentiert werden.
- **Exit-Strategie:** Unternehmen sollten bereits vor dem Einstieg festlegen, wie Daten und Identitäten später wieder exportiert werden können.

</section><section>## Fazit: Cloud oder Proxmox? Entscheidend ist die Gesamtrechnung

Wer ausschließlich Lizenzkosten betrachtet, sieht im Proxmox- und Open-Source-Stack einen erheblichen Kostenvorteil.

Eine vollständige Total-Cost-of-Ownership-Betrachtung umfasst jedoch auch Serverhardware, Backup-Systeme, Strom, USV, Infrastruktur, Einrichtung, Updates und den laufenden Administrationsaufwand.

In der hier dargestellten Kalkulation liegt das Microsoft-365-Cloud-Modell über fünf Jahre niedriger, weil zentrale Infrastruktur, Hardwarebetrieb und Plattformupdates an Microsoft beziehungsweise weitere Cloud-Anbieter ausgelagert werden.

Der Preis dafür ist eine stärkere Abhängigkeit von Cloud-Diensten und externen Anbietern.

Eine selbst betriebene Proxmox-, Samba-, Mailcow- und OPNsense-Umgebung kann dagegen sinnvoll sein, wenn **Datenhoheit, lokale Branchensoftware, große Datenbestände oder Unabhängigkeit von Cloud-Plattformen** wichtiger sind als eine möglichst geringe Betriebsverantwortung.

Entscheidend ist deshalb nicht der einzelne Lizenzpreis, sondern die **Total Cost of Ownership über mehrere Jahre** und die Frage, wer die technische Verantwortung übernehmen soll.

</section><section>## Häufige Fragen zum IT-Kostenvergleich

### Was kostet Microsoft 365 Business Premium für 20 Mitarbeiter?

Bei einem angesetzten Preis von 19,06 Euro netto pro Benutzer und Monat ergeben sich für 20 Benutzer rund **4.574 Euro pro Jahr**.

### Muss Microsoft 365 zusätzlich gesichert werden?

Geschäftskritische Daten aus Exchange Online, OneDrive, SharePoint und Teams sollten unabhängig gesichert werden. Möglich sind beispielsweise Cloud-Backup-Dienste oder eine lokale Synology mit Active Backup for Microsoft 365.

### Braucht ein Unternehmen mit 20 Mitarbeitern noch einen Server?

Das hängt insbesondere von der Branchensoftware und den Datenmengen ab. Wenn alle Anwendungen als SaaS verfügbar sind und Daten in Microsoft 365 abgelegt werden können, kann ein lokaler Server entfallen.

### Ist Open Source für Unternehmen kostenlos?

Viele Open-Source-Produkte verursachen keine klassischen Lizenzkosten. Trotzdem entstehen Kosten für Hardware, Einrichtung, Administration, Backup, Strom, Monitoring, Endpoint-Security und gegebenenfalls Support.

### Was kostet Proxmox VE für kleine Unternehmen?

In dieser Kalkulation wird für Proxmox VE Basic mit rund **370 Euro pro belegtem CPU-Sockel und Jahr** gerechnet.

### Was kostet OPNsense Business Edition?

In dieser Kalkulation werden rund **149 Euro pro Installation und Jahr** angesetzt, jeweils zuzüglich Hardware.

### Was kostet Tactical RMM mit Code Signing?

Für Amidaware Tier 1 werden hier rund **600 US-Dollar pro Jahr** kalkuliert. Unterstützt werden bis zu 199 Endpunkte, Code Signing ist enthalten.

### Warum ist die Cloud-Migration zunächst teurer?

Eine Migration zu Microsoft 365 verändert die Struktur: Fileserver-Berechtigungen müssen für SharePoint neu geplant, Geräte auf Entra Join umgestellt und Sicherheitsrichtlinien für Intune und Conditional Access eingerichtet werden.

### Warum können Open-Source-Upgrades günstig sein?

Proxmox, Samba, Mailcow und andere Linux-basierte Systeme verfügen über Paketverwaltung, dokumentierte Upgradepfade oder Docker-basierte Aktualisierungen. Bei standardisierten Umgebungen kann der technische Aufwand deshalb gering bleiben.

</section></article></div>

# Die 20 größten Exchange-Skandale, Ausfälle und Sicherheitslücken in 10 Jahren

<article id="bkmrk-microsoft-exchange-g" style="max-width:1100px;margin:0 auto;font-family:Arial, Helvetica, sans-serif;line-height:1.65;color:#252525;"><header style="margin-bottom:30px;">> ##### Microsoft Exchange gehört seit Jahrzehnten zu den wichtigsten E-Mail-Plattformen für Unternehmen. Gleichzeitig war die Plattform immer wieder von **kritischen Sicherheitslücken, erfolgreichen Angriffen und teilweise weltweiten Ausfällen** betroffen.
> 
> ##### Diese Übersicht zeigt die 20 bedeutendsten Vorfälle rund um **Exchange Server On-Premises, Exchange-Hybridumgebungen und Exchange Online in Microsoft 365**. Berücksichtigt werden bekannte Schwachstellen, tatsächliche Angriffe, Cloud-Ausfälle und organisatorische Versäumnisse. Stand der Übersicht: **17. September 2026**.

</header>**Bewertung:**

🔴 Kritische Sicherheitslücke oder erfolgreicher Angriff  
🟠 Hohes Sicherheits- oder Verfügbarkeitsrisiko  
🟡 Bedeutender Ausfall, Softwarefehler oder Governance-Vorfall

<nav style="background:#fafafa;border:1px solid #dddddd;padding:20px;margin:25px 0 35px 0;">## Inhaltsverzeichnis

1. [Exchange Server On-Premises und Hybrid](#bkmrk-exchange-server-on-p)
2. [Exchange Online und Microsoft 365](#bkmrk-exchange-online-und-)
3. [Was zeigen die Exchange-Vorfälle?](#bkmrk-was-zeigen-die-excha)
4. [Exchange-Sicherheitscheck](#bkmrk-kompakte-exchange-si)
5. [Häufige Fragen](#bkmrk-h%C3%A4ufige-fragen-zu-ex)

</nav><section id="bkmrk-exchange-server-on-p">## Exchange Server On-Premises und Hybrid

<section id="bkmrk-%E2%98%90-1.-proxylogon-und-" style="margin:30px 0;">### ☐ 1. ProxyLogon und HAFNIUM: massenhafte Übernahme von Exchange-Servern

**Zeitpunkt:** März 2021  
**Einstufung:** 🔴 Kritische Zero-Day-Angriffskette  
**Betroffen:** Exchange Server 2010, 2013, 2016 und 2019

Die Schwachstellen CVE-2021-26855, CVE-2021-26857, CVE-2021-26858 und CVE-2021-27065 ermöglichten den Zugriff auf Exchange-Server ohne reguläre Anmeldung. Angreifer konnten Schadcode mit SYSTEM-Rechten ausführen, E-Mails entwenden und dauerhafte Webshells auf den Servern hinterlegen.

Besonders kritisch war, dass die spätere Installation der Updates bereits vorhandene Webshells nicht automatisch beseitigte. Ein gepatchter Server konnte daher weiterhin kompromittiert sein.

<div style="background:#fff7ef;border-left:4px solid #e87511;padding:14px 18px;">**Prüfpunkte:**- Aktuelles Cumulative Update und sämtliche Security Updates installieren.
- IIS-, ECP-, OAB- und EWS-Protokolle forensisch untersuchen.
- Exchange-Verzeichnisse auf unbekannte ASPX-Webshells prüfen.
- Administrator- und Dienstkonten nach einer Kompromittierung ändern.

</div>**Quellen:** [Microsoft Incident Guidance](https://www.microsoft.com/en-us/msrc/blog/2021/03/guidance-for-responders-investigating-and-remediating-on-premises-exchange-server-vulnerabilities) | [CISA Advisory AA21-062A](https://www.cisa.gov/news-events/cybersecurity-advisories/aa21-062a)

</section><section id="bkmrk-%E2%98%90-2.-proxyshell%3A-vol" style="margin:30px 0;">### ☐ 2. ProxyShell: vollständige Remoteübernahme

**Zeitpunkt:** 2021  
**Einstufung:** 🔴 Aktiv ausgenutzte RCE-Angriffskette  
**CVE:** CVE-2021-34473, CVE-2021-34523 und CVE-2021-31207

ProxyShell kombinierte drei Schwachstellen. Angreifer konnten die Exchange-Authentifizierung umgehen, Berechtigungen erweitern und schließlich Schadcode oder Webshells ausführen. Die Angriffskette wurde später unter anderem zur Verteilung von Ransomware und Kryptominern eingesetzt.

- OWA und ECP nicht unnötig direkt im Internet veröffentlichen.
- IIS-Protokolle auf ungewöhnliche Autodiscover- und ECP-Aufrufe prüfen.
- Exchange PowerShell auf erforderliche Systeme und Administratoren begrenzen.

**Quellen:** [CVE-2021-34473](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2021-34473) | [CVE-2021-34523](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2021-34523) | [CVE-2021-31207](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2021-31207)

</section><section id="bkmrk-%E2%98%90-3.-proxynotshell%3A-" style="margin:30px 0;">### ☐ 3. ProxyNotShell: erneut ausgenutzte Exchange-Zero-Days

**Zeitpunkt:** September 2022  
**Einstufung:** 🔴 SSRF und Remote Code Execution  
**CVE:** CVE-2022-41040 und CVE-2022-41082

Ein Angreifer mit gültigen Zugangsdaten konnte über Autodiscover und die Exchange-PowerShell Befehle auf dem Server ausführen. Microsoft stellte zunächst mehrfach angepasste URL-Rewrite-Regeln bereit, bevor vollständige Sicherheitsupdates verfügbar waren.

- Aktuelle Exchange-Sicherheitsupdates installieren.
- Frühere provisorische Rewrite-Regeln kontrollieren und dokumentieren.
- Exchange PowerShell nicht allgemein aus dem Internet erreichbar machen.

**Quelle:** [Microsoft-Analyse zu ProxyNotShell](https://www.microsoft.com/en-us/security/blog/2022/09/30/analyzing-attacks-using-the-exchange-vulnerabilities-cve-2022-41040-and-cve-2022-41082/)

</section><section id="bkmrk-%E2%98%90-4.-cve-2025-53786%3A" style="margin:30px 0;">### ☐ 4. CVE-2025-53786: Vom lokalen Exchange in die Microsoft-Cloud

**Zeitpunkt:** August 2025  
**Einstufung:** 🔴 Kritische Hybrid-Rechteausweitung

In bestimmten Hybridbereitstellungen konnte ein Angreifer mit administrativem Zugriff auf den lokalen Exchange-Server möglicherweise seine Berechtigungen auf Exchange Online ausweiten. Damit konnte die Kompromittierung eines On-Premises-Servers zum Sicherheitsvorfall in der Cloud werden.

- Aktuelle Exchange-Sicherheitsupdates installieren.
- Microsofts dedizierte Exchange-Hybridanwendung einrichten.
- Alte gemeinsam verwendete Service Principals entfernen.
- Entra- und Exchange-Auditlogs auf ungewöhnliche App-Zugriffe prüfen.

**Quellen:** [Microsoft CVE-2025-53786](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2025-53786) | [CISA-Warnung](https://www.cisa.gov/news-events/alerts/2025/08/06/microsoft-releases-guidance-high-severity-vulnerability-cve-2025-53786-hybrid-exchange-deployments)

</section><section id="bkmrk-%E2%98%90-5.-owassrf%3A-umgehu" style="margin:30px 0;">### ☐ 5. OWASSRF: Umgehung bisheriger ProxyNotShell-Schutzmaßnahmen

**Zeitpunkt:** Dezember 2022  
**Einstufung:** 🔴 Remote Code Execution  
**CVE:** CVE-2022-41080 und CVE-2022-41082

Die Angriffskette zeigte, dass die bisherigen URL-Filter und ProxyNotShell-Schutzmaßnahmen nicht alle Angriffswege beseitigten. Angreifer konnten über Outlook Web Access erneut die Exchange-PowerShell erreichen und Code ausführen.

**Quellen:** [CVE-2022-41080](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2022-41080) | [CVE-2022-41082](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2022-41082)

</section><section id="bkmrk-%E2%98%90-6.-cve-2020-0688%3A-" style="margin:30px 0;">### ☐ 6. CVE-2020-0688: statische kryptografische Schlüssel

**Zeitpunkt:** Februar 2020  
**Einstufung:** 🔴 Remote Code Execution nach Anmeldung

Exchange verwendete bekannte statische Schlüssel zur Absicherung von ViewState-Daten. Ein Angreifer mit den Zugangsdaten eines beliebigen Postfachbenutzers konnte präparierte Daten erzeugen und unter Umständen Code mit SYSTEM-Rechten ausführen.

**Quellen:** [Microsoft CVE-2020-0688](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2020-0688) | [Microsoft Security Update](https://support.microsoft.com/en-us/servicing/exchange/server/update/2020/description-of-the-security-update-for-microsoft-exchange-server-2019-and-2016-february-11-2020)

</section><section id="bkmrk-%E2%98%90-7.-privexchange%3A-v" style="margin:30px 0;">### ☐ 7. PrivExchange: von Exchange zum Domain Admin

**Zeitpunkt:** 2018 und 2019  
**Einstufung:** 🔴 NTLM Relay und Rechteausweitung  
**CVE:** CVE-2018-8581

Durch weitreichende Exchange-Berechtigungen im Active Directory und einen NTLM-Relay-Angriff konnte die Kompromittierung des Exchange-Servers bis zur vollständigen Übernahme der Windows-Domäne führen.

- LDAP Signing und Channel Binding aktivieren.
- NTLM-Verwendung soweit möglich reduzieren.
- Exchange-Berechtigungen im Active Directory überprüfen.

**Quelle:** [Microsoft CVE-2018-8581](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2018-8581)

</section><section id="bkmrk-%E2%98%90-8.-cve-2024-21410%3A" style="margin:30px 0;">### ☐ 8. CVE-2024-21410: NTLM-Leak und Rechteausweitung

**Zeitpunkt:** Februar 2024  
**Einstufung:** 🔴 Kritische Rechteausweitung  
**CVSS:** 9,8

Präparierte Nachrichten konnten die Weitergabe von NTLM-Informationen auslösen. Diese ließen sich möglicherweise für Relay-Angriffe verwenden. Microsoft aktivierte im Rahmen der Absicherung Extended Protection standardmäßig für aktuelle Exchange-Versionen.

- Extended Protection überprüfen.
- Ausgehende SMB-Verbindungen ins Internet blockieren.
- NTLM-Relay-Schutz für LDAP, IIS und weitere Dienste aktivieren.

**Quelle:** [Microsoft CVE-2024-21410](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2024-21410)

</section><section id="bkmrk-%E2%98%90-9.-exchange-y2k22%3A" style="margin:30px 0;">### ☐ 9. Exchange-Y2K22: Mailtransport zum Jahreswechsel gestoppt

**Zeitpunkt:** 1. Januar 2022  
**Einstufung:** 🟡 Schwerer Softwarefehler

Die Versionsnummer der Exchange-Malware-Scanning-Engine passte ab dem Jahr 2022 nicht mehr in den vorgesehenen Integer-Wert. Dadurch liefen Transportwarteschlangen voll und E-Mails wurden nicht mehr zugestellt.

- Transportwarteschlangen kontinuierlich überwachen.
- Nicht nur Port 25, sondern die tatsächliche Zustellung testen.
- Notfallverfahren für Probleme mit der Malware-Engine dokumentieren.

**Quelle:** [Analyse des Exchange-Y2K22-Fehlers](https://petri.com/microsoft-delivers-emergency-fix-for-exchange-y2k22-bug/)

</section><section id="bkmrk-%E2%98%90-10.-cve-2026-42897" style="margin:30px 0;">### ☐ 10. CVE-2026-42897: aktiv ausgenutzte OWA-Sicherheitslücke

**Zeitpunkt:** Mai bis Juli 2026  
**Einstufung:** 🔴 Aktiv ausgenutzte Schwachstelle  
**CVSS:** 8,1

Eine präparierte E-Mail konnte beim Öffnen in Outlook Web Access unter bestimmten Bedingungen JavaScript im Browserkontext des Benutzers ausführen. Betroffen waren Exchange 2016, Exchange 2019 und Exchange Server Subscription Edition.

- Juli-2026-Sicherheitsupdates installieren.
- Exchange Emergency Mitigation Service aktivieren.
- OWA nicht mit Internet Explorer oder IE-Modus verwenden.

**Quellen:** [Microsoft CVE-2026-42897](https://msrc.microsoft.com/update-guide/vulnerability/CVE-2026-42897) | [Exchange-Sicherheitsupdates 2026](https://techcommunity.microsoft.com/blog/exchange/released-june-2026-exchange-server-security-updates/4524491) | [CISA KEV-Hinweis](https://www.cisa.gov/news-events/alerts/2026/05/15/cisa-adds-one-known-exploited-vulnerability-catalog)

</section></section><section id="bkmrk-exchange-online-und-">## Exchange Online und Microsoft 365

<section id="bkmrk-%E2%98%90-11.-storm-0558%3A-ge" style="margin:30px 0;">### ☐ 11. Storm-0558: gestohlener Microsoft-Schlüssel öffnet Behördenpostfächer

**Zeitpunkt:** Mai bis Juni 2023  
**Einstufung:** 🔴 Cloud-Sicherheits- und Governance-Skandal

Ein chinesischer Angreifer verwendete einen erlangten Microsoft-Consumer-Signaturschlüssel und eine fehlerhafte Tokenprüfung. Damit wurden Tokens erzeugt, die den Zugriff auf Exchange Online und Outlook Web Access ermöglichten. Betroffen waren etwa 25 Organisationen, darunter westliche Regierungsstellen.

- Unified Audit Log und MailItemsAccessed aktivieren.
- Ausreichende Aufbewahrungsdauer für Auditdaten konfigurieren.
- Ungewöhnliche OWA-, Graph- und EWS-Zugriffe überwachen.

**Quelle:** [Microsofts Storm-0558-Bericht](https://www.microsoft.com/en-us/msrc/blog/2023/07/microsoft-mitigates-china-based-threat-actor-storm-0558-targeting-of-customer-email)

</section><section id="bkmrk-%E2%98%90-12.-midnight-blizz" style="margin:30px 0;">### ☐ 12. Midnight Blizzard kompromittiert Microsofts eigene E-Mail-Umgebung

**Zeitpunkt:** November 2023 bis Januar 2024  
**Einstufung:** 🔴 Sicherheits- und Governance-Skandal

Russische Angreifer kompromittierten per Password Spray ein altes Microsoft-Testkonto ohne MFA. Anschließend missbrauchten sie privilegierte OAuth-Anwendungen und erhielten Zugriff auf Exchange-Online-Postfächer von Führungskräften sowie Mitarbeitern aus Sicherheits- und Rechtsabteilungen.

- MFA ausnahmslos auch für Test- und Dienstkonten erzwingen.
- Ungenutzte Mandanten und Service Principals entfernen.
- ApplicationImpersonation und full\_access\_as\_app kontrollieren.
- OAuth-Anwendungen mit Zugriff auf EWS oder Microsoft Graph überwachen.

**Quellen:** [Microsoft Incident Guidance](https://www.microsoft.com/en-us/security/blog/2024/01/25/midnight-blizzard-guidance-for-responders-on-nation-state-attack/) | [Bericht zum Angriff](https://apnews.com/article/84610492e56778767116a3f89f7ff658)

</section><section id="bkmrk-%E2%98%90-13.-weltweite-outl" style="margin:30px 0;">### ☐ 13. Weltweite Outlook- und Exchange-Störung EX1464935

**Zeitpunkt:** September 2026  
**Einstufung:** 🟡 Weltweiter Cloud-Ausfall

Anwender konnten sich nicht anmelden, Postfächer synchronisierten nicht und Nachrichten ließen sich teilweise weder versenden noch empfangen. Die Störung betraf eine zentrale Komponente der Exchange-Online-Infrastruktur.

- Incident EX1464935 für SLA- und Risikonachweise archivieren.
- Notfallkommunikation unabhängig von Microsoft 365 bereithalten.
- Anwender vor dem mehrfachen Versand wartender E-Mails warnen.

**Quelle:** [Bericht zur weltweiten Outlook-Störung](https://www.welt.de/newsticker/dpa_nt/infoline_nt/netzwelt/article6a95e68e518a586e1855ebf5/weltweite-stoerung-bei-microsoft-outlook-legt-e-mail-lahm.html)

</section><section id="bkmrk-%E2%98%90-14.-exchange-onlin" style="margin:30px 0;">### ☐ 14. Exchange Online und Outlook fallen weltweit aus

**Zeitpunkt:** 25. und 26. November 2024  
**Einstufung:** 🟡 Großer Cloud-Ausfall

Eine Änderung in Microsofts Infrastruktur beeinträchtigte Exchange Online, Outlook und die Kalenderfunktionen von Teams. Die Wiederherstellung dauerte deutlich länger als ursprünglich erwartet.

- Kritische Kontaktdaten außerhalb von Exchange speichern.
- Alternative Kommunikationswege regelmäßig testen.
- Service-Health-Meldungen für mögliche SLA-Ansprüche archivieren.

**Quelle:** [AP-Bericht zum Microsoft-365-Ausfall](https://apnews.com/article/7808d4c35b04896f6c2b2ee10e6141eb)

</section><section id="bkmrk-%E2%98%90-15.-fehlerhafte-co" style="margin:30px 0;">### ☐ 15. Fehlerhafte Codeänderung legt Microsoft 365 lahm

**Zeitpunkt:** 1. März 2025  
**Einstufung:** 🟡 Globaler Cloud-Ausfall  
**Incident:** MO1020913

Outlook, Exchange und weitere Microsoft-365-Dienste waren über mehrere Stunden nicht erreichbar. Microsoft führte den Vorfall auf eine problematische Codeänderung zurück und stellte die Dienste durch einen Rollback wieder her.

**Quelle:** [Analyse zu MO1020913](https://www.techrepublic.com/article/microsoft-outage-office-365-teams/)

</section><section id="bkmrk-%E2%98%90-16.-14-st%C3%BCndiger-e" style="margin:30px 0;">### ☐ 16. 14-stündiger Exchange-Online-Ausfall

**Zeitpunkt:** 11. und 12. September 2025  
**Einstufung:** 🟡 Regionaler Großausfall  
**Incident:** EX1151485

Anmeldung, Mailboxzugriff, Kalender und Mailzustellung waren vor allem in Nordamerika beeinträchtigt. Als Ursache wurde eine unerwartet hohe CPU-Auslastung in Teilen der Exchange-Online-Infrastruktur genannt.

**Quelle:** [Bericht zu EX1151485](https://www.techradar.com/pro/microsoft-addressing-outlook-outage-across-north-america)

</section><section id="bkmrk-%E2%98%90-17.-exchange-onlin" style="margin:30px 0;">### ☐ 17. Exchange Online durch Layer-7-DDoS beeinträchtigt

**Zeitpunkt:** Juni 2023  
**Einstufung:** 🟠 Angriff auf die Verfügbarkeit

Die Gruppe Storm-1359 führte HTTP-Flood-, Cache-Bypass- und Slowloris-Angriffe gegen Microsoft-Dienste durch. Microsoft bestätigte zeitweise Einschränkungen der Verfügbarkeit, sah jedoch keine Hinweise auf den Zugriff auf Kundendaten.

**Quelle:** [Microsofts DDoS-Stellungnahme](https://www.microsoft.com/en-us/msrc/blog/2023/06/microsoft-response-to-layer-7-distributed-denial-of-service-ddos-attacks)

</section><section id="bkmrk-%E2%98%90-18.-infrastrukturf" style="margin:30px 0;">### ☐ 18. Infrastrukturfehler bei Exchange Online im Januar 2026

**Zeitpunkt:** 22. Januar 2026  
**Einstufung:** 🟡 Großer regionaler Ausfall

Teile der nordamerikanischen Infrastruktur verarbeiteten den Datenverkehr nicht mehr korrekt. Benutzer erhielten unter anderem den temporären SMTP-Fehler `451 4.3.2`. Microsoft musste den Verkehr auf funktionsfähige Infrastruktur umleiten.

- Eigene Systeme müssen temporäre SMTP-Fehler automatisch wiederholen.
- Monitoring muss 4xx-Verzögerungen von endgültigen 5xx-Fehlern unterscheiden.
- Bei Cloud-Ausfällen nicht vorschnell lokale Outlook-Profile löschen.

**Quelle:** [Bericht zum Ausfall](https://people.com/outlook-365-outage-reported-by-tens-of-thousands-microft-blames-infrastructure-11890996)

</section><section id="bkmrk-%E2%98%90-19.-exchange-onlin" style="margin:30px 0;">### ☐ 19. Exchange Online verschiebt legitime E-Mails in Quarantäne

**Zeitpunkt:** Februar 2026  
**Einstufung:** 🟡 Fehlkonfiguration der Filter

Eine aktualisierte URL-Erkennungsregel stufte legitime Links und Nachrichten fälschlicherweise als Phishing ein. Dadurch wurden geschäftliche E-Mails weltweit in die Quarantäne verschoben.

- Quarantänevolumen und plötzliche Ausschläge überwachen.
- Freigaben von Nachrichten revisionssicher dokumentieren.
- Automatische Klassifizierungen regelmäßig durch Stichproben prüfen.

**Quelle:** [Bericht zur Fehlklassifizierung](https://www.windowscentral.com/software-apps/microsoft-exchange-online-quarantines-legit-emails-as-phishing)

</section><section id="bkmrk-%E2%98%90-20.-unzureichende-" style="margin:30px 0;">### ☐ 20. Unzureichende Transparenz bei Exchange-Online-Ausfällen

**Zeitraum:** fortlaufend  
**Einstufung:** 🟡 Governance- und Cloudrisiko

Detaillierte Ursachen, Incident-IDs und Abschlussberichte sind häufig nur im tenantbezogenen Microsoft-365-Admin-Center sichtbar. Öffentliche Statusseiten bieten oftmals keine dauerhaft verfügbare und vollständige Historie. Das erschwert unabhängige Ursachenanalysen, SLA-Nachweise und langfristige Risikobewertungen.

- Service-Health-Meldungen automatisiert archivieren.
- Incident-ID, Beginn, Ende und geschäftliche Auswirkung dokumentieren.
- Eigene externe Verfügbarkeitsmessungen einsetzen.
- Mögliche SLA-Gutschriften fristgerecht beantragen.

**Weiterführende Informationen:** [Microsoft 365 Service Health](https://admin.microsoft.com/Adminportal/Home#/servicehealth) | [Microsoft Graph Service Communications API](https://learn.microsoft.com/en-us/graph/service-communications-concept-overview)

</section></section><section id="bkmrk-was-zeigen-die-excha" style="background:#f3f5f7;border-left:5px solid #4b8f29;padding:20px;margin:40px 0;">## Was zeigen die Exchange-Sicherheitsvorfälle?

Die Vorfälle belegen nicht, dass grundsätzlich nur eine Betriebsform sicher oder unsicher ist. Vielmehr verschieben sich die Verantwortlichkeiten und Risiken:

- **Exchange On-Premises:** Das größte Risiko ist ein ungepatchter und direkt aus dem Internet erreichbarer Server.
- **Exchange Hybrid:** Eine lokale Kompromittierung kann über Vertrauensstellungen auch die Cloud gefährden.
- **Exchange Online:** Microsoft übernimmt Plattformbetrieb und Updates, nicht jedoch alle Risiken durch Identitäten, OAuth-Apps, Fehlkonfigurationen und kompromittierte Benutzerkonten.
- **Cloudabhängigkeit:** Bei einer zentralen Störung können Kunden die Fehlerbehebung kaum beeinflussen und sind auf Microsofts Kommunikation angewiesen.

</section><section id="bkmrk-kompakte-exchange-si">## Kompakte Exchange-Sicherheitscheckliste

☐ Unterstützte Exchange-Version und aktuelles CU verwenden

☐ Security Updates zeitnah installieren

☐ Exchange Health Checker regelmäßig ausführen

☐ OWA und ECP nicht unnötig direkt veröffentlichen

☐ MFA für Administratoren und Benutzer erzwingen

☐ Alte Konten, Test-Tenants und OAuth-Anwendungen entfernen

☐ ApplicationImpersonation und App-only-Berechtigungen kontrollieren

☐ Extended Protection aktivieren und überprüfen

☐ IIS-, Exchange-, Entra- und Unified-Audit-Logs zentral sichern

☐ Mailfluss und Transportwarteschlangen aktiv überwachen

☐ Notfallkommunikation außerhalb von Microsoft 365 vorhalten

☐ Service-Health-Vorfälle und SLA-relevante Ausfälle archivieren

</section><section id="bkmrk-h%C3%A4ufige-fragen-zu-ex" style="margin-top:40px;">## Häufige Fragen zu Exchange-Sicherheit und Ausfällen

### Ist Exchange Online sicherer als ein eigener Exchange-Server?

Exchange Online reduziert das Risiko ungepatchter Server und nimmt dem Unternehmen einen großen Teil des Plattformbetriebs ab. Dafür entstehen neue Abhängigkeiten von Microsoft, der Cloudidentität und der Verfügbarkeit der Microsoft-365-Infrastruktur. Automatisch sicher ist Exchange Online daher nicht.

### Ist ein aktueller Exchange-Server noch direkt angreifbar?

Jede öffentlich erreichbare Anwendung kann neue Schwachstellen enthalten. Exchange sollte deshalb vollständig aktualisiert, überwacht und möglichst durch zusätzliche Zugriffsschutzmaßnahmen abgesichert werden.

### Reicht es, Exchange-Sicherheitsupdates zu installieren?

Nein. Wurde eine Schwachstelle bereits ausgenutzt, beseitigt das Update möglicherweise die Sicherheitslücke, aber nicht automatisch Webshells, gestohlene Zugangsdaten oder andere Hintertüren. In diesem Fall ist eine forensische Untersuchung erforderlich.

### Kann ein lokaler Exchange die Microsoft-Cloud gefährden?

Ja. Besonders in Hybridumgebungen existieren Vertrauensstellungen zwischen lokalem Exchange, Entra ID und Exchange Online. CVE-2025-53786 zeigte, dass eine lokale Kompromittierung unter bestimmten Voraussetzungen bis in die Cloud reichen kann.

### Was passiert bei einem Exchange-Online-Ausfall?

Kunden können die eigentliche Störung nicht selbst reparieren. Wichtig sind deshalb alternative Kommunikationswege, ein lokaler Outlook-Cache, dokumentierte Notfallverfahren und die Archivierung der Microsoft- Service-Health-Meldungen.

</section><footer style="margin-top:40px;padding-top:20px;border-top:1px solid #cccccc;color:#555555;">**Hinweis:** Die Rangfolge ist eine redaktionelle Bewertung anhand von technischer Schwere, tatsächlicher Ausnutzung, Reichweite und betrieblicher Auswirkung. Die Übersicht ersetzt keine individuelle Sicherheitsanalyse einer Exchange- oder Microsoft-365-Umgebung.

Letzte Aktualisierung: 17. September 2026

</footer></article>

# Proxmox Vergleich der Storage-Varianten vs. ZFS zu Fuß

# Proxmox VE Storage im Vergleich: Ceph, ZFS, SAN/iSCSI und sichere ZFS-Replikation

**Stand: 31. August 2026**

[![pvestorage.jpg](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/pvestorage.jpg)](https://aow.de/uploads/images/gallery/2026-09/pvestorage.jpg)

[Hier der anschliessende YouTube Check zum Artikel](https://www.youtube.com/watch?v=WUbynmf171E "Externer YouTube Link")

Welche Storage-Lösung passt zu Proxmox VE: Ceph RBD, lokales ZFS oder ein SAN mit iSCSI und klassischem LVM? Dieser Praxisvergleich erklärt die wichtigsten Unterschiede bei Hochverfügbarkeit, Snapshots, Live-Migration, Thin Provisioning und Wiederherstellung. Anschließend zeigen wir, wie automatische ZFS-Snapshots, Pull-Replikation mit `zsync`, GUID-Kontrolle mit `checkzfs.py` und der Miyagi-Workflow eine mehrstufige Backup- und Replikationsstrategie bilden.

## Kurzantwort: Ceph, ZFS oder iSCSI?

<div class="seo-article" id="bkmrk-lokales-zfs-eignet-s"><div class="quick-answer">- **Lokales ZFS** eignet sich besonders für einzelne Proxmox-Server und kleinere Cluster. Es bietet Prüfsummen, Snapshots, Clones und eine einfache Replikation zwischen ZFS-Systemen.
- **Ceph RBD** ist für verteilten, hochverfügbaren Shared Storage in größeren Proxmox-Clustern gedacht. Ceph repliziert Daten intern und vermeidet einen einzelnen Storage-Kopf.
- **iSCSI mit LVM thick** ist sinnvoll, wenn bereits ein professionelles SAN vorhanden ist. Der Storage ist gemeinsam nutzbar, die eigentliche Redundanz und Hochverfügbarkeit liefert jedoch das SAN.
- **ZFS per Script** ersetzt die Proxmox-Oberfläche nicht. Es erweitert sie um feinere Snapshot-Aufbewahrung, Pull-Replikation, unabhängige Kontrolle und automatisierte Wiederherstellungswege.

</div><div class="table-of-contents">  
</div></div>## Inhalt

<div class="seo-article" id="bkmrk-ceph%2C-zfs-und-iscsi-"><div class="table-of-contents">1. [Ceph, ZFS und iSCSI im Vergleich](#bkmrk-direktes-iscsi%3A-das--1)
2. [Proxmox-Funktionen und Storage-Abhängigkeiten](#bkmrk-proxmox-funktion-cep-1)
3. [Proxmox GUI versus ZFS-Kommandozeile](#bkmrk--1)
4. [Automatische ZFS-Snapshots](#bkmrk--3)
5. [Snapshots, Rollbacks, Clones und Snapdirs](#bkmrk--5)
6. [Replace und RAIDZ-Expansion](#bkmrk--7)
7. [Spares, L2ARC, SLOG und Special Devices](#bkmrk--9)
8. [ZFS Pull-Replikation mit zsync](#bkmrk--11)
9. [Replikation mit checkzfs.py kontrollieren](#bkmrk--13)
10. [Trojanerresistenter Miyagi-Workflow](#bkmrk--15)
11. [Häufige Fragen](#bkmrk--17)

</div><div>  
</div></div>## Proxmox Storage: Ceph RBD, lokales ZFS und iSCSI/LVM im Vergleich

<div class="seo-article" id="bkmrk-funktion-oder-eigens"><div><div class="table-responsive"><table><thead><tr><th>Funktion oder Eigenschaft</th><th>Ceph RBD</th><th>Lokales ZFS</th><th>iSCSI + LVM thick</th></tr></thead><tbody><tr><td>Gemeinsamer Cluster-Storage</td><td>Ja</td><td>Nein</td><td>Ja</td></tr><tr><td>Verteilte Speicherung</td><td>Ja</td><td>Nein</td><td>Nur wenn das SAN sie bereitstellt</td></tr><tr><td>Kein einzelner Storage-Kopf</td><td>Ja, bei korrektem Clusteraufbau</td><td>Nein</td><td>Abhängig vom SAN</td></tr><tr><td>Thin Provisioning</td><td>Ja</td><td>Optional mit `sparse`</td><td>Nein</td></tr><tr><td>Feste Platzreservierung</td><td>Steuerbar</td><td>Über ZFS-Reservation</td><td>Standard</td></tr><tr><td>Snapshots</td><td>Ja</td><td>Ja</td><td>Für VMs ab Proxmox VE 9 über Volume Chains</td></tr><tr><td>Linked Clones</td><td>Ja</td><td>Ja</td><td>Nein</td></tr><tr><td>Full Clones</td><td>Ja</td><td>Ja</td><td>Ja</td></tr><tr><td>VM- und LXC-Datenträger</td><td>Ja</td><td>Ja</td><td>Ja, über LVM</td></tr><tr><td>Live-Migration ohne Kopieren der VM-Disk</td><td>Ja</td><td>Nein</td><td>Ja</td></tr><tr><td>Migration mit Storage-Kopie</td><td>Ja</td><td>Ja</td><td>Ja</td></tr><tr><td>Storage-Replikation</td><td>Ceph-intern</td><td>Asynchron zwischen ZFS-Systemen</td><td>Üblicherweise SAN-intern</td></tr><tr><td>Selbstheilung</td><td>Verteilt im Ceph-Cluster</td><td>Lokal innerhalb des ZFS-Pools</td><td>Aufgabe des SAN</td></tr><tr><td>Prüfsummen gegen stille Datenfehler</td><td>Ceph-intern</td><td>Nativ durch ZFS</td><td>Abhängig vom SAN</td></tr><tr><td>Typischer Einsatz</td><td>Größerer HA-Cluster</td><td>Einzelserver oder kleiner Cluster</td><td>Vorhandenes zentrales SAN</td></tr></tbody></table>

</div></div></div>Ceph RBD ist ein verteilter Block-Storage mit Thin Provisioning, Redundanz, Snapshots und Clones. Lokales ZFS bietet ebenfalls Snapshots und Clones, ist jedoch kein Shared Storage. Reines iSCSI stellt LUNs bereit, definiert aber keine allgemeine Speicherplatzverwaltung. Deshalb wird häufig eine große gemeinsame iSCSI-LUN mit klassischem LVM kombiniert. Weitere Details enthält die [offizielle Proxmox-VE-Storage-Dokumentation](https://pve.proxmox.com/pve-docs/pve-admin-guide.pdf).

### Direktes iSCSI, iSCSI mit LVM und ZFS over iSCSI

<div class="seo-article" id="bkmrk-direktes-iscsi%3A-das-"><div id="bkmrk-direktes-iscsi%3A-das--1">1. **Direktes iSCSI:** Das SAN stellt fertige LUNs bereit. Der Storage ist shared, bietet über das Proxmox-iSCSI-Backend aber keine nativen Snapshot- oder Clone-Funktionen.
2. **iSCSI + klassisches LVM:** Eine große gemeinsame LUN enthält eine von Proxmox verwaltete Volume Group. Speicher wird thick zugeteilt; Proxmox übernimmt das clusterweite Locking.
3. **ZFS over iSCSI:** ZFS läuft auf einem entfernten Storage-System. Proxmox erzeugt dort per SSH ZVOLs und exportiert sie als iSCSI-LUNs. Ohne redundanten Storage-Kopf kann dieses System zum Single Point of Failure werden.

</div><div>  
</div></div>## Welche Proxmox-Funktionen hängen vom Storage ab?

<div class="seo-article" id="bkmrk-proxmox-funktion-cep"><div id="bkmrk-proxmox-funktion-cep-1"><div class="table-responsive"><table><thead><tr><th>Proxmox-Funktion</th><th>Ceph</th><th>Lokales ZFS</th><th>iSCSI thick</th></tr></thead><tbody><tr><td>KVM-VMs und LXC-Container</td><td>Ja</td><td>Ja</td><td>Ja</td></tr><tr><td>HA-Neustart auf einem anderen Node</td><td>Ja</td><td>Nur mit Replikat oder Storage-Wiederherstellung</td><td>Ja</td></tr><tr><td>Live-Migration</td><td>Ohne Disk-Kopie</td><td>Mit Disk-Kopie</td><td>Ohne Disk-Kopie</td></tr><tr><td>VM-Snapshot inklusive RAM-Zustand</td><td>Ja</td><td>Ja</td><td>Versions- und Konfigurationsabhängig</td></tr><tr><td>Templates und Linked Clones</td><td>Ja</td><td>Ja</td><td>Keine Linked Clones</td></tr><tr><td>Backup mit Proxmox Backup Server</td><td>Ja</td><td>Ja</td><td>Ja</td></tr><tr><td>Online-Vergrößerung einer VM-Disk</td><td>Ja</td><td>Ja</td><td>Ja</td></tr><tr><td>Automatische Replikation</td><td>Ceph-intern</td><td>`pvesr` oder `zfs send/receive`</td><td>SAN-intern</td></tr></tbody></table>

</div></div><div>  
</div></div>## Proxmox GUI versus ZFS-Kommandozeile

Die Proxmox-Oberfläche verwaltet VMs, Container, Cluster-Locks und Storage-Zuordnungen. Die ZFS-Kommandozeile administriert dagegen den darunterliegenden Pool. Beide Ebenen ergänzen sich, dürfen aber nicht miteinander verwechselt werden.

<div class="seo-article" id="bkmrk-aufgabe-proxmox-ve-z"><div><div class="table-responsive"><table><thead><tr><th>Aufgabe</th><th>Proxmox VE</th><th>ZFS-Kommandozeile</th></tr></thead><tbody><tr><td>Pools anzeigen</td><td>Node → Disks → ZFS</td><td>`zpool list`</td></tr><tr><td>Poolzustand prüfen</td><td>ZFS-Übersicht</td><td>`zpool status -v`</td></tr><tr><td>Speicherbelegung anzeigen</td><td>Storage Summary</td><td>`zfs list -o space`</td></tr><tr><td>I/O beobachten</td><td>PVE-Metriken</td><td>`zpool iostat -v 2`</td></tr><tr><td>Dataset anlegen</td><td>Storage-Konfiguration</td><td>`zfs create tank/vmdata`</td></tr><tr><td>ZVOL anlegen</td><td>VM-Disk hinzufügen</td><td>`zfs create -V 100G tank/vmdata/test`</td></tr><tr><td>Kompression aktivieren</td><td>Meist CLI</td><td>`zfs set compression=lz4 tank/vmdata`</td></tr><tr><td>VM-Snapshot erstellen</td><td>`qm snapshot 100 snap1`</td><td>`zfs snapshot tank/vmdata/vm-100-disk-0@snap1`</td></tr><tr><td>Snapshot zurückrollen</td><td>PVE-Snapshot-Menü</td><td>`zfs rollback …@snap1`</td></tr><tr><td>Clone erzeugen</td><td>`qm clone 100 200`</td><td>`zfs clone …@snap1 …`</td></tr><tr><td>VM-Disk vergrößern</td><td>`qm resize 100 scsi0 +20G`</td><td>`zfs set volsize=120G …`</td></tr><tr><td>Replikation</td><td>PVE Replication Job</td><td>`zfs send … | ssh … zfs receive …`</td></tr><tr><td>Datenintegrität prüfen</td><td>Tasks und Status</td><td>`zpool scrub tank`</td></tr><tr><td>Defekte Platte ersetzen</td><td>Disks/ZFS beziehungsweise CLI</td><td>`zpool replace tank alt neu`</td></tr><tr><td>TRIM starten</td><td>Zeitplan oder CLI</td><td>`zpool trim tank`</td></tr></tbody></table>

</div></div></div>### Praxisregel für Proxmox-VMs auf ZFS

Proxmox-eigene VM-Datenträger sollten nicht unkontrolliert direkt mit `zfs snapshot`, `zfs clone`, `zfs rollback`, `zfs rename` oder `zfs destroy` verändert werden. Proxmox kennt diese Änderungen sonst nicht. Für VM-Operationen sind deshalb Weboberfläche, API, `qm`, `pct` und `pvesm` die erste Wahl. Die ZFS-CLI eignet sich besonders für Poolzustand, Scrubs, Plattentausch, Kompression, Kapazitätsanalyse und geplante externe Replikation.

<div class="seo-article" id="bkmrk--1"><div id="bkmrk--2"></div><div>  
</div></div>## Automatische ZFS-Snapshots für Proxmox einrichten

Für die relevanten ZFS-Datasets und ZVOLs verwenden wir eine gestaffelte Snapshot-Aufbewahrung. Sie bietet engmaschige Wiederherstellungspunkte für aktuelle Fehler und ein gröberes Raster für ältere Stände.

<div class="seo-article" id="bkmrk-intervall-aufbewahru"><div><table><thead><tr><th>Intervall</th><th>Aufbewahrung</th><th>Maximale Anzahl</th><th>Zweck</th></tr></thead><tbody><tr><td>Alle 15 Minuten</td><td>3 Stunden</td><td>12</td><td>Schnelle Hilfe bei aktuellen Fehlern</td></tr><tr><td>Stündlich</td><td>96 Stunden</td><td>96</td><td>Vier Tage inklusive langer Wochenenden</td></tr><tr><td>Täglich</td><td>14 Tage</td><td>14</td><td>Zwei Wochen Tageshistorie</td></tr><tr><td>Wöchentlich</td><td>6 Wochen</td><td>6</td><td>Mittelfristige Wiederherstellung</td></tr><tr><td>Monatlich</td><td>3 Monate</td><td>3</td><td>Spät erkannte Fehler</td></tr></tbody></table>

</div></div>Das ergibt maximal ungefähr **131 automatische Snapshots pro Dataset oder ZVOL**. Durch zeitliche Überschneidungen und das Verhalten der verwendeten Snapshot-Engine kann die tatsächliche Zahl abweichen.

### Wie viel Speicher benötigen ZFS-Snapshots?

Ein ZFS-Snapshot ist keine vollständige Kopie. Beim Erstellen wird lediglich ein neuer Referenzpunkt im Blockbaum angelegt. Zusätzlicher Platz wird benötigt, sobald Daten im Live-Dataset überschrieben oder gelöscht werden und der Snapshot die alten Blöcke weiterhin referenziert. Der Speicherbedarf hängt deshalb von der Änderungsrate ab, nicht allein von der Anzahl der Snapshots.

```bash
zfs list -o name,used,available,usedbysnapshots
zfs list -t snapshot -o name,creation,used
zpool list
```

Snapshots auf demselben Pool sind kein vollständiges Backup. Fällt der gesamte Pool aus oder wird er zerstört, sind auch seine Snapshots verloren. Für längere Aufbewahrung und getrennte Kopien verwenden wir ZFS-Replikation und Proxmox Backup Server.

<div class="seo-article" id="bkmrk--3"><div id="bkmrk--4"></div><div>  
</div></div>## ZFS-Snapshots, Rollbacks, Clones und Snapdirs erklärt

### ZFS-Snapshot erstellen

```bash
zfs snapshot rpool/data@vor-update
zfs snapshot -r rpool/data@vor-update
```

Snapshots entstehen nahezu sofort. Ein nativer Snapshot außerhalb von Proxmox ist jedoch zunächst nur crash-konsistent. Für Datenbanken oder VMs mit mehreren Disks können QEMU Guest Agent, Freeze/Thaw oder eine anwendungsspezifische Vorbereitung erforderlich sein.

### Einzelne Dateien aus einem Snapshot wiederherstellen

```bash
cp /daten/.zfs/snapshot/daily-2026-08-31/datei /daten/datei
```

Eine einzelne Datei zu kopieren ist meist sicherer als ein Rollback des gesamten Datasets, weil alle anderen aktuellen Änderungen erhalten bleiben.

### Snapdir sichtbar machen

```bash
zfs set snapdir=visible pool/daten
```

<div class="seo-article" id="bkmrk-hidden%3A-.zfs%2Fsnapsho"><div>- `hidden`: `.zfs/snapshot` ist vorhanden, erscheint aber nicht im normalen Verzeichnislisting.
- `visible`: Benutzer können den Snapshot-Pfad sehen und ältere Dateien lesen.
- `disabled`: Zugriff über das Snapshot-Verzeichnis ist deaktiviert.

</div></div>`snapdir` gilt für ZFS-Dateisysteme. Proxmox-VM-Disks sind üblicherweise ZVOLs und besitzen kein durchsuchbares Dateiverzeichnis. Für ZVOL-Snapshot-Geräte existiert stattdessen `snapdev`. Siehe [OpenZFS-Dokumentation zu Snapshots, Clones und Snapdir](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Datasets/Snapshots%20and%20Clones.html).

### ZFS-Rollback

```bash
zfs rollback pool/daten@vor-update
```

Ein Rollback verwirft alle Änderungen nach dem gewählten Snapshot. Standardmäßig ist nur der neueste Snapshot zulässig. `zfs rollback -r` kann neuere Snapshots löschen; `-R` kann zusätzlich abhängige Clones betreffen. Vor einem Rollback sollte der aktuelle Zustand deshalb separat gesichert werden.

### ZFS-Clone

```bash
zfs clone pool/daten@vor-update pool/test
```

Ein Clone ist eine sofort beschreibbare Kopie eines Snapshots. Anfangs teilen sich Snapshot und Clone die unveränderten Blöcke. Neue Schreibvorgänge benötigen zusätzlichen Platz. Typische Anwendungen sind Tests, Updates, Datenrettung und isolierte Kopien. Der Clone bleibt von seinem Ursprungssnapshot abhängig, bis die Beziehung gegebenenfalls mit `zfs promote` umgekehrt wird.

<div class="seo-article" id="bkmrk--5"><div id="bkmrk--6"></div><div>  
</div></div>## ZFS-Platte schnell ersetzen und RAIDZ erweitern

### Defekte ZFS-Platte mit Replace austauschen

```bash
zpool replace tank alte-platte neue-platte
zpool status tank
```

ZFS rekonstruiert die benötigten Blöcke aus den verbliebenen Geräten und schreibt sie auf die neue Platte. Ist die alte Platte noch lesbar, sollte die neue möglichst zuerst angeschlossen und der Replace kontrolliert gestartet werden. So bleibt die vorhandene Redundanz länger erhalten. Bei Mirrors kann `zpool replace -s` eine sequenzielle Rekonstruktion starten; für RAIDZ ist diese Option nicht verfügbar. Details stehen in der [OpenZFS-Referenz zu zpool replace](https://openzfs.github.io/openzfs-docs/man/master/8/zpool-replace.8.html).

### RAIDZ-Expansion: RAIDZ um eine Platte erweitern

```bash
zpool attach tank raidz2-0 neue-platte
```

Mit aktuellen OpenZFS-Versionen kann ein bestehendes RAIDZ-vdev schrittweise um einzelne Platten verbreitert werden. Die Feature-Flag `raidz_expansion` muss vorhanden und aktiviert sein. Die neue Platte muss mindestens so groß wie die kleinste vorhandene Platte sein.

<div class="seo-article" id="bkmrk-raidz1%2C-raidz2-oder-"><div>- RAIDZ1, RAIDZ2 oder RAIDZ3 behalten ihr jeweiliges Paritätsniveau.
- Die Anzahl tolerierbarer Plattenausfälle steigt durch die Expansion nicht.
- ZFS liest die belegten Daten und verteilt sie über die verbreiterte Gruppe.
- `zpool status` zeigt den Fortschritt.
- Bei einem Plattenfehler pausiert die Expansion, bis das vdev wieder gesund ist.
- Alte Blöcke behalten ihr ursprüngliches Daten-Paritäts-Verhältnis; neue Blöcke nutzen die breitere Geometrie vollständig.

</div></div>Weitere technische Hintergründe bietet die [OpenZFS-Dokumentation zur Änderung des Pool-Layouts](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Pool%20Structure/Changing%20Pool%20Layout.html).

<div class="seo-article" id="bkmrk--7"><div id="bkmrk--8"></div><div>  
</div></div>## ZFS Spares, L2ARC, SLOG und Special Devices richtig einsetzen

<div class="seo-article" id="bkmrk-ger%C3%A4tetyp-aufgabe-wa"><div><table><thead><tr><th>Gerätetyp</th><th>Aufgabe</th><th>Was passiert bei Verlust?</th></tr></thead><tbody><tr><td>Hot Spare</td><td>Ersatzplatte bereithalten</td><td>Die normale Pool-Redundanz entscheidet</td></tr><tr><td>Cache/L2ARC</td><td>Häufig gelesene Daten zusätzlich cachen</td><td>Unkritisch, da nur Kopien gespeichert werden</td></tr><tr><td>Log/SLOG</td><td>Synchrone Schreibvorgänge beschleunigen</td><td>Risiko für die jüngsten noch nicht übernommenen Sync-Schreibvorgänge</td></tr><tr><td>Special vdev</td><td>Metadaten und optional kleine Blöcke dauerhaft speichern</td><td>Der Verlust kann den gesamten Pool zerstören</td></tr></tbody></table>

</div></div>### Hot Spare

```bash
zpool add tank spare /dev/disk/by-id/...
```

Ein Hot Spare verkürzt die Zeit im degradierten Zustand, erhöht aber nicht die Fehlertoleranz. Ein RAIDZ2 bleibt trotz Spare ein RAIDZ2. Die ausgefallene Platte muss dauerhaft ersetzt werden.

### L2ARC als ZFS-Lesecache

```bash
zpool add tank cache /dev/nvme0n1
```

Der primäre ZFS-Cache ist der ARC im RAM. L2ARC auf SSD oder NVMe ist nur die zweite Stufe. Er lohnt sich vor allem bei wiederkehrenden zufälligen Lesezugriffen und einem Arbeitsdatensatz, der nicht vollständig in den RAM passt. L2ARC beschleunigt keine Schreibvorgänge; mehr RAM ist häufig die bessere erste Maßnahme.

### SLOG für synchrone Schreibvorgänge

```bash
zpool add tank log mirror /dev/nvme0n1 /dev/nvme1n1
```

Ein SLOG ist kein allgemeiner Schreibcache. Es beschleunigt nur synchrone Schreibvorgänge, etwa bei NFS, Datenbanken oder VM-Storage mit häufigem `fsync()`. Geeignete Geräte benötigen geringe Latenz und Power-Loss-Protection. Wichtige SLOGs sollten gespiegelt werden. `sync=disabled` ist kein pauschaler Tuningtrick, weil dabei zugesagte Schreibsicherheit verloren geht.

### Special vdev für Metadaten und kleine Blöcke

```bash
zpool add tank special mirror /dev/nvme0n1 /dev/nvme1n1
zfs set special_small_blocks=32K tank/daten
```

Ein Special vdev speichert Metadaten, indirekte Blöcke, gegebenenfalls Dedup-Tabellen und optional kleine Datenblöcke dauerhaft. Es ist kein Cache. Deshalb muss es mindestens so redundant wie der normale Pool aufgebaut werden. Geht das vollständige Special vdev verloren, kann der gesamte Pool verloren sein. Siehe [OpenZFS-Dokumentation zu Special vdevs](https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Pool%20Structure/Special%20vdev.html).

<div class="seo-article" id="bkmrk--9"><div id="bkmrk--10"></div><div>  
</div></div>## ZFS Pull-Replikation mit bashclub zsync

`zsync` läuft auf dem Zielserver und holt markierte ZFS-Dateisysteme und ZVOLs über SSH von der Quelle. Das Ziel initiiert also die Replikation:

```text
ZFS-Quelle ── SSH und zfs send ──▶ ZFS-Ziel
                    ▲
                    │
             Ziel startet Pull
```

Dieses Pull-Modell reduziert die Rechte der Quelle auf dem Sicherungsziel. Ein kompromittierter Proxmox-Server soll weder ältere Replikate löschen noch die Retention auf dem Ziel verändern können.

### Datasets mit dem ZFS-Attribut bashclub:zsync markieren

```bash
zfs set bashclub:zsync=all rpool/data
```

<div class="seo-article" id="bkmrk-all%3A-dataset-und-unt"><div>- `all`: Dataset und untergeordnete Datasets beziehungsweise ZVOLs einbeziehen
- `subvols`: nur untergeordnete Datasets und ZVOLs einbeziehen
- `exclude`: den markierten Zweig ausschließen

</div></div>Der Attributname kann geändert werden. Dadurch lassen sich verschiedene Replikationsziele mit unterschiedlichen Tags steuern.

### Ablauf der zsync-Replikation

<div class="seo-article" id="bkmrk-zsync-startet-auf-de"><div>1. `zsync` startet auf dem Zielserver.
2. Das Ziel verbindet sich per SSH mit der ZFS-Quelle.
3. Die ZFS-Attribute bestimmen die zu replizierenden Datasets und ZVOLs.
4. Optional wird vor der Replikation ein Snapshot erzeugt.
5. Quelle und Ziel suchen den neuesten gemeinsamen Snapshot.
6. Der erste Lauf sendet einen vollständigen Stream; Folgeläufe übertragen nur geänderte Blöcke.
7. Das Ziel erzeugt den vollständigen Dataset-Pfad automatisch.
8. `com.sun:auto-snapshot=false` verhindert ungewollte lokale Auto-Snapshots auf dem Replikationsziel.
9. Der Mountpoint wird übernommen und `canmount=noauto` verhindert ein unbeabsichtigtes Mounten.
10. `snapshot_filter` bestimmt, welche vorhandenen Snapshots mitgenommen werden.
11. Raw Replication kann verschlüsselte Blöcke ohne Entschlüsselung auf dem Ziel übertragen.

</div></div>```text
source=root@pve01
target=backup/repl/pve01
tag=bashclub:zsync
snapshot_filter=hourly|daily|weekly|monthly
min_keep=3
zfs_auto_snapshot_keep=14
zfs_auto_snapshot_label=zsync
```

Installation, Tags und Snapshot-Filter beschreibt die [deutsche bashclub-zsync-Dokumentation](https://github.com/bashclub/zsync/blob/main/DOCUMENTATION_DE.md). Das frühere GitHub-Repository verweist inzwischen auf das GitLab-Projekt.

<div class="seo-article" id="bkmrk--11"><div id="bkmrk--12"></div><div>  
</div></div>## ZFS-Replikation per Snapshot-GUID mit checkzfs.py überwachen

Eine erfolgreiche Script-Ausgabe beweist noch nicht, dass ein aktuelles und brauchbares Replikat existiert. `checkzfs.py` vergleicht deshalb die Snapshots auf Quelle und Ziel anhand ihrer ZFS-GUID. Gleiche Snapshot-Namen reichen als Nachweis nicht aus.

Die Prüfung kann unter anderem folgende Fehler erkennen:

<div class="seo-article" id="bkmrk-kein-replikat-gefund"><div>- kein Replikat gefunden,
- letzter gemeinsamer Snapshot zu alt,
- Snapshot auf dem Ziel nicht vorhanden,
- Rollback auf einen älteren Snapshot,
- zu viele Snapshots,
- unerwünschte Auto-Snapshots auf dem Replikationsziel,
- SSH- oder Abfragefehler.

</div></div>### Wunschalter der Replikation festlegen

```text
threshold: 1500,2000
```

Im Beispiel wird nach 1.500 Minuten gewarnt und nach 2.000 Minuten ein kritischer Zustand gemeldet. Zusätzlich lassen sich maximale Snapshotzahlen, Dataset-Filter, Snapshot-Filter, SSH-Key und Servicename definieren.

```text
source: pve01
remote: backup01
filter: rpool/data
replicafilter: backup/repl/pve01
snapshotfilter: zsync|daily|weekly|monthly
threshold: 1500,2000
maxsnapshots: 140,160
prefix: REPLICA
```

Die Ausgabe eignet sich unter anderem für Tabellen, JSON, CSV, E-Mail und lokale Checkmk-Checks. Der [Quellcode von checkzfs.py](https://raw.githubusercontent.com/bashclub/check-zfs-replication/refs/heads/main/checkzfs.py) zeigt die verfügbaren Parameter und Prüfungen.

**Wichtig:** Ein GUID-Vergleich bestätigt die gemeinsame Snapshot-Identität. Er ersetzt weder den regelmäßigen ZFS-Scrub noch einen getesteten Restore.

<div class="seo-article" id="bkmrk--13"><div id="bkmrk--14"></div><div>  
</div></div>## Trojanerresistentes Proxmox-Backup mit dem Miyagi-Workflow

Der Miyagi-Workflow verbindet zwei unterschiedliche Sicherungsmethoden auf einem getrennten System:

<div class="seo-article" id="bkmrk-proxmox-backup-serve"><div>- **Proxmox Backup Server:** deduplizierte und längerfristige VM- und LXC-Backups
- **Native ZFS-Replikation:** unmittelbar vorhandene Datasets und ZVOLs für einen schnellen Wiederanlauf

</div></div>Das Ziel sind mindestens drei Datenkopien, zwei Standorte, zwei Sicherungsmethoden, automatische Kontrolle und eine möglichst kurze Netzwerk-Erreichbarkeit des Sicherungsservers.

### Typischer Ablauf des Miyagi-Servers

```text
Miyagi-Server startet
        │
        ├─ Updates und Zustandsprüfung
        ├─ ZFS-Replikation per Pull
        ├─ PBS-Backup koordinieren
        ├─ Verify, Wartung und Monitoring
        ├─ GUID und Alter der Replikate prüfen
        └─ Sicherungsserver herunterfahren
```

Das ZFS-Replikat kann einen schnellen Wiederanlauf ermöglichen, weil Datasets und ZVOLs bereits auf dem Ziel liegen. Das PBS-Backup bietet die längere, deduplizierte Historie, benötigt für die produktive Nutzung aber einen Restore.

### Wann ist der Workflow gegen Ransomware und Trojaner widerstandsfähig?

„Trojanersicher“ ist keine einzelne Produkteigenschaft. Die Schutzwirkung entsteht durch technische Trennung und minimale Berechtigungen:

<div class="seo-article" id="bkmrk-das-ziel-startet-die"><div>- Das Ziel startet die Pull-Replikation.
- Die Quelle besitzt keine administrativen Schreib- oder Löschrechte auf dem Ziel.
- SSH-Zugriffe werden auf notwendige Befehle und Datasets begrenzt.
- Der PBS-API-Key erhält nur die erforderlichen Backup- und Restore-Rechte.
- SSH-Passwortlogin wird deaktiviert und interaktive Konten werden mit 2FA geschützt.
- Snapshot-Löschung und Retention werden ausschließlich vom Ziel kontrolliert.
- Der Miyagi-Server hat häufig nur definierte Routen und kein Default Gateway.
- Außerhalb des Sicherungsfensters ist der Server ausgeschaltet oder wirksam isoliert.
- Scrubs, Verify-Jobs und Wiederherstellungstests werden regelmäßig durchgeführt.
- Mindestens eine Kopie befindet sich an einem anderen Standort.

</div></div>Der dokumentierte Workflow kombiniert Backups, startfähige ZFS-Replikate, Monitoring, Wartung und automatisches Herunterfahren. Die vollständige Einrichtung beschreibt die Anleitung [Backup und Replikation für Proxmox VE mit dem Miyagi-Workflow](https://aow.de/books/dokumentation/page/backup-und-replikation-trojanersicher-fur-proxmox-ve-mit-miyagi-workflow).

<div class="seo-article" id="bkmrk--15"><div id="bkmrk--16"></div><div>  
</div></div>## Welche Proxmox-Storage-Lösung ist die richtige?

<div class="seo-article" id="bkmrk-ein-bis-zwei-nodes%3A-"><div id="bkmrk-ein-bis-zwei-nodes%3A--1">- **Ein bis zwei Nodes:** Lokales ZFS ist meist die einfachste und robusteste Lösung.
- **Drei oder mehr geeignete Nodes mit echtem Storage-HA:** Ceph RBD ist der typische Ansatz.
- **Vorhandenes professionelles SAN:** iSCSI mit klassischem LVM nutzt die bestehende zentrale Infrastruktur.
- **Thin Provisioning und schnelle Linked Clones:** Ceph oder ZFS.
- **Vorhersehbare feste Platzbelegung:** iSCSI mit LVM thick.
- **Schneller lokaler Restore plus getrennte Kopie:** ZFS-Snapshots mit Pull-Replikation und PBS kombinieren.

</div><div>  
</div></div>## Häufige Fragen zu Proxmox, ZFS, Ceph und Replikation

### Ist ein ZFS-Snapshot bereits ein Backup?

Nein. Ein Snapshot liegt normalerweise auf demselben ZFS-Pool wie die produktiven Daten. Er schützt gut vor versehentlichem Löschen oder unerwünschten Änderungen, aber nicht vor dem vollständigen Verlust oder der Zerstörung des Pools.

### Was ist für Proxmox besser: Ceph oder ZFS?

Für einzelne Server und kleine Cluster ist lokales ZFS meist einfacher. Ceph eignet sich für mehrere Nodes, verteilten Shared Storage und hohe Verfügbarkeit ohne einzelnen Storage-Kopf. Ceph benötigt dafür mehr Hardware, Netzwerkleistung und Betriebsaufwand.

### Kann Proxmox mit lokalem ZFS live migrieren?

Ja, eine laufende VM kann migriert werden. Da lokales ZFS kein Shared Storage ist, muss der VM-Datenträger dabei jedoch auf den Ziel-Node kopiert werden. Bei Ceph oder gemeinsamem iSCSI-Storage entfällt diese Storage-Kopie in der Regel.

### Was ist der Unterschied zwischen ZFS-Replikation und Proxmox Backup Server?

ZFS-Replikation überträgt native Datasets, ZVOLs und Snapshots und ermöglicht dadurch einen schnellen Wiederanlauf. Proxmox Backup Server erstellt deduplizierte Backups mit längerer Historie und integriertem Restore für VMs und Container. Beide Verfahren ergänzen sich.

### Warum ist Pull-Replikation sicherer als Push-Replikation?

Bei Pull-Replikation startet das Ziel die Verbindung und holt Daten von der Quelle. Die Quelle benötigt dadurch keine administrativen Rechte auf dem Sicherungsziel. Wird sie kompromittiert, kann sie ältere Ziel-Snapshots nicht ohne Weiteres löschen.

### Wozu vergleicht checkzfs.py Snapshot-GUIDs?

Ein Snapshot-Name kann auf zwei Systemen identisch sein, ohne denselben Snapshot zu bezeichnen. Die GUID ermöglicht eine eindeutige Zuordnung und zeigt, ob Quelle und Ziel tatsächlich einen gemeinsamen replizierten Snapshot besitzen.

### Beschleunigt ein ZFS-SLOG alle Schreibvorgänge?

Nein. Ein SLOG hilft nur bei synchronen Schreibvorgängen. Asynchrone Writes werden dadurch nicht grundsätzlich schneller. Ein geeignetes SLOG benötigt geringe Latenz und Power-Loss-Protection.

### Kann der Verlust eines Special vdev den ZFS-Pool zerstören?

Ja. Ein Special vdev speichert bestimmte Blöcke dauerhaft und nicht nur als Cache. Es muss deshalb mindestens so redundant wie die normalen Daten-vdevs aufgebaut werden.

<div class="seo-article" id="bkmrk--17"><div id="bkmrk--18"></div><div>  
</div></div>## Fazit: Proxmox-Storage mit überprüfbarer Backup-Strategie

Ceph, lokales ZFS und iSCSI erfüllen unterschiedliche Aufgaben. Entscheidend ist nicht nur die Storage-Technik, sondern der vollständige Wiederherstellungsweg. Automatische ZFS-Snapshots liefern schnelle lokale Zeitpunkte, `zsync` erzeugt getrennte native Replikate, `checkzfs.py` kontrolliert deren Aktualität und der Miyagi-Workflow kombiniert ZFS-Replikation mit Proxmox Backup Server, Monitoring und zeitweiser Offline-Sicherung.

So entsteht aus einzelnen Storage-Funktionen eine mehrstufige Strategie gegen Hardwareausfälle, Fehlbedienung, spät erkannte Datenfehler und kompromittierte Produktivsysteme.

<div class="seo-article" id="bkmrk--19"><div id="bkmrk--20"></div></div>

# Proxmox 9 und iSCSI SAN mit Multipath

<article id="bkmrk-truenas-als-proxmox-"><header># TrueNAS als Proxmox-Speicher: iSCSI mit Multipath und LVM einrichten

##### **Video zum Artikel:** Die Einrichtung wird im

##### [![pvesan.jpg](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/pvesan.jpg)](https://aow.de/uploads/images/gallery/2026-09/pvesan.jpg)

#####  [begleitenden Livestream zu Proxmox, TrueNAS und iSCSI-Multipath](https://youtube.com/live/ipIIBZHonSs) gezeigt.

##### Diese Dokumentation zeigt die Einrichtung eines gemeinsamen **iSCSI-Speichers für einen Proxmox-Cluster mit TrueNAS**. Zwei getrennte SAN-Netze stellen die Speicherverbindungen bereit. Multipath bündelt die Zugriffswege auf dieselbe LUN, während Proxmox die VM-Datenträger über LVM verwaltet.

##### Dokumentiert wurde ein Workshop mit drei Proxmox-Knoten. Die Anleitung enthält die sichtbaren Einrichtungsschritte, passende Screenshots und eine Einordnung der aufgetretenen Probleme. Am Ende folgen konkrete Optimierungstipps.

##### **Stand:** <time datetime="2026-09-07">7. September 2026</time> · **Umgebung:** Proxmox VE 9.2.11 und TrueNAS Community Edition

##### **Ergebnis:** Die iSCSI-Anbindung und zwei verfügbare Multipath-Pfade je Host sind dokumentiert. Das Verschieben einer VM-Festplatte auf TrueNAS war erfolgreich. Bei der Einrichtung wurde zunächst der Haken bei „Shared“ vergessen. Die fehlgeschlagene Migration lag an einem noch eingerichteten ZFS-Replikationsjob. Nach Aktivierung von Shared, Entfernung der bisherigen ZFS-Replikationsjobs und Übernahme aller VM-Disks einschließlich EFI und gegebenenfalls TPM liefen alle Migrationen tadellos. Dieses abschließende Ergebnis ergänzt die Screenshots durch die nachträgliche Bestätigung aus dem Workshop. Ein Ausfalltest ist weiterhin nicht dokumentiert.

</header><nav>## Inhalt

1. [Netzwerk und IP-Adressen](#bkmrk-1.-netzwerk-und-ip-a)
2. [TrueNAS-Pool und iSCSI-LUN erstellen](#bkmrk-2.-truenas-pool-und-)
3. [iSCSI-Portale und Initiatoren konfigurieren](#bkmrk-3.-iscsi-portale-und)
4. [iSCSI in Proxmox einbinden](#bkmrk-4.-truenas-iscsi-spe)
5. [Multipath einrichten und prüfen](#bkmrk-5.-iscsi-multipath-a)
6. [Gemeinsamen LVM-Speicher hinzufügen](#bkmrk-6.-gemeinsamen-lvm-s)
7. [VM-Festplatte verschieben und Migration prüfen](#bkmrk-7.-vm-festplatte-auf)
8. [Prüfliste für die Abnahme](#bkmrk-8.-pr%C3%BCfliste-f%C3%BCr-die)
9. [Optimierungstipps für den Betrieb](#bkmrk-9.-optimierungstipps)

</nav><section id="bkmrk-1.-netzwerk-und-ip-a">## 1. Netzwerk und IP-Adressen für Proxmox und TrueNAS

Das Managementnetz und die beiden Speichernetze sind getrennt. SAN1 verwendet das Netz `172.16.1.0/24`, SAN2 das Netz `172.16.2.0/24`. Die Managementadressen liegen im Netz `192.168.168.0/24`.

<table><caption>Adressübersicht des Workshop-Clusters</caption><thead><tr><th scope="col">System</th><th scope="col">Management</th><th scope="col">SAN1</th><th scope="col">SAN2</th></tr></thead><tbody><tr><th scope="row">pve1</th><td>192.168.168.21</td><td>172.16.1.21</td><td>172.16.2.21</td></tr><tr><th scope="row">pve2</th><td>192.168.168.22</td><td>172.16.1.22</td><td>172.16.2.22</td></tr><tr><th scope="row">pve3</th><td>192.168.168.23</td><td>172.16.1.23</td><td>172.16.2.23</td></tr><tr><th scope="row">TrueNAS</th><td>192.168.168.67</td><td>172.16.1.67</td><td>172.16.2.67</td></tr></tbody></table>

Auf TrueNAS übernimmt `enp2s0f0` das Management, `ens1f0np0` SAN1 und `enp2s0f1` SAN2. Die SAN-Adressen von pve2 und pve3 werden durch die später sichtbaren iSCSI-Verbindungen bestätigt; ihre vollständigen finalen Schnittstellendateien sind nicht abgebildet.

<figure>[![TrueNAS-Netzwerkkonfiguration: SAN2 mit statischer IP-Adresse 172.16.2.67/24](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-10-25.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-10-25.png)

<figcaption>TrueNAS: Die zweite SAN-Schnittstelle erhält eine statische Adresse im separaten Speichernetz.</figcaption></figure>### SAN-Schnittstellen auf Proxmox konfigurieren

Die spätere Konfiguration von pve1 verwendet `nic1` für SAN1 und `nic2` für SAN2. Das Standardgateway `192.168.168.1` bleibt am Managementnetz über `vmbr0`. Für die SAN-Schnittstellen ist kein Gateway eingetragen.

```
auto nic1
iface nic1 inet static
    address 172.16.1.21/24

auto nic2
iface nic2 inet static
    address 172.16.2.21/24
```

<figure>[![Proxmox pve1: Netzwerkkonfiguration mit nic1 für SAN1 und nic2 für SAN2](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-23-08.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-23-08.png)

<figcaption>Die spätere Konfiguration zeigt beide SAN-Netze zusätzlich zur Management-Bridge.</figcaption></figure>Ein früher Ping scheitert mit „Destination Host Unreachable“. Nach den Anpassungen sind erfolgreiche Antworten von beiden TrueNAS-SAN-Adressen auf pve1 und pve2 sichtbar. Auch pve3 erreicht dokumentierte SAN-Ziele. Diese kurzen Tests bestätigen die Erreichbarkeit, aber noch keine Leistung oder Stabilität unter Last.

</section><section id="bkmrk-2.-truenas-pool-und-">## 2. TrueNAS-Pool und iSCSI-LUN erstellen

### ZFS-Mirror aus zwei SSDs anlegen

Unter **Storage → Create Pool** wird der Pool `Mirror` erstellt. Er besteht aus einem Mirror-VDEV mit zwei als SSD erkannten Laufwerken von jeweils 931,51 GiB. Eine Verschlüsselung ist in der gezeigten Konfiguration nicht aktiviert.

Die Poolerstellung löscht die ausgewählten Datenträger. Vor einer Wiederholung müssen deshalb Laufwerksauswahl und vorhandene Daten geprüft werden.

<figure>[![TrueNAS-Pool erstellen: Mirror-VDEV aus zwei SSDs mit jeweils 931,51 GiB](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-25-10.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-25-10.png)

<figcaption>Poolplanung: ein Mirror-VDEV mit zwei SSDs.</figcaption></figure>Nach der Erstellung zeigt TrueNAS etwa 899,25 GiB nutzbare Kapazität und den Zustand „Online, no errors“. Ein Scrub ist sonntags um 00:00 Uhr geplant. Auto TRIM ist ausgeschaltet; Temperaturdaten sind nicht verfügbar.

### Dataset und Zvol mit 512 GiB erstellen

Unter **Shares → Block (iSCSI) Shares Targets → Wizard** wird ein neues Target vorbereitet. Im Pool entsteht das Dataset `Mirror/iscsi`. Der Assistent erstellt darin ein neues Blockgerät mit 512 GiB.

<figure>[![TrueNAS-iSCSI-Assistent: 512-GiB-Blockgerät im Dataset Mirror/iscsi mit Profil Modern OS](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-27-16.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-27-16.png)

<figcaption>Für die LUN sind 512 GiB und zuletzt das Plattformprofil „Modern OS“ ausgewählt.</figcaption></figure>Das Profil zeigt eine Extent-Blockgröße von 4 KiB. Diese Angabe ist nicht mit der ZFS-Eigenschaft `volblocksize` gleichzusetzen. Der später sichtbare Gerätepfad lautet `zvol/Mirror/iscsi/iscsi`.

</section><section id="bkmrk-3.-iscsi-portale-und">## 3. iSCSI-Portale und Initiatoren konfigurieren

Das TrueNAS-Target wird über `172.16.1.67` und `172.16.2.67` erreichbar gemacht. Beide Portal-Adressen führen zur selben LUN. Mehrere Portal-Adressen bilden die Grundlage für die späteren Multipath-Verbindungen.

Die eindeutigen Initiator-Namen der Proxmox-Knoten lassen sich auf jedem Host auslesen:

```
cat /etc/iscsi/initiatorname.iscsi
```

Im Workshop werden alle drei Initiatoren im TrueNAS-Assistenten hinterlegt. Danach wird der iSCSI-Dienst gestartet; die Option für den automatischen Start ist ausgewählt.

<figure>[![TrueNAS-iSCSI-Konfiguration mit zwei Portal-Adressen und drei Proxmox-Initiatoren](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-29-18.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-29-18.png)

<figcaption>Zwei SAN-Portale und die Initiatoren der drei Proxmox-Knoten werden dem Target zugeordnet.</figcaption></figure>Die spätere Übersicht zeigt das Target `iscsi` mit LUN-ID `0`, Authentifizierung `NONE` und sechs Verbindungen: jeweils eine Verbindung pro Host und SAN-Netz. Es sind keine zusätzlichen „Authorized Networks“ eingetragen; die Initiatorliste ist davon getrennt zu betrachten.

<figure>[![TrueNAS-Target iscsi mit LUN 0 und sechs Verbindungen aus beiden SAN-Netzen](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-38-22.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-38-22.png)

<figcaption>Die Target-Übersicht bestätigt zwei Verbindungen je Proxmox-Knoten.</figcaption></figure></section><section id="bkmrk-4.-truenas-iscsi-spe">## 4. TrueNAS-iSCSI-Speicher in Proxmox einbinden

Unter **Datacenter → Storage → Add → iSCSI** wird die Verbindung hinzugefügt:

- **ID:** `iscsi-portal`
- **Portal:** `172.16.1.67`
- **Target:** `iqn.2005-10.org.freenas.ctl:iscsi`
- **Nodes:** alle Knoten
- **Enable:** aktiviert
- **Use LUNs directly:** deaktiviert

<figure>[![Proxmox: iSCSI-Speicher iscsi-portal über das TrueNAS-Portal 172.16.1.67 hinzufügen](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-30-25.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-30-25.png)

<figcaption>Die iSCSI-Verbindung wird als Grundlage für den späteren LVM-Speicher eingerichtet.</figcaption></figure>Nach der Einrichtung ist `iscsi-portal` aktiv. Der Inhaltstyp `none` passt zur Nutzung als Basis für LVM. Vor der Multipath-Einrichtung erscheinen zwei Geräte mit jeweils 512 GiB. Sie stellen zwei Wege zu derselben LUN dar und dürfen nicht als unabhängige Datenträger verwendet werden.

</section><section id="bkmrk-5.-iscsi-multipath-a">## 5. iSCSI-Multipath auf den Proxmox-Knoten einrichten

### Multipath-Werkzeuge installieren und Sitzungen prüfen

Auf allen drei Hosts wird die Installation der Multipath-Werkzeuge angestoßen:

```
apt-get install multipath-tools -y
```

Auf pve1 und pve2 ist der Installationsabschluss sichtbar. Auf pve3 bestätigen die späteren Abfragen die Verfügbarkeit. Die iSCSI-Sitzungen werden mit folgendem Befehl geprüft:

```
iscsiadm -m session
```

Auf pve3 sind Verbindungen zu beiden Portalen über TCP-Port 3260 sichtbar.

### Dieselbe LUN über ihre WWID identifizieren

Im gezeigten Beispiel heißen die beiden Pfadgeräte auf pve3 `/dev/sdd` und `/dev/sde`. Ihre Identität wird so abgefragt:

```
/lib/udev/scsi_id -g -u -d /dev/sdd
/lib/udev/scsi_id -g -u -d /dev/sde
```

Beide liefern die WWID `36589cfc00000005cf4f3f236e1d7b5b0`. Die Gerätenamen können auf anderen Hosts oder nach einem Neustart abweichen. Vor einer Übernahme der Befehle müssen die tatsächlich vorhandenen Geräte geprüft werden.

### WWID registrieren und Multipath kontrollieren

```
multipath -a 36589cfc00000005cf4f3f236e1d7b5b0
multipath -r
multipath -ll
```

<figure>[![Proxmox pve1: multipath -ll zeigt die TrueNAS-LUN mit 512 GiB und zwei verfügbaren Pfaden](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-44-02.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-44-02.png)

<figcaption>Die Ausgabe zeigt ein logisches Multipath-Gerät und zwei Pfade mit „active ready running“.</figcaption></figure>Vergleichbare abschließende Ausgaben sind auf allen drei Hosts sichtbar. Eine aktive und eine weitere verfügbare Pfadgruppe sind dokumentiert. Ein praktischer Ausfalltest wurde damit noch nicht nachgewiesen.

### Wichtige Korrektur: Konfiguration und WWID-Datei trennen

Im Workshop wird zwischenzeitlich ein `multipaths { … }`-Block mit einem Alias in `/etc/multipath/wwids` eingetragen. **Ein solcher Block gehört in die Multipath-Konfiguration, üblicherweise `/etc/multipath.conf`.** Die WWID-Datei dient der Registrierung der Geräte und wird über die Multipath-Werkzeuge gepflegt.

Später wird die WWID erneut hinzugefügt und die Datei zwischen Hosts kopiert. Obwohl die abschließenden Geräteausgaben erfolgreich sind, ist der endgültige Dateiinhalt nicht sichtbar. Die Bereinigung muss deshalb vor einer Abnahme geprüft werden.

### iSCSI-Timeouts auf tatsächliche Wirksamkeit prüfen

Auf pve3 wird in `/etc/iscsi/iscsid.conf` folgende Einstellung gezeigt:

```
node.session.timeo.replacement_timeout = 15
```

Eine spätere Sitzungsdetailansicht zeigt weiterhin `Recovery Timeout: 120`. Das deutet darauf hin, dass die geänderte Vorgabe in der betrachteten Sitzung noch nicht wirksam war. Konfigurationsdatei, gespeicherte Verbindungseinträge und aktive Sitzungen müssen gemeinsam geprüft werden.

### SSH-Loginprobleme nach manuellen Verbindungen zwischen den Knoten

Während der Einrichtung können bei manuellen SSH-Verbindungen zwischen den Nodes Loginprobleme auftreten, beispielsweise durch widersprüchliche gespeicherte Hostschlüssel. Eine manuelle Verbindung verursacht nicht grundsätzlich einen Fehler; entscheidend ist die konkrete SSH-Meldung.

Bei einem veralteten Hostschlüsseleintrag lässt sich beispielsweise so vorgehen: Zunächst den aktuellen Fingerprint auf dem Zielknoten über eine vertrauenswürdige Konsole anzeigen und mit der SSH-Meldung vergleichen:

```
ssh-keygen -lf /etc/ssh/ssh_host_ed25519_key.pub
```

Nur wenn der Schlüsselwechsel geklärt ist und die Fehlermeldung auf `/root/.ssh/known_hosts` verweist, auf dem Quellknoten die betroffenen Einträge entfernen. Beispiel für pve2:

```
ssh-keygen -f /root/.ssh/known_hosts -R pve2
ssh-keygen -f /root/.ssh/known_hosts -R 192.168.168.22
ssh root@pve2
```

Beim erneuten Verbindungsaufbau den angezeigten Fingerprint prüfen. Bei abweichendem Hostnamen oder Dateipfad die Angaben aus der tatsächlichen Fehlermeldung verwenden; nicht pauschal die gesamten Known-Hosts-Dateien löschen.

Bei veralteten Proxmox-Hostschlüsseldaten, etwa nach erneutem Beitritt eines Nodes mit gleichem Namen oder gleicher IP, kann auf dem betroffenen Zielknoten außerdem Folgendes helfen:

```
pvecm updatecerts
```

Proxmox verwendet versionsabhängig eigene Hostschlüsseldateien beziehungsweise explizites Host-Key-Pinning. Ein erfolgreicher manueller SSH-Login allein bestätigt daher nicht jede von Proxmox verwendete SSH-Verbindung. Siehe die [Proxmox-Clusterdokumentation zur Rolle von SSH](https://github.com/proxmox/pve-docs/blob/master/pvecm.adoc). Bei „Permission denied (publickey)“ stattdessen die Anmeldung mit Schlüsseln und die Zugriffsrechte prüfen; das Entfernen eines Hostschlüsseleintrags behebt diesen anderen Fehler nicht.

</section><section id="bkmrk-6.-gemeinsamen-lvm-s">## 6. Gemeinsamen LVM-Speicher auf der iSCSI-LUN hinzufügen

Unter **Datacenter → Storage → Add → LVM** wird der Speicher `truenas` angelegt. Als Basisspeicher dient `iscsi-portal`, als Basisvolume die LUN 0. Die Volume Group erhält im Workshop den Namen `pve`. Zugelassen sind VM-Festplatten und Container.

<figure>[![Proxmox-LVM-Assistent: Speicher truenas auf iscsi-portal mit Volume Group pve anlegen](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-45-09.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-45-09.png)

<figcaption>Bei der ursprünglichen Anlage wurde der Haken bei „Shared“ vergessen; dies wurde später korrigiert.</figcaption></figure>Die Ausgabe von `pvs` auf pve1 ordnet die Volume Group dem Multipath-Gerät unter `/dev/mapper/…` zu. Proxmox zeigt etwa 549,75 GB Gesamtkapazität, entsprechend ungefähr 512 GiB.

Später werden **Shared** und **Wipe Removed Volumes** aktiviert. Die Option **Allow Snapshots as Volume-Chain** bleibt eingeschaltet.

<figure>[![Proxmox-LVM-Speicher truenas: Shared und Snapshots as Volume-Chain sind ausgewählt](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-49-13.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-49-13.png)

<figcaption>Die spätere Bearbeitung markiert den LVM-Speicher als gemeinsam genutzt.</figcaption></figure>**Shared stellt keine Speicherverbindung her.** Die Einstellung beschreibt einen bereits von mehreren Knoten erreichbaren Speicher. Alle Hosts müssen dieselbe LUN und Volume Group erkennen.

Die Oberfläche kennzeichnet Volume-Chain-Snapshots als Technology Preview. QCOW2 auf LVM ist in diesem Zusammenhang nicht automatisch falsch: Das [Proxmox-Administrationshandbuch](https://pve.proxmox.com/pve-docs/pve-admin-guide.pdf) beschreibt diese Funktion für neuere Versionen. Bei bereits vorhandenen abhängigen Volumes darf die Option nicht unvorbereitet deaktiviert werden.

</section><section id="bkmrk-7.-vm-festplatte-auf">## 7. VM-Festplatte auf TrueNAS verschieben und Migration prüfen

Als Beispiel dient VM `100 (TRMM)` mit 8 GiB RAM, vier CPU-Kernen, CPU-Typ `host`, OVMF/UEFI und einer 32-GiB-Systemfestplatte. Die VM verwendet einen VirtIO-SCSI-single-Controller und ein VirtIO-Netzwerkgerät an `vmbr0`.

### Systemfestplatte auf den LVM-Speicher verschieben

In der Hardwareansicht wird für `scsi0` die Aktion zum Verschieben des Speichers geöffnet. Ausgewählt sind das Ziel `truenas`, das Format `qcow2` und das Löschen der Quelle nach dem Verschieben.

<figure>[![Proxmox VM 100: scsi0 im QCOW2-Format auf den Speicher truenas verschieben](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-46-31.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-46-31.png)

<figcaption>Die 32-GiB-Systemfestplatte wird von lokalem ZFS auf den TrueNAS-LVM-Speicher verschoben.</figcaption></figure>Das Zielvolume lautet `truenas:vm-100-disk-0.qcow2`. Die spätere Aufgabenliste bestätigt den Verschiebevorgang mit `OK`. Um 16:48 Uhr liegt die EFI-Disk noch auf `local-zfs`. Ein weiterer erfolgreicher Verschiebetask ist sichtbar, dessen betroffenes Volume jedoch nicht eindeutig belegt ist.

### Migrationsfehler gelöst: Shared, ZFS-Replikation und alle VM-Disks prüfen

Mehrere Offline-Migrationen von pve1 nach pve2 enden mit `Error: migration aborted`. Frühere Dialoge warnen vor lokalen Datenträgern. Nach dem Aktivieren von „Shared“ zeigt der abgebildete Dialog diese Warnungen nicht mehr.

<figure>[![Proxmox-Migration von VM 100 nach pve2 mit Warnungen zur lokalen EFI-Disk und zum Speicher truenas](https://aow.de/uploads/images/gallery/2026-09/scaled-1680-/bildschirmfoto-2026-09-07-um-16-48-06.png)](https://aow.de/uploads/images/gallery/2026-09/bildschirmfoto-2026-09-07-um-16-48-06.png)

<figcaption>Vor der Shared-Korrektur behandelt der Dialog auch die Festplatte auf truenas als lokalen Speicher.</figcaption></figure>**Die Ursache wurde im weiteren Workshop-Verlauf geklärt:** Für die betroffene VM war noch ein ZFS-Replikationsjob eingerichtet. Dieser verbliebene Job verursachte die fehlgeschlagene Migration. Zusätzlich war bei der Anlage des LVM-Speichers zunächst der Haken bei „Shared“ vergessen worden.

Für den Wechsel auf den gemeinsamen iSCSI-Speicher wurden deshalb folgende Punkte umgesetzt:

1. **Shared aktivieren:** Den tatsächlich auf allen Knoten erreichbaren LVM-Speicher als gemeinsam genutzt markieren.
2. **Keine bisherigen ZFS-Replikationsjobs zurücklassen:** Die für die umgestellte VM eingerichteten Jobs unter „Replication“ entfernen und deren Entfernung abwarten. Die native lokale ZFS-Replikation wird für die nun gemeinsam genutzten iSCSI-Disks nicht benötigt.
3. **Alle Disks migrieren:** Neben der System- und den Datenfestplatten auch die EFI-Disk und eine gegebenenfalls vorhandene TPM-State-Disk auf den gemeinsamen Speicher verschieben. Bestehende EFI- und TPM-Datenträger übernehmen, nicht neu erstellen.

**Danach liefen alle Migrationen tadellos.** Dieses Ergebnis wurde nachträglich aus dem Workshop bestätigt; die eingebetteten Screenshots zeigen noch die vorherigen Zwischenstände.

### Letzter dokumentierter Stand: Klonvorgang läuft

Der letzte Screenshot um 16:55 Uhr zeigt einen laufenden Klonvorgang von VM 111 mit etwa 21 Prozent Fortschritt. Das Zielvolume gehört zu VM 101 auf `truenas`. Ein Abschluss ist nicht abgebildet. Der im Hintergrund sichtbare Replikationsjob von VM 111 nach pve2 gehört noch zum aufgenommenen Zwischenstand. Der Klonabschluss ist nicht abgebildet; die anschließend fehlerfrei laufenden Migrationen wurden nachträglich bestätigt.

</section><section id="bkmrk-8.-pr%C3%BCfliste-f%C3%BCr-die">## 8. Prüfliste für die Abnahme des gemeinsamen Speichers

- Auf jedem Proxmox-Knoten sind beide TrueNAS-Portale verbunden.
- Alle Knoten erkennen dieselbe WWID und zwei fehlerfreie Multipath-Pfade.
- Die gemeinsame Volume Group ist über das Multipath-Gerät erreichbar.
- Multipath-Konfiguration und WWID-Registrierung sind korrekt getrennt.
- Die gewünschten iSCSI-Timeouts sind in den verwendeten Verbindungen wirksam.
- Shared ist aktiviert; auf allen Knoten ist tatsächlich derselbe Speicher erreichbar.
- Für die auf iSCSI umgestellten VMs sind keine bisherigen ZFS-Replikationsjobs mehr eingerichtet.
- Sämtliche VM-Disks einschließlich EFI und gegebenenfalls TPM liegen auf dem gemeinsamen Speicher.
- Eine Offline-Migration endet mit OK; die VM startet und funktioniert auf dem Zielhost.
- Ein kontrollierter Test bestätigt den Weiterbetrieb beim Ausfall eines einzelnen SAN-Pfads.
- Nach einem Host-Neustart sind Speicher und beide Verbindungen automatisch verfügbar.
- Ein unabhängiges Backup wurde erfolgreich wiederhergestellt und geprüft.

</section><section id="bkmrk-9.-optimierungstipps">## 9. Optimierungstipps für Proxmox, TrueNAS und iSCSI-Multipath

### Bewährte Konfiguration für weitere Migrationen übernehmen

1. **Multipath-Dateien vereinheitlichen:** Prüfe die Konfiguration und die registrierten WWIDs auf allen Hosts. Vergleiche vorhandene Inhalte, bevor Dateien überschrieben werden.
2. **Shared und Replikationsjobs prüfen:** Im Workshop war Shared zunächst vergessen worden; ein verbliebener ZFS-Replikationsjob verursachte den Migrationsabbruch. Bei weiteren Umstellungen Shared aktivieren und bisherige ZFS-Replikationsjobs der betroffenen VM entfernen. Bei neuen Fehlern zusätzlich das vollständige Migrationslog auswerten.
3. **Alle VM-Datenträger berücksichtigen:** Verschiebe neben der Systemfestplatte auch Daten-, EFI- und gegebenenfalls TPM-State-Disks auf den gemeinsamen Speicher.
4. **Timeouts kontrolliert übernehmen:** Kläre die Abweichung zwischen den konfigurierten 15 Sekunden und den sichtbaren 120 Sekunden. Änderungen an bestehenden Speicherverbindungen gehören in ein Wartungsfenster.

### Ausfallsicherheit praktisch nachweisen

5. **Unabhängige SAN-Wege verwenden:** Getrennte Subnetze sollten durch geeignete physische Wege ergänzt werden. Prüfe Adapter, Verkabelung und Switches auf gemeinsame Ausfallpunkte. Die [TrueNAS-Netzwerkempfehlungen](https://www.truenas.com/docs/solutions/optimizations/networking/) erläutern die Verwendung zusätzlicher iSCSI-Portale.
6. **Pfadwechsel testen:** Unterbrich mit einer Test-VM und laufenden Ein-/Ausgaben jeweils nur einen SAN-Pfad. Prüfe anschließend auch dessen Wiederkehr und einen Host-Neustart.
7. **TrueNAS-Ausfall einplanen:** Mirror und Multipath schützen gegen unterschiedliche Teilfehler. Der vollständige Ausfall eines einzelnen TrueNAS-Systems erfordert weiterhin einen Wiederanlaufplan und unabhängige Sicherungen.

### Leistung, Wartung und Sicherheit verbessern

8. **Vorschaufunktionen gezielt testen:** Prüfe bei Volume-Chain-Snapshots insbesondere Erstellung, Löschen, Backup, Restore und Migration mit der eingesetzten Version.
9. **Eindeutige Namen wählen:** Bei künftigen Einrichtungen lässt sich eine Volume Group wie `vg_truenas_iscsi` leichter zuordnen als `pve`. Bestehende Gruppen nicht ohne Prüfung ihrer Referenzen umbenennen.
10. **Leistung messen:** Erfasse Durchsatz, IOPS und Latenz in einer Test-VM, bevor MTU, Pfadverteilung oder ZFS-Parameter geändert werden. Jumbo Frames benötigen eine durchgängig passende Netzwerkkonfiguration.
11. **SSD-Wartung ergänzen:** Prüfe TRIM-Unterstützung und Laufwerksüberwachung. Im dokumentierten Stand ist Auto TRIM ausgeschaltet; Temperaturdaten fehlen. Überwache außerdem Poolkapazität, Speicherfehler und ausgefallene Pfade.
12. **Zugriffe begrenzen:** Behalte eindeutige Initiatorlisten bei und beschränke die SAN-Erreichbarkeit auf die vorgesehenen Hosts. Prüfe CHAP oder Mutual CHAP als zusätzliche Authentifizierung. CHAP verschlüsselt den Datenverkehr nicht. Weitere Informationen enthält die [TrueNAS-iSCSI-Dokumentation](https://www.truenas.com/docs/scale/shares/iscsi/).
13. **Backups unabhängig speichern:** Sichere VMs außerhalb der produktiven LUN und dokumentiere einen erfolgreichen Restore mit VM-Start und Anwendungstest. Mirror, Snapshots und Replikation ersetzen dieses Backup nicht.

### Round Robin aktivieren: beide gleichwertigen SAN-Pfade nutzen

Round Robin verteilt I/O reihum auf die Pfade einer aktiven Pfadgruppe. Bei gleichwertigen Verbindungen kann dies beide SAN-Links besser auslasten. Eine Verdopplung der Leistung ist nicht garantiert; `service-time` kann bei unterschiedlich schnellen oder belasteten Wegen günstiger sein.

Der gezeigte Stand hat je Pfad eine eigene Gruppe. Der Selektor allein genügt daher nicht. **Nur wenn beide Wege gleichzeitig gleichwertig nutzbar sind**, eignet sich `multibus` für eine gemeinsame Gruppe. Bei ALUA- oder Active/Passive-Systemen die herstellergerechte Gruppierung beibehalten.

Auf jedem Node den bestehenden Eintrag dieser LUN in `/etc/multipath.conf` ergänzen; übrige Konfiguration erhalten:

```
multipaths {
    multipath {
        wwid 36589cfc00000005cf4f3f236e1d7b5b0
        path_grouping_policy multibus
        path_selector "round-robin 0"
        rr_weight uniform
        rr_min_io_rq 1
    }
}
```

`rr_min_io_rq 1` bewirkt bei request-basiertem Multipath einen Wechsel nach einer I/O-Anforderung. Das Beispiel verändert keinen Gerätealias.

Im Wartungsfenster zunächst die aufgelöste Konfiguration auf Fehler prüfen, dann neu laden:

```
multipath -t
multipathd reconfigure
multipath -ll
```

Erwartet: `round-robin 0` und beide gesunden Pfade in derselben aktiven Gruppe. Danach Durchsatz, Latenz und Pfadausfall mit einer Test-VM prüfen. Die Option ist eine Optimierungsempfehlung, kein im Workshop belegter Änderungsschritt. Parameterreferenz: [Debian-Handbuch zu multipath.conf](https://manpages.debian.org/trixie/multipath-tools/multipath.conf.5.en.html).

</section></article>

# OPNsense Migration Legacy zu Instance, ohne neues Ausrollen von Konfigurationen

# OPNsense: OpenVPN Legacy zu Instances migrieren – ohne Neukonfiguration der Clients

In OPNsense werden die bisherigen **OpenVPN-Legacy-Konfigurationen** abgekündigt. Wer unter **VPN → OpenVPN → Legacy** arbeitet, kennt vermutlich bereits die folgende Meldung:

> **This component is reaching the end of the line, official maintenance will end as of version 26.1**

Bestehende OpenVPN-Server sollten daher von der bisherigen Legacy-Konfiguration auf **OpenVPN Instances** migriert werden.

Die Migration ist grundsätzlich unkompliziert. Wenn die vorhandenen Parameter korrekt übernommen werden, kann die Umstellung erfolgen, **ohne die komplette VPN-Konfiguration neu auszurollen**. Es gibt allerdings einige Punkte, auf die besonders geachtet werden sollte.

---

## 1. Bestehende Legacy-Konfiguration dokumentieren

Öffnet zunächst die vorhandene OpenVPN-Konfiguration unter:

**VPN → OpenVPN → Legacy**

Die dort vorhandenen Werte werden anschließend in die neue Instanz übernommen. Es empfiehlt sich daher, die bestehende Konfiguration vor der Migration vollständig zu dokumentieren.

**Wichtig:** Die alte Konfiguration zunächst nicht löschen. Sie dient während der Migration als Referenz für sämtliche Einstellungen.

---

## 2. Alten OpenVPN-Server deaktivieren

Deaktiviert den bisherigen OpenVPN-Legacy-Server.

Da die neue Instanz denselben Port verwenden soll, darf der alte und der neue OpenVPN-Server nicht gleichzeitig auf diesem Port lauschen.

---

## 3. Shared Key übernehmen

Falls die bisherige OpenVPN-Konfiguration einen **Shared Key / TLS Static Key** verwendet, muss dieser zunächst übernommen werden.

Öffnet dazu:

**VPN → OpenVPN → Static Keys**

Übernehmt dort den bisherigen Schlüssel und verwendet als:

<table id="bkmrk-einstellung-wert-mod"><thead><tr><th>Einstellung</th><th>Wert</th></tr></thead><tbody><tr><td>Mode</td><td>**Auth**</td></tr></tbody></table>

Dieser Key wird später der neuen OpenVPN-Instanz zugeordnet.

---

## 4. Neue OpenVPN-Instanz erstellen

Erstellt nun unter OpenVPN eine neue Instanz.

Mindestens die folgenden Einstellungen müssen aus der bisherigen Legacy-Konfiguration übernommen werden:

<table id="bkmrk-neue-openvpn-instanc"><thead><tr><th>Neue OpenVPN Instance</th><th>Wert / Quelle aus Legacy</th></tr></thead><tbody><tr><td>**Role**</td><td>Server</td></tr><tr><td>**Enabled**</td><td>Yes</td></tr><tr><td>**Port Number**</td><td>Bisherigen Port übernehmen, z. B. `1194`</td></tr><tr><td>**Type**</td><td>TUN</td></tr><tr><td>**Server IP**</td><td>Wert aus *IPv4 Tunnel Network*, z. B. `172.16.1.0/24`</td></tr><tr><td>**Topology**</td><td>subnet</td></tr><tr><td>**Certificate**</td><td>Alten Eintrag aus *Server Certificate* übernehmen</td></tr><tr><td>**Certificate Authority**</td><td>Alten Eintrag aus *Peer Certificate Authority* übernehmen</td></tr></tbody></table>

---

## 5. Advanced Mode aktivieren

Blendet anschließend links oben den **Advanced Mode** ein.

Dadurch werden zusätzliche Einstellungen sichtbar, die für eine möglichst identische Übernahme der bisherigen Legacy-Konfiguration benötigt werden.

---

## 6. TLS Static Key konfigurieren

Unter:

**TLS Static Key**

wählt ihr den zuvor unter **Static Keys** angelegten bzw. übernommenen Schlüssel aus.

---

## 7. Authentifizierung übernehmen

Die bisherigen Authentifizierungsparameter müssen ebenfalls übernommen werden.

<table id="bkmrk-einstellung-konfigur"><thead><tr><th>Einstellung</th><th>Konfiguration</th></tr></thead><tbody><tr><td>**Auth**</td><td>Alten Wert aus *Auth Digest Algorithm* übernehmen, z. B. `SHA256`</td></tr><tr><td>**Authentication**</td><td>Bisherigen Authentifizierungsserver auswählen, sofern vorhanden</td></tr><tr><td>**Renegotiate Time**</td><td>`3600`</td></tr><tr><td>**Auth Token Lifetime**</td><td>`43200`</td></tr></tbody></table>

Als Authentication Backend kann beispielsweise ein vorhandener **Domain Controller, UCS-Server oder Samba Active Directory** verwendet werden.

---

## 8. Lokales Netzwerk übernehmen

Unter:

**Local Network**

übernehmt ihr den bisherigen Wert aus:

**IPv4 Local Network**

Damit werden die bisher über den VPN-Tunnel erreichbaren internen Netzwerke wieder entsprechend bereitgestellt.

---

## 9. Achtung bei Compression

Hier befindet sich einer der wichtigen Fallstricke bei der Migration.

Falls in der bisherigen Legacy-Konfiguration unter **Compression** ein Wert ausgewählt war, muss in der neuen Instance im **Advanced Mode** zusätzlich:

**Compression Migrate**

aktiviert werden.

**Achtung:** Dies gilt auch dann, wenn in der bisherigen Konfiguration bei Compression **Disabled** ausgewählt war.

---

## 10. Weitere Parameter prüfen

Abhängig von der bisherigen OpenVPN-Konfiguration können weitere Parameter erforderlich sein. Vergleicht daher vor dem produktiven Einsatz die neue Instance vollständig mit der bisherigen Legacy-Konfiguration.

Besonders geprüft werden sollten:

- Port und Protokoll
- Tunnel-Netzwerk
- lokale Netzwerke
- Zertifikate und Certificate Authority
- TLS Static Key
- Authentifizierungsserver
- Auth Digest Algorithm
- Compression-Einstellungen
- zusätzliche Advanced-Optionen

---

## Besonderheit der OPNsense Business Edition

**Hinweis zur Business Edition:** Die OPNsense Business Edition **24.10** verfügt noch nicht über die Option **Compression Migrate**.

Für entsprechende bestehende Konfigurationen muss daher auf eine geeignete **Business-Version 25.x** gewartet werden.

---

## Technischer Stand

Diese Anleitung basiert auf dem technischen Stand von **April 2025**. Die beschriebene Migration wurde mit:

`OPNsense 25.1.4_1-amd64`

durchgeführt.

**Hinweis:** OPNsense entwickelt die OpenVPN-Instance-Konfiguration kontinuierlich weiter. Bezeichnungen und verfügbare Optionen können sich in neueren Versionen ändern.

[![image.png](https://aow.de/uploads/images/gallery/2025-04/scaled-1680-/image.png)](https://aow.de/uploads/images/gallery/2025-04/image.png)

# Backup und Replikation trojanersicher für Proxmox VE mit Miyagi Workflow

# Trojanersichere Backups und Replikationen mit Proxmox Backup Server, ZFS und Miyagi

**Ziel ist eine Datensicherung mit drei Kopien der Daten, mindestens zwei Standorten und zwei unterschiedlichen Sicherungsmethoden.** Zusätzlich muss die Kontrolle der Backups und Replikationen zuverlässig, automatisch und ohne Fehlerquote funktionieren.

Unsere Lösung kombiniert **Proxmox Backup Server**, **ZFS-Replikation**, **Snapshots**, **Monitoring mit Checkmk** und den **Miyagi-Workflow**. Dadurch entstehen sowohl klassische Backups mit langer Historie als auch startfähige ZFS-Replikate für schnelle Wiederherstellung im Notfall.

> **Backups bieten ein Wiederherstellungsversprechen.**
> 
> **ZFS-Replikate bieten eine sehr schnelle Wiederherstellungsmöglichkeit, weil replizierte Systeme auf geeigneter Hardware direkt gestartet werden können.**

## Was wir erreichen wollen

- Native Proxmox-Backups ohne Löschmöglichkeit von der Quelle
- Startfähige ZFS-Replikate auf einem zweiten System
- Lückenloses Monitoring aller Backups und Replikationen
- Serialisierte Sicherungen für bessere Performance
- Automatisierte Updates, Backupwartung und Verifizierung
- Automatisches Herunterfahren des Sicherungsservers nach Abschluss
- Zentrales Dashboard für Backupstatus, Replikation und Systemzustand
- Schnelle Wiederherstellung über Proxmox Backup Server oder ZFS-Replikate

> Als Ergebnis entsteht eine Backuphistorie über mehrere Monate bis Jahre sowie ein ZFS-Replikat mit typischer Aufbewahrung von ca. 14 Tagen bis drei Monaten.

[ ![Backup- und Replikationsübersicht mit Proxmox Backup Server und ZFS](https://aow.de/uploads/images/gallery/2025-05/scaled-1680-/uBuimage.png) ](https://aow.de/uploads/images/gallery/2025-05/uBuimage.png)

## Beispiel auf dem Zielserver

```bash
# Auf dem Zielserver sollte das dann so aussehen

# Proxmox Backups mit Snapshot-Schutz gegen Kompromittierung
zfs list
rpool/pbsstore                    4.9T  30.4T  4.62T  /rpool/pbsstore 

# PVE mit LXC Container
rpool/repl/lwpve2/rpool/data/subvol-100-disk-0    168G  34.8G   165G  /rpool/repl/lwpve2/rpool/data/subvol-100-disk-0
rpool/repl/lwpve2/rpool/data/subvol-102-disk-0    918M  31.1G   872M  /rpool/repl/lwpve2/rpool/data/subvol-102-disk-0

# PVE mit KVM
rpool/repl/lwpve3/rpool3/data/vm-301-disk-0       267K  41.0T   169K  -
rpool/repl/lwpve3/rpool3/data/vm-301-disk-1      40.6G  41.0T  26.7G  -
rpool/repl/lwpve3/rpool3/data/vm-301-disk-2       277G  41.0T   214G  -

# ZVOLs finden sich unter /dev/zvol/rpool...
```

> Backups benötigen für eine Wiederherstellung den richtigen Zeitpunkt, genügend freien Platz und Zeit. ZFS-Replikate können dagegen auf ausreichend leistungsfähiger Hardware sehr schnell produktiv gestartet werden.
> 
> Die Aufbewahrungszeiten für Backups und Replikate können selbst festgelegt werden.

---

## Überlegungen zu Proxmox VE, ZFS und Ceph

**Proxmox VE** ist eine leistungsfähige Virtualisierungsplattform auf Basis von **KVM** und **LXC**. Viele ältere VMware- und Hyper-V-Umgebungen können auf Proxmox VE migriert werden.

Der eigentliche Nutzen von Proxmox entsteht aber nicht nur durch die Weboberfläche, sondern durch die Kombination mit **ZFS**, **Ceph**, **SDN**, Snapshots, Replikation und dem **Proxmox Backup Server**.

> Nutzt man Proxmox VE nur mit Hardware-RAID oder klassischem SAN, verliert man viele Vorteile, die Proxmox in Verbindung mit ZFS oder Ceph eigentlich bietet.

**ZFS** eignet sich besonders für kleinere und mittlere Installationen mit einem bis drei Proxmox-Servern. Hier können Systeme performant betrieben, regelmäßig snapshotiert und auf weitere Systeme repliziert werden.

**Ceph** kommt vor allem dann ins Spiel, wenn im Fehlerfall möglichst kein Datenverlust entstehen darf und ausreichend Budget, Netzwerkleistung und Know-how vorhanden sind. In der Praxis bedeutet Ceph häufig einen deutlich höheren Hardware- und Betriebsaufwand.

> Mit ZFS erreicht man realistisch eine Sicherungslücke von unter fünf Minuten oder besser, wenn es notwendig ist. Nur weil bei einem Server das Licht ausgeht, sind die Daten noch lange nicht verloren.

### Empfehlung für kleinere Umgebungen

- Ein bis drei Proxmox-Server bevorzugt mit ZFS betreiben
- ZFS-Snapshots regelmäßig automatisieren
- ZFS-Replikation auf ein zweites System einrichten
- Zusätzlich Proxmox Backup Server für längere Historie nutzen
- Monitoring für Backup, Replikation und ZFS-Zustand einrichten

---

## Snapshots gegen Bedienfehler, Fahrlässigkeit und Ransomware

Vor Umstellungen, Updates oder riskanten Maßnahmen erstellt ein Administrator üblicherweise einen Snapshot. Bei VMware oder Hyper-V können zu viele oder zu lange bestehende Snapshots schnell zum Problem werden.

Hier spielt **ZFS** seine Stärke aus. ZFS-Snapshots sind sehr effizient und können regelmäßig erstellt werden, ohne den Betrieb in gleicher Weise zu belasten.

> Durch die Arbeitsweise von ZFS sind permanente Snapshots im produktiven Betrieb ein großer Vorteil.

### Empfohlene Snapshot-Strategie

Für automatische Snapshots eignen sich beispielsweise **zfs-auto-snapshot** oder **CV4PVE** als Web-GUI für Proxmox VE.

- 12 Snapshots alle 15 Minuten für schnelle Hilfe in den letzten drei Stunden
- 96 stündliche Snapshots für vier Tage
- 21 tägliche Snapshots für drei Wochen
- 6 wöchentliche Snapshots für sechs Wochen
- 3 monatliche Snapshots für unentdeckte Fehler

Für Aufbewahrungszeiten über drei Monate hinaus eignet sich zusätzlich die tägliche Sicherung mit dem **Proxmox Backup Server**.

> Wichtig: Das System sollte nicht dauerhaft über 80 % belegt werden. Bei zu hoher Belegung müssen Aufbewahrungszeiten reduziert werden.

---

## Proxmox Backup Server: Segen und Risiko

Der **Proxmox Backup Server** ist ein hervorragendes Sicherungswerkzeug für virtuelle Maschinen und Linux-Container auf Proxmox VE. Er bietet inkrementelle Backups, Deduplizierung, Verifizierung und effiziente Wiederherstellung.

Das Standarddesign sieht allerdings vor, dass Proxmox VE seine Sicherungen zum Proxmox Backup Server schiebt. Dadurch entsteht im Ernstfall Angriffsfläche, wenn Zugangsdaten oder Berechtigungen zu weit gefasst sind.

> Der Backup-Benutzer sollte ausschließlich Sicherungs- und Wiederherstellungsrechte besitzen.
> 
> 2FA, ein API-Token mit minimalen Rechten und deaktivierter SSH-Passwortlogin sind Pflicht.

### Typische Probleme im Standardbetrieb

- Der Backupserver muss häufig dauerhaft laufen
- Automatisches Einschalten und Herunterfahren ist nicht vorgesehen
- Monitoring der Backups ist nicht komfortabel integriert
- Mailbenachrichtigungen reichen für professionelle Kontrolle oft nicht aus
- Ein zentrales Dashboard für Backup-, Replikations- und ZFS-Zustand fehlt

---

## Der Miyagi-Workflow

Der **Miyagi-Workflow** kombiniert Proxmox Backup Server, ZFS-Replikation, Wartung, Updates, Verifizierung und Monitoring in einem Ablauf.

Das Ziel ist ein Backupserver an einem anderen Standort, der nur für den Sicherungslauf aktiv ist, die Sicherungen kontrolliert, Replikate erstellt und anschließend wieder herunterfährt.

### Voraussetzungen

- Proxmox VE 8.4 oder neuer
- ZFS RAID10 empfohlen, RAIDZ möglich aber langsamer
- Optional zfs-auto-snapshot oder CV4PVE Snapshotmanager
- Separater Sicherungsserver mit möglichst viel Speicherplatz
- Empfohlen: HPE Microserver mit ECC und mehreren großen HDDs
- Proxmox Backup Server 3.4 oder neuer
- Installation idealerweise ebenfalls auf ZFS
- Bashclub Postinstaller für checkzfs und zsync auf beiden Systemen
- Optional Checkmk-Agent auf PVE und PBS

Bashclub Postinstaller:

```bash
https://github.com/bashclub/proxmox-zfs-postinstall
```

---

## Proxmox Backup Server vorbereiten

### SSH-Zugriff vorbereiten

- Auf dem PBS den Inhalt von `.ssh/id_rsa.pub` kopieren
- Den Key in Proxmox VE unter `.ssh/authorized_keys` ergänzen
- Einmalig per SSH vom PBS zum PVE verbinden, um den Hostkey zu speichern

### Wichtige Hinweise zur PBS-Konfiguration

> **Kein NFS als Datastore für Proxmox Backup Server verwenden.**

Optional kann beim Booten ein iSCSI-LUN von Synology oder einem anderen System eingebunden werden, wenn keine lokalen Platten genutzt werden.

```bash
@reboot iscsiadm --mode node --targetname "iqn.2xxxx" --portal "10.ipsyn...:3260" --login && zpool import -f iscsi
```

### ZFS-Pool und Dataset für PBS erstellen

Bei direkter Nutzung von Festplatten:

```bash
zpool create -f iscsi /dev/sdx -o autoexpand=on
zfs create iscsi/pbsstore -o recordsize=1M -o com.sun:auto-snapshot=false
```

Bei nativ installiertem PBS:

```bash
zfs create rpool/pbsstore -o recordsize=1M -o com.sun:auto-snapshot=false
```

Die Festplatten sollten idealerweise über `/dev/disk/by-id` eingebunden werden.

### Datastore im Proxmox Backup Server anlegen

- Bei iSCSI: `/iscsi/pbsstore`
- Bei nativer Installation: `/rpool/pbsstore`
- Purge, Garbage Collection und Verifyjobs zunächst deaktiviert anlegen
- Benutzer `backup@pbs` mit starkem Passwort und 2FA anlegen
- API-Key `backup@pbs!backup` anlegen
- Berechtigung **Datastore Backup** für Benutzer und API-Key setzen

### Datastore in Proxmox VE einrichten

In Proxmox VE wird ein neuer Datastore vom Typ **Proxmox Backup Server** eingerichtet.

[ ![Proxmox Backup Server Datastore in Proxmox VE einrichten](https://aow.de/uploads/images/gallery/2025-05/scaled-1680-/image.png) ](https://aow.de/uploads/images/gallery/2025-05/image.png)

Danach sollte direkt aus einer VM oder einem LXC ein Testbackup ausgeführt werden.

> **Achtung:** Proxmox VE setzt den Store `local` standardmäßig teilweise auf Typ Backup. Das sollte dringend deaktiviert werden.

---

## Miyagi installieren

Die Installation erfolgt auf dem Proxmox Backup Server.

```bash
apt install git open-iscsi
git clone -b dev https://github.com/bashclub/miyagi-pbs-zfs.git
cd miyagi-pbs-zfs
cp config.example ipdeinespve.conf
nano ipdeinespve.conf
```

> Das Miyagi-Script sichert einen Proxmox VE Host mit maximal zwei ZFS-Pools auf ein Ziel. Für weitere Hosts oder Pools werden einfach mehrere Konfigurationsdateien verwendet.

### Beispielkonfiguration

```bash
SSHPORT='22'

BACKUPSERVER=yes
MAINTDAY=6
SHUTDOWN=yes
UPDATES=yes

SOURCEHOST='dein-pve-ip'

# ZFS-Replikation
ZFSROOT='rpool/data'
ZFSSECOND='rpool-hdd/data'
ZFSTRGT='rpool/repl'

ZPOOLSRC=rpool
ZPOOLDST=rpool

# ZSYNC für ZFS-Replikation
ZPUSHTAG=bashclub:zsync
ZPUSHMINKEEP=3
ZPUSHKEEP=14
ZPUSHLABEL=zsync
ZPUSHFILTER="daily,weekly,monthly"

# Backup
PBSHOST='ip-des-pbs'
BACKUPSTORE=backup
BACKUPSTOREPBS=backup
BACKUPEXCLUDE='99999'
```

### Wichtige Parameter

- `BACKUPSERVER=yes`: Proxmox Backup ausführen
- `MAINTDAY=6`: Wartungstag, idealerweise Samstag
- `SHUTDOWN=yes`: Backupserver nach Abschluss herunterfahren
- `UPDATES=yes`: Updates auf dem PBS ausführen
- `ZPUSHKEEP=14`: Anzahl der aufzubewahrenden Replikationsstände
- `ZPUSHFILTER`: vorhandene Snapshots wie daily, weekly, monthly mitnehmen
- `BACKUPEXCLUDE`: auszuschließende VMs oder LXC, Komma-getrennt

---

## Testlauf durchführen

```bash
/root/miyagi-pbs-zfs/pbs-zfs-daily.sh -c /root/miyagi-pbs-zfs/192.x.x.x.conf
```

Die Ausgabe sollte zuerst die ZFS-Replikation und anschließend das Proxmox-Backup anzeigen. Danach fährt der Server bei entsprechender Konfiguration herunter.

### Kontrolle des Testlaufs

#### Proxmox Backup Server

- In Proxmox VE unter Cluster / Datastores den Backupstore wieder aktivieren
- In den VMs/LXCs oder im Store kontrollieren, ob Backups vorhanden sind

#### ZFS-Replikation auf dem PBS prüfen

```bash
checkzfs --sourceonly
```

Alternativ:

```bash
checkzfs --source ippve --filter rpool/data --threshold 1500,2000 --columns +message
```

#### ZFS-Replikation auf dem PVE prüfen

```bash
cat /var/lib/check_mk_agent/spool/*
```

---

## Monitoring mit Checkmk

Ein zentraler Bestandteil des Workflows ist das Monitoring ohne Fehlerquote. Backups und Replikationen sollen nicht nur laufen, sondern zuverlässig überwacht werden.

### Service Discovery auf Proxmox VE

[ ![Checkmk Service Discovery für Proxmox Backup Status](https://aow.de/uploads/images/gallery/2025-05/scaled-1680-/VOHimage.png) ](https://aow.de/uploads/images/gallery/2025-05/VOHimage.png)

Dieser Dienst zeigt den Status des letzten Backups.

[ ![Checkmk Kontrolle von ZFS Replikationen](https://aow.de/uploads/images/gallery/2025-05/scaled-1680-/JDYimage.png) ](https://aow.de/uploads/images/gallery/2025-05/JDYimage.png)

Dieser Dienst zeigt alle Quelldatasets und Volumes. Wenn innerhalb eines Tages keine neuen Daten kommen, geht der Status auf **Unknown**.

### Ausgeschalteten Miyagi-Server überwachen

Da der Sicherungsserver nach Abschluss herunterfahren kann, wird in Checkmk ein eigener Host angelegt.

- Host mit Namen nach Schema `miyagi-quelle-ziel` anlegen
- Kein Agent und keine API notwendig
- Spezialprüfung für den letzten bekannten Backupstatus verwenden

[ ![Checkmk Host für ausgeschalteten Miyagi Backupserver](https://aow.de/uploads/images/gallery/2025-05/scaled-1680-/KyUimage.png) ](https://aow.de/uploads/images/gallery/2025-05/KyUimage.png)

Nach der Service Discovery erscheint der entsprechende Status.

[ ![Checkmk Miyagi Backup Monitoring](https://aow.de/uploads/images/gallery/2025-05/scaled-1680-/wjhimage.png) ](https://aow.de/uploads/images/gallery/2025-05/wjhimage.png)

> Damit bleibt auch ein ausgeschalteter Backupserver kontrollierbar. Wenn innerhalb eines Tages keine neuen Daten eintreffen, geht der Status auf Unknown.

---

## Warum dieser Ansatz trojanersicherer ist

Der zentrale Vorteil liegt in der Kombination mehrerer Schutzebenen:

- Snapshots schützen gegen Bedienfehler und schnelle Verschlüsselung
- ZFS-Replikate ermöglichen einen schnellen Start auf Ersatzhardware
- Proxmox Backup Server bietet lange Historie und Deduplizierung
- Der Backupserver muss nicht dauerhaft erreichbar sein
- API-Token und minimale Rechte reduzieren Angriffsflächen
- Checkmk überwacht Erfolg, Alter und Vollständigkeit der Sicherungen

## Fazit

Mit **Proxmox VE**, **ZFS**, **Proxmox Backup Server**, **Miyagi** und **Checkmk** entsteht ein sehr robuster Backup- und Replikationsworkflow für kleine und mittlere Unternehmen.

Die Lösung kombiniert eine lange Backuphistorie mit schnell startfähigen Replikaten und einer zentralen Überwachung. Damit lassen sich Ausfälle, Bedienfehler und Ransomware-Schäden deutlich besser beherrschen.

## Passende Schulungen

Wenn Sie diesen Workflow im Detail verstehen oder gemeinsam aufbauen möchten, passen besonders diese Kurse auf [cloudistboese.de](https://cloudistboese.de):

- Replikationen und Backups trojanersicher
- Proxmox produktiv mit ZFS betreiben
- ZFS Grundlagen
- IT Monitoring und Kontrolle mit Checkmk, Tactical RMM und Wazuh

# Migration Univention Corporate Server & Kopano nach Zamba AD & Mailcow

# Univention Corporate Server durch Zamba AD und Mailcow ersetzen

**Migration von Univention UCS und Kopano zu Zamba Active Directory, Mailcow und Proxmox VE.** Viele kleinere Unternehmen nutzen **Univention Corporate Server** hauptsächlich als Domain Controller und Benutzerverwaltung. Wenn UCS nur noch als Active Directory dient und Kopano ohnehin abgelöst werden soll, ist der Betrieb häufig unnötig aufwendig.

Mit **Zamba Active Directory**, **Mailcow**, **Proxmox VE**, optional **Proxmox Mail Gateway** und **Mailpiler** lässt sich eine schlanke, moderne Open-Source-Infrastruktur aufbauen, die schneller wartbar ist und sich ideal für kleine und mittlere Unternehmen eignet.

> **Updates von Mailcow und Zamba AD Controller laufen künftig in wenigen Minuten statt in mehreren Stunden.**
> 
> Kunden, die Keycloak oder eine vollständig vom Hersteller supportete UCS-Umgebung benötigen, sollten weiterhin bei Univention bleiben.

**Passende Kurse finden Sie auf [cloudistboese.de](https://cloudistboese.de) unter den Themen Mailcow, Domain Controller ablösen und Alles ohne Windows.**

---

## Vorteile der Migration

- Univention UCS kann in kleinen Umgebungen ersetzt werden
- Active Directory bleibt mit Samba/Zamba erhalten
- Mailcow ersetzt Kopano als moderne Groupware
- Updates werden deutlich einfacher und schneller
- Proxmox VE ermöglicht Snapshots, Backups und einfache Wiederherstellung
- LDAP-Anbindung für Mailcow, Mailpiler und weitere Dienste bleibt möglich
- Die Umgebung wird schlanker, transparenter und besser wartbar

## Systemvoraussetzungen

- Bestehender Univention Corporate Server im AD-Modus
- Kopano oder vergleichbare Groupware mit IMAP-Zugriff
- Proxmox VE 8.x oder neuer
- Linux Container mit installiertem Git
- Grundkenntnisse in DNS, Active Directory, Mailservern und Proxmox VE

## Übersicht der Migration

1. Zamba Active Directory als zweiten Domain Controller installieren
2. Active Directory replizieren und prüfen
3. DNS auf den neuen Domain Controller umstellen
4. Mailcow installieren
5. LDAP-Anbindung in Mailcow konfigurieren
6. Benutzer und Mailboxen synchronisieren
7. Mails von Kopano nach Mailcow migrieren
8. Kalender und Kontakte übernehmen
9. Aliase und Weiterleitungen prüfen
10. Mailcow produktiv schalten
11. FSMO-Rollen übernehmen
12. Univention UCS demoten und abschalten
13. LDAP-Clients auf den neuen Zamba AD umstellen

---

## Zamba Active Directory als zweiten Domain Controller installieren

Die Installation erfolgt auf dem Proxmox Host, zum Beispiel im Verzeichnis `/root`.

```bash
git clone -b dev https://github.com/bashclub/zamba-lxc-toolbox
cd zamba-lxc-toolbox
cp conf/zamba.conf.example conf/zamba.conf
```

### zamba.conf anpassen

In der Datei `conf/zamba.conf` werden die Werte an die bestehende Umgebung angepasst.

```bash
LXC_TEMPLATE_STORAGE="local"
LXC_ROOTFS_SIZE="32"
LXC_ROOTFS_STORAGE="rpool-data"
LXC_SHAREFS_SIZE="100"
LXC_SHAREFS_STORAGE="rpool-data"

LXC_HOSTNAME="zmb-ad"
LXC_DOMAIN="windomain.local"
LXC_IP="10.0.0.254/24"
LXC_GW="10.0.0.1"
LXC_DNS="10.0.0.4"

LXC_BRIDGE="vmbr0"
LXC_PWD='Admin123'

ZMB_REALM="WINDOMAIN.LOCAL"
ZMB_DOMAIN="WINDOMAIN"
ZMB_ADMIN_USER="administrator"
ZMB_ADMIN_PASS='Admin123'
```

**Hinweis:** `LXC_DNS` zeigt zunächst auf den alten UCS-DNS-Server. Bei Windows-Domänen sollte vorher gegebenenfalls das Funktionslevel geprüft werden.

### Zamba AD Join starten

```bash
bash install.sh -i 100
```

Im Menü wird **Zamba-AD-Join** gewählt.

### Replikation prüfen

Nach der Installation kann der Container betreten und die Replikation geprüft werden.

```bash
pct enter 100
su -
wbinfo -u
wbinfo -g
```

Wenn alle Benutzer und Gruppen angezeigt werden, ist der Join grundsätzlich erfolgreich.

> **Empfehlung:** In Proxmox sollte anschließend der alte UCS-DNS-Server aus der Hostkonfiguration entfernt werden, sobald der neue Zamba AD DNS zuverlässig funktioniert.

### smb.conf anpassen

Folgende Anpassungen können in der `smb.conf` hilfreich sein:

```bash
vi /etc/samba/smb.conf
```

```ini
[global]
ldap server require strong auth = no
dns forwarder = 1.1.1.1 1.0.0.1
```

---

## DNS auf den neuen Domain Controller umstellen

DNS ist bei Active Directory fast immer der kritischste Punkt. Sobald der neue Zamba Domain Controller sauber repliziert, werden feste IP-Konfigurationen und DHCP-Einstellungen angepasst.

- Alle Server mit statischer IP erhalten den neuen Zamba AD als DNS-Server
- Im DHCP-Server wird der alte UCS-DNS durch den neuen DC ersetzt
- Alte UCS-DNS-Einträge werden später bereinigt
- RSAT DNS-Konsole zur Kontrolle verwenden

> **Merksatz:** It was DNS.

---

## Mailcow installieren

Für Mailcow wird ein weiterer LXC verwendet. Die Installation erfolgt ebenfalls über die Zamba LXC Toolbox.

```bash
cp conf/zamba.conf.example conf/zamba.conf
```

Für Mailcow müssen insbesondere Hostname und Netzwerkeinstellungen angepasst werden.

```bash
bash install.sh -i 101
```

Im Menü wird **Mailcow** gewählt.

### Mailcow aktualisieren

```bash
pct enter 101
su -
cd /opt/mailcow-dockerized
apt install jq
./update.sh
```

Danach wird das Mailcow-Webinterface geöffnet:

```
https://10.0.0.253/admin
```

---

## Grundkonfiguration von Mailcow

### Unbedingt notwendige Schritte

- **Admin-Passwort ändern:** System / Konfiguration / Administrator bearbeiten
- **Alle Maildomains eintragen:** E-Mail / Konfiguration / Domains
- **Schwellwerte und Quotas beachten**
- **LDAP-Bind-User im AD anlegen:** zum Beispiel `bind-mailcow`

### LDAP in Mailcow konfigurieren

Die LDAP-Anbindung erfolgt unter:

> System / Konfiguration / Zugang / Identity Provider

- Identity Provider: LDAP
- Host: IP des neuen Zamba AD
- Port: 636
- Benutze SSL: an
- Ignoriere SSL Fehler: an
- Base DN: `CN=Users,DC=windomain,DC=local`
- Username Feld: `mail`
- Attribute Feld: `mail`
- Bind DN: `CN=bind-mailcow,CN=Users,DC=windomain,DC=local`
- Bind Passwort: Passwort des Bind-Users
- Attribute Mapping: Standardvorlage / Default
- Benutzer beim Login erstellen: an
- Vollsynchronisation: an
- Importiere Benutzer: an
- Sync / Import interval: für den Anfang 1 Minute

Der Erfolg wird unter **E-Mail / Mailboxen** kontrolliert.

---

## E-Mails von Kopano nach Mailcow migrieren

Die Migration erfolgt über IMAP-Synchronisation.

### Mailcow Sync Job erstellen

In Mailcow:

> E-Mail / Synchronisationen / Neuen Sync Job erstellen

- Host: IP des Kopano-Servers
- Port: 993
- Benutzername: Windows-Loginname
- Elemente ausschließen: Regex-Inhalt entfernen, da zu gefährlich
- `--delete2duplicates` nur verwenden, solange Mails noch auf Kopano laufen

> Kopano hat standardmäßig IMAP teilweise deaktiviert. In der `server.conf` nach `disable` suchen oder in UMC beim Benutzer unter Kopano IMAP aktivieren.

Der Erfolg der Synchronisation sollte im Dialog und in den Logs kontrolliert werden.

---

## Kalender aus Kopano exportieren

Kopano stellt Kalender über CalDAV bereit. Beispiele:

<table id="bkmrk-http%3A%2F%2Fkopano%3A8080%2Fc"><tbody><tr><td>`http://kopano:8080/caldav/<user>/<folder-name>/`</td><td>Kalender oder Aufgabenordner im Benutzerpostfach</td></tr><tr><td>`http://kopano:8080/caldav/<user>/<sub-folder>/`</td><td>Selbst erstellter Unterkalender</td></tr><tr><td>`http://kopano:8080/caldav/<other-user>/<folder-name>/`</td><td>Freigegebener Kalender eines anderen Benutzers</td></tr><tr><td>`http://kopano:8080/caldav/public/<foldername>/`</td><td>Öffentlicher Kalender</td></tr><tr><td>`http://kopano:8080/caldav/<user>/`</td><td>Standardkalender des Benutzers</td></tr></tbody></table>

Die exportierten Dateien können anschließend im SOGo-Frontend oder in einem Mailclient importiert werden.

---

## Kontakte exportieren und importieren

### Kontakte exportieren

Der Export kann über den alten Mailclient erfolgen. Alternativ kann ein Python-Script mit Kopano-MAPI genutzt werden.

```bash
sudo apt install python3-kopano
mkdir export
wget https://raw.githubusercontent.com/bashclub/trmm-scripts/refs/heads/main/kopano-export-contacts.py
python3 kopano-export-contacts.py
```

Das Script exportiert Kontakte in Unterordner pro Benutzer, da Kopano kein echtes CardDAV für diesen Zweck bereitstellt.

### Kontakte importieren

- Outlook kann beim Export oder Import Probleme verursachen
- SOGo importiert Kontakte oft nur einzeln
- eM Client war in der Praxis häufig die beste Lösung für den Import vieler VCF-Dateien per Drag &amp; Drop

Beispiel für CardDAV-Anbindung:

```
https://kunde.dyndns.org/SOGo/dav/user@domain.de/Contacts/personal/
```

---

## Aliase und Weiterleitungen übernehmen

### Aliase finden

```bash
univention-ldapsearch -LLL | grep @ | grep mailAlternative
```

Aliase werden in Mailcow unter **E-Mail / Aliasse / Alias hinzufügen** eingetragen.

### Weiterleitungen finden

```bash
univention-ldapsearch -LLL | grep mailForward
```

> Weiterleitungen werden im SOGo-Webfrontend unter E-Mail konfiguriert, nicht direkt in Mailcow.

---

## Mailcow produktiv schalten

### NAT und Portweiterleitungen

Auf der Firewall, zum Beispiel OPNsense, können Aliase verwendet werden.

```
p_mailcow: 80 443 465 993 4190
h_mailcow: 10.0.0.253
```

Port Forwarding:

```
any > WAN IP > p_mailcow > h_mailcow
```

### Mailcow neu starten

```bash
pct enter 101
su -
rm /opt/mailcow-dockerized/data/conf/nginx/redirect.conf
cd /opt/mailcow-dockerized
docker compose down
```

### Optional: Greylisting deaktivieren

```bash
vi /opt/mailcow-dockerized/data/conf/rspamd/local.d/greylist.conf
```

```ini
enabled = false;
```

### Optional: Let’s Encrypt Einstellungen

```bash
vi /opt/mailcow-dockerized/mailcow.conf
```

```ini
SKIP_LETS_ENCRYPT=n
SKIP_HTTP_VERIFICATION=y
```

```bash
docker compose up -d
```

### Let’s Encrypt kontrollieren

```bash
docker compose logs --tail=200 -f acme-mailcow
```

### Alternativ eigenes Zertifikat verwenden

Eigene Zertifikate können hier abgelegt werden:

```
/opt/mailcow-dockerized/data/assets/ssl
```

- `cert.pem`
- `key.pem`

Danach DNS-Werte beim Provider kontrollieren:

> E-Mail / Domains / DNS

---

## Abschluss der Migration

- Synchronisationen nach erfolgreicher Migration deaktivieren
- Optional Proxmox Mail Gateway auf Mailcow verweisen
- Alten Univention Corporate Server abschalten
- FSMO-Rollen auf Zamba AD übertragen
- Alte UCS-Fragmente bereinigen
- LDAP-Clients auf neuen Zamba AD umstellen

### FSMO-Rollen übernehmen

```bash
pct enter 100
su -
samba-tool fsmo transfer --role=all -Uadministrator
samba-tool domain demote --remove-other-dead-server=UCS
rm /etc/cron.d/sysvol-sync
```

### Bereinigung

- RSAT DNS-Konsole nach alten Fragmenten durchsuchen
- Alte DNS-Einträge entfernen
- Optional Metadata Cleanup durchführen

### LDAP-Clients anpassen

Für bestehende LDAP-Clients werden neue Bind-User pro Rolle angelegt. Anschließend werden die LDAP-Parameter angepasst.

- IP: neuer Zamba AD
- Port: von 7389 auf 636 mit SSL ändern
- UID auf `sAMAccountName` ändern
- Bind DN von `uid` auf `cn` ändern

---

## Proxmox Mail Gateway mit Mailcow verbinden

### Greylisting in Mailcow deaktivieren

```bash
vi /opt/mailcow-dockerized/data/conf/rspamd/local.d/greylist.conf
```

```ini
enabled = false;
```

```bash
docker compose restart rspamd-mailcow
```

### Routing in Mailcow

- Konfiguration / Routing / Networks
- `ipvompmg:26`
- Greylisting deaktivieren

### Senderabhängige Transport Maps

- Für alle Maildomains, die PMG nutzen
- ID 1: `ipvompmg:26`

### Proxmox Mail Gateway

- Configuration / Mail Proxy
- Relay Domain setzen
- Transport zur Mailcow konfigurieren
- Kein MX für internen Transport verwenden

Beim DNS-Provider werden die PMG-Werte statt der direkten Mailcow-Werte gesetzt.

---

## Mailpiler als Mailarchiv integrieren

Mailpiler kann ebenfalls über die LXC Toolbox installiert werden.

### Mailcow für Archivweiterleitung vorbereiten

- System / Konfiguration / Einstellungen / Weiterleitungs-Hosts
- IP des Mailpilers eintragen

### BCC an das Archiv

- System / Konfiguration / Routing / Transport
- Ziel: `piler.windomain.local`
- Next Hop: `10.0.0.x`

### BCC-Maps einrichten

Unter:

> E-Mail / Konfiguration / Adressumschreibung / BCC-Maps

Für jede Maildomain jeweils eingehend und ausgehend:

- Lokales Ziel: `sysops.tv`
- BCC-Ziel: `piler@piler.windomain.local`
- Domain: `sysops.tv`

Kontrolle im Mailpiler:

```bash
tail -f /var/log/mail.log
```

> Eine LDAP-Anpassung im Mailpiler wäre in `config-site.php` möglich, funktioniert jedoch nicht zuverlässig für Aliase.

---

## Doppelte Mails bei mehrfacher Kopano-Synchronisation vermeiden

Die IMAP-Kompatibilität von Kopano ist in der Praxis oft problematisch. Wenn Mails doppelt oder dreifach erscheinen, kann eine gezielte Bereinigung und erneute Synchronisation helfen.

```bash
apt install kopano-migration-imap
nano migrate.sh
```

```bash
#!/bin/bash

set -euo pipefail

if [ "$#" -ne 6 ]; then
  echo "Verwendung:"
  echo "$0 <host1> <host2> <user1> <pass1> <user2> <pass2>"
  exit 1
fi

HOST1="$1"
HOST2="$2"
USER1="$3"
PASS1="$4"
USER2="$5"
PASS2="$6"

MAILCOW_DOVECOT_CONTAINER="565cef8dac49"

echo "=========================================="
echo "Bereinige Zielordner auf Mailcow"
echo "=========================================="

docker exec "$MAILCOW_DOVECOT_CONTAINER" \
  doveadm expunge -u "$USER2" mailbox "Gesendet" ALL || true

docker exec "$MAILCOW_DOVECOT_CONTAINER" \
  doveadm mailbox delete -u "$USER2" "Sent" || true

docker exec "$MAILCOW_DOVECOT_CONTAINER" \
  doveadm mailbox delete -u "$USER2" "Gesendete Objekte" || true

docker exec "$MAILCOW_DOVECOT_CONTAINER" \
  doveadm mailbox delete -u "$USER2" "Gesendete Objekte/Gesendete Objekte" || true

echo "=========================================="
echo "Starte IMAP Sync"
echo "=========================================="

kopano-migration-imap \
  --host1 "$HOST1" \
  --host2 "$HOST2" \
  --user1 "$USER1" \
  --password1 "$PASS1" \
  --user2 "$USER2" \
  --password2 "$PASS2" \
  --ssl1 \
  --ssl2 \
  --regextrans2 's#^Gel&APY-schte Objekte$#Papierkorb#' \
  --useheader Message-Id \
  --addheader \
  --usecache \
  --syncinternaldates \
  --skipsize \
  --nofoldersizes \
  --nofoldersizesatend \
  --delete2 \
  --delete2folders \
  --delete2duplicates \
  --exclude '(?i)^trash$|^junk$|^spam$|^unwanted$|^&U3CPbg-($|/)'

echo "=========================================="
echo "Migration abgeschlossen"
echo "=========================================="
```

Ausführen mit:

```bash
bash migrate.sh quellip zielip login passwortucs email@adresse.de passwortmailcow
```

> Das Beispiel nimmt keine Papierkörbe oder Spam-Ordner mit. Dies wird über `--exclude` gesteuert.

---

## Optionale DNS-Einträge für Autokonfiguration

Für Thunderbird, eM Client und weitere Programme können SRV-Records gesetzt werden, damit Mail, Kalender und Kontakte automatisch gefunden werden.

```
_autodiscover._tcp  IN  SRV  0 0 443 q.deine-domain.de.
_caldavs._tcp       IN  SRV  0 1 443 q.deine-domain.de.
_carddavs._tcp      IN  SRV  0 1 443 q.deine-domain.de.
_imaps._tcp         IN  SRV  0 1 993 q.deine-domain.de.
_matrix._tcp        IN  SRV  0 1 465 matrix.deine-domain.de.
_sieve._tcp         IN  SRV  0 1 4190 mail.deine-domain.de.
_smtps._tcp         IN  SRV  0 1 465 q.deine-domain.de.
_submissions._tcp   IN  SRV  0 1 465 q.deine-domain.de.
```

---

## Fazit

Mit **Zamba Active Directory**, **Mailcow** und **Proxmox VE** lässt sich eine bestehende Univention-/Kopano-Umgebung vollständig durch moderne Open-Source-Komponenten ersetzen. Für kleine und mittlere Unternehmen entsteht eine schlanke, wartbare und zukunftssichere Infrastruktur.

- Active Directory bleibt erhalten
- Kopano wird durch Mailcow ersetzt
- Updates werden deutlich schneller
- Proxmox VE ermöglicht einfache Snapshots und Backups
- Mailpiler und Proxmox Mail Gateway können integriert werden
- Der Betrieb wird transparenter und besser kontrollierbar

## Passende Schulungen

Wenn Sie die Migration unter Anleitung durchführen möchten, finden Sie passende Live-Schulungen auf [cloudistboese.de](https://cloudistboese.de):

- Windows Domain Controller mit Samba/Zamba ablösen
- Open-Source Mailserver mit Mailcow betreiben
- Alles ohne Windows
- Proxmox produktiv mit ZFS betreiben
- Replikationen und Backups trojanersicher

# Proxmox Best Practice Setup für ZFS und / oder Ceph im Cluster für Einsteiger (Stand Dezember 2024)

# Proxmox Cluster mit ZFS und Ceph – Best Practices für Einsteiger

## Praxiswissen aus rund 150 Proxmox- und ZFS-Systemen

Der Verfasser dieses Artikels, **Christian-Peter Zengel**, verfügt über rund **15 Jahre Praxiserfahrung mit Proxmox VE und ZFS** und betreibt aktuell etwa **150 Systeme mit Proxmox und ZFS**.

Die Erfahrungen reichen von Standalone-Installationen bis hin zu Proxmox-Clustern mit bis zu zehn Hosts. Der Schwerpunkt liegt klar auf **ZFS, Replikation, Backup, Monitoring und praxistauglicher Hochverfügbarkeit**.

**Hinweis:** Dieser Artikel versteht sich nicht als Ceph-Expertenleitfaden. Ceph wird hier vor allem zum Funktionsvergleich und als Einstieg behandelt. Für viele kleine und mittlere Installationen bis etwa zehn Hosts ist ZFS mit Replikation in unserer Praxis häufig die einfachere, günstigere und besser beherrschbare Lösung.

---

## Proxmox Best Practice Kurs mit ZFS und Ceph

Diese Dokumentation basiert auf einem Onlinekurs von **cloudistboese.de**.

[ **Proxmox Best Practice Cluster mit ZFS und Ceph für Einsteiger** ](https://cloudistboese.de/course/view.php?id=78)

Der Kurs vermittelt einen schnellen, praxisnahen Einstieg in den Aufbau eines Proxmox-Clusters mit ZFS, einfacher Ceph-Grundlage, Backup, Snapshots, Monitoring und Hochverfügbarkeit.

[ **Aktuelle Kurse und Wiederholungen auf cloudistboese.de ansehen** ](https://cloudistboese.de)

---

## Für wen eignet sich diese Anleitung?

Der folgende Artikel richtet sich besonders an Einsteiger, Administratoren und IT-Dienstleister, die mit mehr als einem Proxmox-Host starten möchten und eine robuste, nachvollziehbare Cluster-Grundlage suchen.

- Proxmox VE mit ZFS installieren
- Proxmox Cluster mit mehreren Nodes aufbauen
- ZFS-Replikation verstehen und kontrollieren
- VMs und LXCs performant anlegen
- einfache Ceph-Grundlagen kennenlernen
- Proxmox Backup Server integrieren
- Snapshots, Replikation und Monitoring verbessern
- Hochverfügbarkeit sinnvoll einordnen

**Nach diesem Kurs können Sie einen kleinen Proxmox-Cluster sicherer planen, installieren und betreiben.**

---

## ZFS oder Ceph im Proxmox Cluster?

ZFS ist für kleine und mittlere Proxmox-Installationen eine sehr starke Grundlage. Durch Prüfsummen, Snapshots, Replikation und einfache Wiederherstellung schützt ZFS zuverlässig vor vielen typischen Problemen wie defekten Datenträgern, versehentlichen Änderungen und manchen Folgen von Ransomware-Angriffen.

**ZFS ersetzt jedoch kein Backup.** Gegen kompromittierte Root-Zugänge, Brand, Diebstahl, vollständigen Standortausfall oder absichtlich gelöschte Snapshots hilft nur ein sauberes Backup- und Replikationskonzept.

Ceph bietet echten verteilten Storage und hohe Skalierbarkeit, benötigt aber deutlich mehr Hardware, Netzwerkplanung und Betriebserfahrung. Für viele Umgebungen bis etwa zehn Hosts ist ZFS mit Replikation oft wirtschaftlicher und einfacher zu betreiben.

---

## Installation von Proxmox VE auf ZFS

Für den Workshop wird ein HPE Microserver Gen10 Plus V2 verwendet. Empfehlenswert ist eine Ausstattung mit ECC-RAM und direkt ansprechbaren Datenträgern.

[ HPE Microserver Gen10 Plus V2 ansehen ](https://amzn.to/41CmA8o)

[ ![Proxmox VE Installation auf HPE Microserver mit ZFS](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-08-06.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-08-06.jpg)
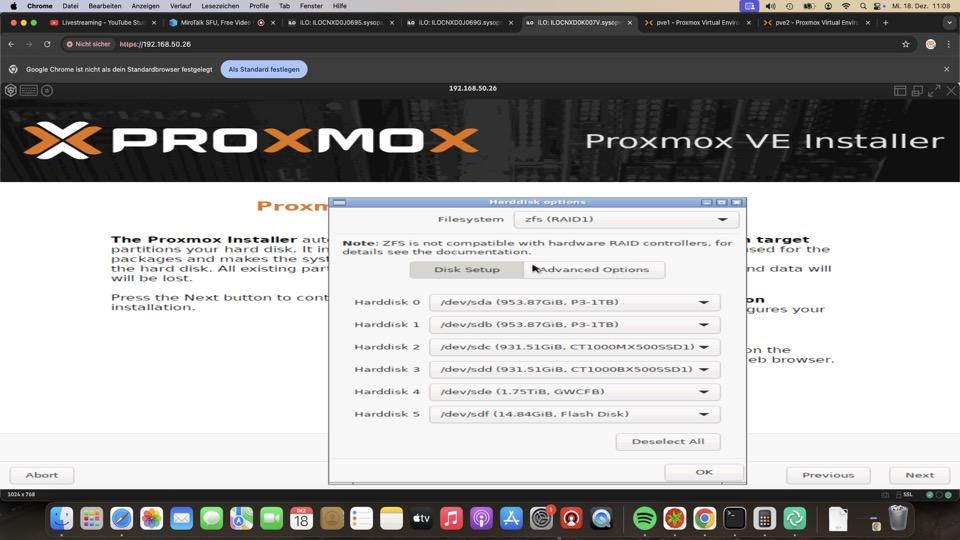
Wir installieren Proxmox VE bevorzugt auf **ZFS Mirror, RAID10 oder RAIDZ**. Hardware-RAID-Controller sollten für ZFS vermieden werden. Empfehlenswert sind Controller im HBA- oder IT-Mode, damit ZFS direkten Zugriff auf die Datenträger erhält.

> Für Cluster sollten Hostnamen, IP-Adressen, Netzwerke und DNS-Einträge vor der Installation sauber geplant werden. Nachträgliche Änderungen verursachen häufig unnötige Zusatzarbeit.

[ ![Proxmox VE Installation mit ZFS Storage Auswahl](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-08-29.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-08-29.jpg)
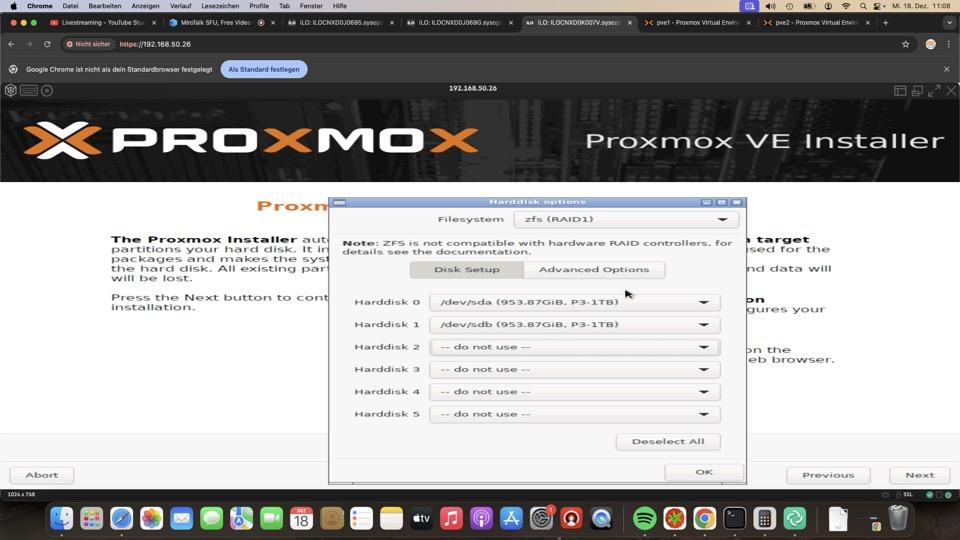
---

## Proxmox Cluster mit drei Nodes erstellen

Ein Proxmox-Cluster kann sehr schnell erzeugt werden. Auch ein einzelner Node kann zunächst problemlos allein laufen. Für echte Cluster-Funktionen und Quorum sollten jedoch mindestens drei Nodes oder ein sinnvoller QDevice-Aufbau geplant werden.

[ ![Proxmox VE Cluster erstellen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-15-59.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-15-59.jpg)
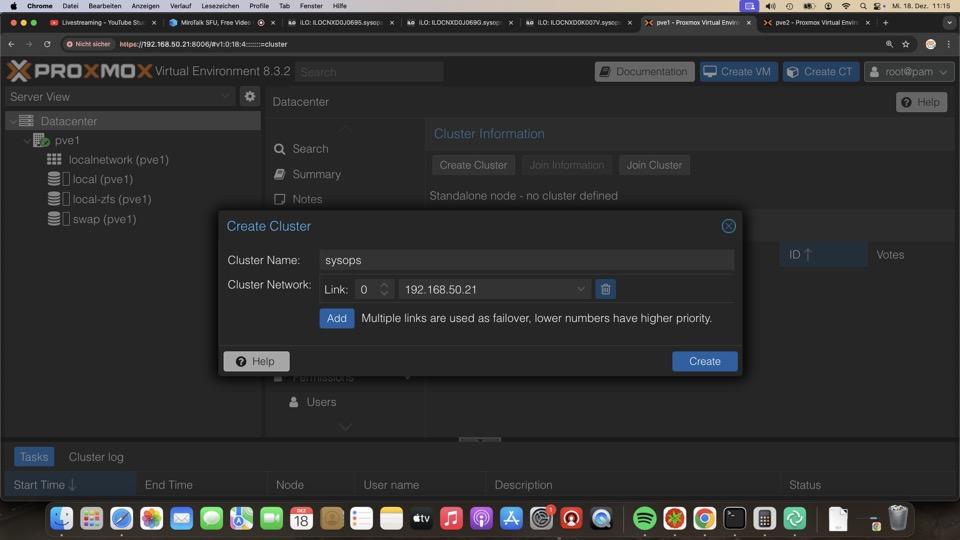
[ ![Proxmox Cluster Join Informationen anzeigen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-17-18.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-17-18.jpg)
[ ![Proxmox Cluster Konfiguration mit mehreren Nodes](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-17-34.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-17-34.jpg)
---

## Weitere Proxmox Nodes hinzufügen

Weitere Nodes werden über die Join-Informationen des ersten Cluster-Nodes hinzugefügt. Auf dem neuen Node werden die Informationen unter **Join Cluster** eingefügt. Zusätzlich werden Root-Passwort und Cluster-Netzwerk angegeben.

[ ![Proxmox VE Join Cluster Dialog](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-17-55.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-17-55.jpg)
[ ![Proxmox VE Cluster Join Einstellungen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-18-05.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-18-05.jpg)
[ ![Proxmox VE Node wird Cluster hinzugefügt](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-18-42.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-18-42.jpg)
> Während des Cluster-Beitritts kann der neue Node kurzzeitig die Verbindung zum Browser verlieren, da Schlüssel und Zertifikate des Clusters übernommen werden. Danach sollte die Weboberfläche neu geladen werden.

[ ![Proxmox Cluster mit mehreren Nodes nach erfolgreichem Join](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-21-06.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-21-06.jpg)
---

## Postinstaller für Proxmox VE

Unser [Proxmox ZFS Postinstaller vom Bashclub](https://github.com/bashclub/proxmox-zfs-postinstall) hilft bei vielen wiederkehrenden Aufgaben nach der Installation.

Für Cluster-Setups sollten die Optionen bewusst gewählt werden. Im Workshop verzichten wir beispielsweise auf Autosnapshots für `rpool/data` und auf SSH-Hardening, soweit dies aus Kompatibilitätsgründen sinnvoll ist.

[ ![Bashclub Proxmox ZFS Postinstaller Einstellungen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-23-17.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-23-17.jpg)
---

## ZFS RAID demonstrieren und überwachen

ZFS-Software-RAID lässt sich im Fehlerfall sehr schnell analysieren und wiederherstellen. Der direkte Zugriff auf die Datenträger ermöglicht ein gutes Monitoring und kann Probleme frühzeitig sichtbar machen.

Im Workshop wird beispielhaft eine Platte vor einem Reboot offline gesetzt. Das ist eine Demonstration und sollte auf produktiven Systemen nicht unüberlegt nachgestellt werden.

[ ![ZFS RAID Status in Proxmox VE](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-23-54.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-23-54.jpg)
[ ![ZFS Pool mit fehlerhaftem Datenträger in Proxmox](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-24-19.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-24-19.jpg)
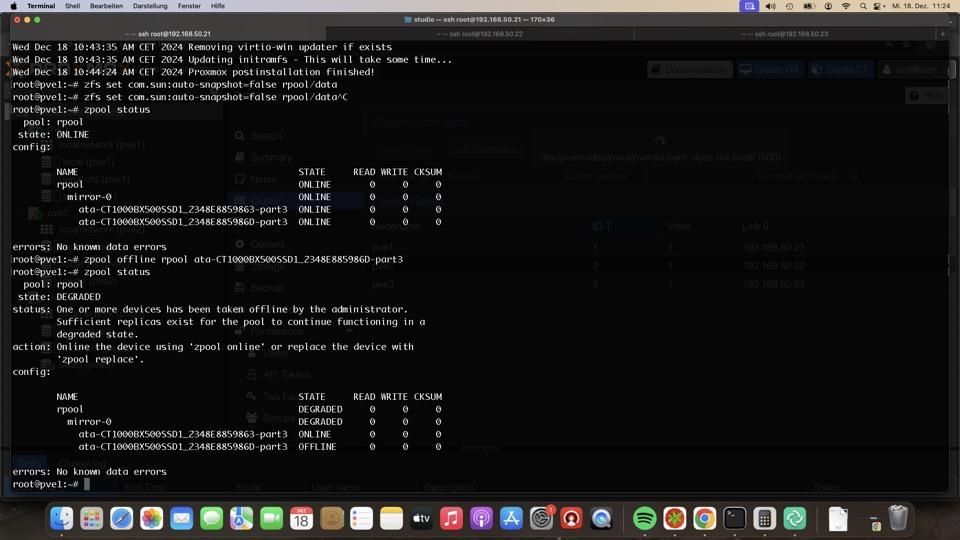
> Das Proxmox-Dashboard zeigt nicht alle Storage-Probleme so deutlich, wie es für den produktiven Betrieb wünschenswert wäre. Für professionelle Umgebungen empfehlen wir zusätzliches Monitoring, zum Beispiel mit Checkmk oder CV4PVE.

[ ![Proxmox Summary Dashboard ohne deutliche ZFS Fehleranzeige](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-24-30.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-24-30.jpg)
[ ![S.M.A.R.T Kontrolle von Datenträgern in Proxmox VE](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-24-34.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-24-34.jpg)
---

## VMs und LXCs unter Proxmox richtig anlegen

Für moderne virtuelle Maschinen sollten heute in der Regel **q35** und **OVMF/UEFI** verwendet werden. Ältere Einstellungen wie i440FX und klassisches BIOS sind für neue Systeme meist nicht mehr empfehlenswert.

[ ![Proxmox VE VM Erstellung mit moderner Hardware-Konfiguration](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-28-12.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-28-12.jpg)
[ ![Proxmox VM mit UEFI und TPM Einstellungen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-28-43.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-28-43.jpg)
- **VirtIO SCSI Single:** gute Performance und eigener Prozess pro Disk
- **QEMU Guest Agent:** wichtig für Shutdown, Freeze, IP-Erkennung und Backups
- **Discard und SSD Emulation:** bessere Rückgabe gelöschter Blöcke an den Host
- **IO Thread:** bessere Entkopplung von I/O-Last
- **CPU Typ Host:** ideal bei identischer Hardware, vorsichtig bei gemischten CPUs im Cluster
- **Ballooning:** ermöglicht dynamischere RAM-Nutzung, benötigt aber passende Treiber

[ ![VirtIO SCSI Single Controller in Proxmox VE](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-29-33.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-29-33.jpg)
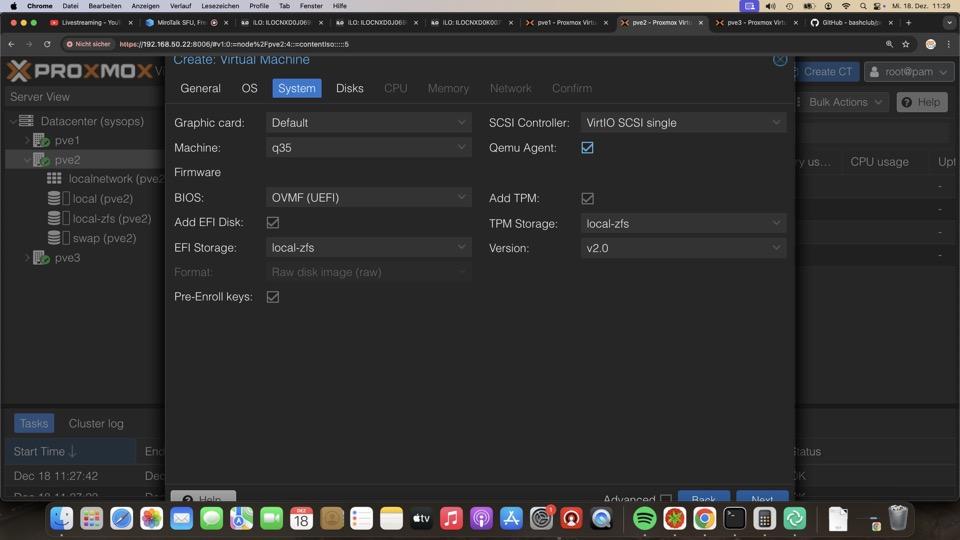
[ ![Proxmox VM Disk Einstellungen mit Discard SSD Emulation und IO Thread](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-30-01.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-30-01.jpg)
[ ![Proxmox CPU Typ Host für virtuelle Maschinen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-30-41.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-30-41.jpg)
[ ![Proxmox Memory Ballooning für virtuelle Maschinen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-31-00.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-31-00.jpg)
[ ![VirtIO Netzwerkkarte für Proxmox VM](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-31-21.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-31-21.jpg)
---

## ZFS-Replikation in Proxmox VE

Die eingebaute ZFS-Replikation von Proxmox VE ist für viele kleine und mittlere Cluster eine sehr gute Grundlage. Bei vorhandener Replikation liegt der größte Teil der VM bereits auf dem Zielsystem und muss nur inkrementell ergänzt werden.

Ohne vorherige Replikation muss die komplette VM oder der komplette Container übertragen werden. Je nach Zustand erfolgt die Übertragung über KVM-Mechanismen oder ZFS. Dabei kann es Unterschiede beim Erhalt von Snapshots geben.

[ ![Proxmox VE ZFS Replikation einrichten](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-32-04.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-32-04.jpg)
[ ![Proxmox VE Replikationsjob für VM](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-32-23.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-32-23.jpg)
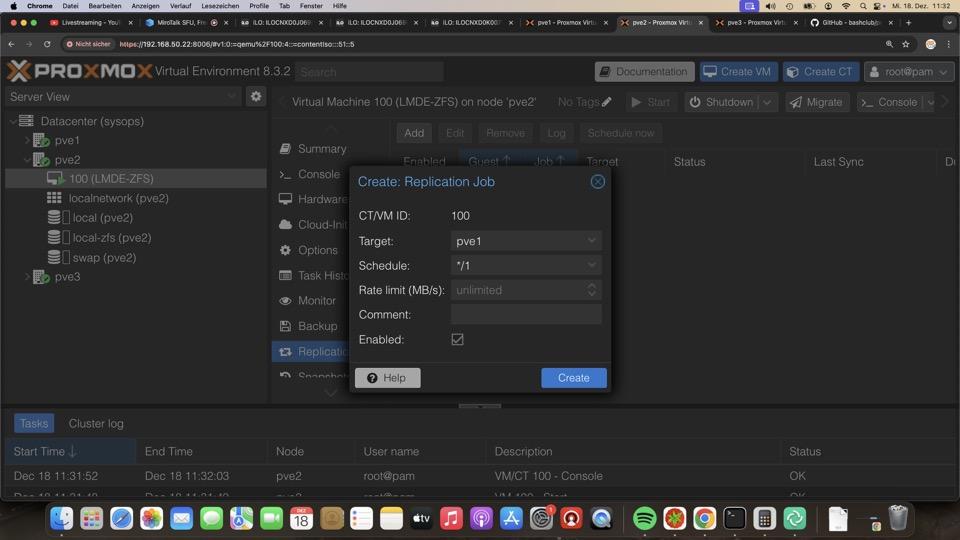
> Replikationsintervalle von 15 bis 60 Minuten sind für viele Umgebungen ein guter Kompromiss. Eine Minute ist technisch möglich, sollte aber nicht pauschal für jede VM verwendet werden.

---

## Ceph-Grundlagen im Proxmox Cluster

Ceph ermöglicht verteilten Storage innerhalb eines Proxmox-Clusters. Dadurch können VMs auf gemeinsamem Storage liegen und bei passender Architektur sehr flexibel zwischen Nodes betrieben werden.

Ceph benötigt jedoch sorgfältige Planung, geeignete Netzwerke, passende Hardware und ausreichende Redundanz.

> Für produktive Ceph-Cluster empfehlen wir mindestens eine Proxmox-Subscription und erfahrene Planung. Ein fehlerhaft aufgebauter Ceph-Cluster kann selbst zum kritischen Ausfallrisiko werden.

[ ![Ceph Installation in Proxmox VE starten](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-44-26.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-44-26.jpg)
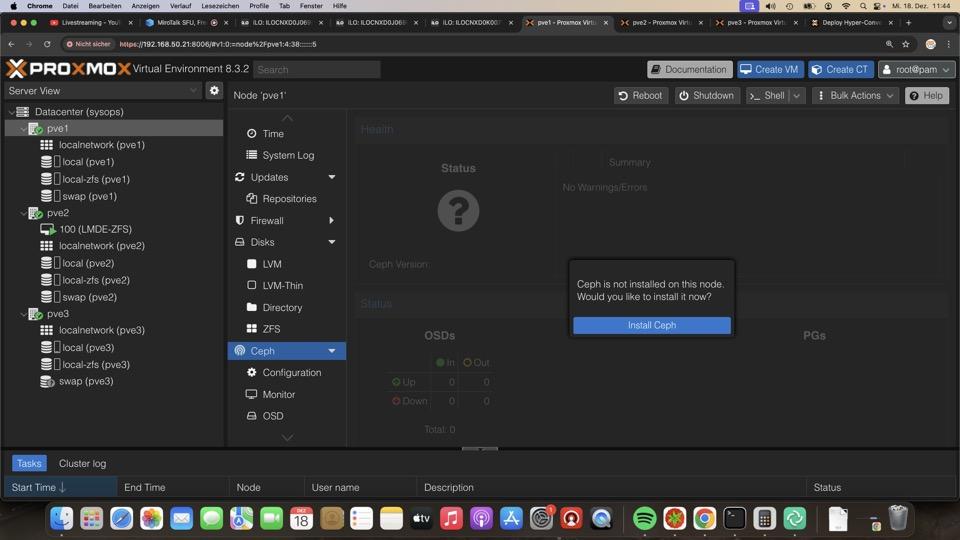
[ ![Ceph Netzwerk und Cluster Einstellungen in Proxmox VE](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-46-22.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-46-22.jpg)
Die Auswahl der Netzwerke für Cluster, Ceph, Redundanz und weitere Segmentierungen sollte durch erfahrene Fachleute erfolgen. Für produktive Ceph-Umgebungen sollte das normale LAN nicht einfach mitverwendet werden.

[ ![Ceph Public und Cluster Network in Proxmox VE](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-47-07.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-47-07.jpg)
---

## Ceph OSDs und Pools einrichten

Jeder Host benötigt geeignete Datenträger als OSDs. Für ein einfaches Testsetup reichen drei OSDs, produktiv sollte Ceph jedoch deutlich sorgfältiger und redundant geplant werden.

Hardware-RAID-Controller sollten auch für Ceph nicht verwendet werden. Ceph benötigt direkten Zugriff auf die Datenträger.

[ ![Ceph OSD in Proxmox VE erstellen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-53-32.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-53-32.jpg)
[ ![Ceph Pool in Proxmox VE anlegen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-54-36.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-54-36.jpg)

Monitor- und Manager-Rollen sollten auf mehrere Nodes verteilt werden. Andernfalls kann bereits ein Reboot eines einzelnen Nodes zu Problemen führen.

---

## Migration zwischen Nodes

Die Migration laufender VMs oder gestoppter LXCs ist sowohl mit ZFS als auch mit Ceph möglich. Der wesentliche Unterschied liegt im Storage-Konzept.

- **Ceph:** Speicher liegt verteilt im Cluster
- **ZFS:** Speicher muss auf dem Zielhost vorhanden sein oder übertragen werden
- **ZFS mit Replikation:** nur die Änderungen müssen ergänzt werden
- **ZFS ohne Replikation:** vollständige Übertragung notwendig

[ ![Proxmox VE Migration einer VM zwischen Nodes](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-56-37.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-56-37.jpg)
[ ![Proxmox Klonen zwischen ZFS und Ceph Storage](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-11-58-52.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-11-58-52.jpg)
---

## QEMU Guest Agent installieren

Der **QEMU Guest Agent** sollte in virtuellen Maschinen immer installiert und aktiviert werden. Er ermöglicht geordnetes Herunterfahren, bessere Backup-Konsistenz, IP-Erkennung und weitere Verwaltungsfunktionen.

[ ![QEMU Guest Agent Installation in Proxmox VM](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-02-01.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-02-01.jpg)
---

## Proxmox Sicherheit: 2FA, SSH und Netzwerksegmentierung

### Zwei-Faktor-Authentifizierung aktivieren

Root- und Proxmox-Benutzer sollten mit Zwei-Faktor-Authentifizierung abgesichert werden.

[ ![Proxmox VE Zwei Faktor Authentifizierung aktivieren](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-11-21.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-11-21.jpg)
[ ![Proxmox VE Benutzer mit 2FA absichern](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-12-09.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-12-09.jpg)
### SSH gegen Passwort-Login absichern

SSH-Zugänge sollten nach Möglichkeit nur mit Schlüsseln und ohne Passwort-Login betrieben werden.

[ ![Proxmox SSH Daemon gegen Passwort Login absichern](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-13-29.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-13-29.jpg)
### Verwaltungsnetz trennen

Wenn die Ressourcen vorhanden sind, sollten Anwender- und Gast-VMs keinen direkten Zugriff auf Proxmox VE, Switches oder Firewalls erhalten.

[ ![Proxmox VE virtuelle Switche zur Trennung von Verwaltungsnetz und VM Netz](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-14-57.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-14-57.jpg)
---

## Replikationen zuverlässig prüfen

Ein Blick auf ZFS allein zeigt nicht zuverlässig, welche VM gerade auf welchem Host aktiv ist. Deshalb müssen Replikationen kontrolliert und nachvollziehbar überwacht werden.

Das Proxmox Dashboard zeigt defekte Platten, RAID-Probleme und Replikationsfehler nicht immer so zentral, wie es für größere Umgebungen wünschenswert wäre. Deshalb sollten Checkmk, CV4PVE oder eigene Prüfwerkzeuge eingesetzt werden.

[ ![Proxmox VE Replikationen pro VM prüfen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-25-56.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-25-56.jpg)

[ ![Proxmox Dashboard ohne zentrale Anzeige aller ZFS Replikationen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-26-11.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-26-11.jpg)
---

## Proxmox Konfiguration sichern

Die Proxmox-Konfiguration liegt in einer Cluster-Datenbank und wird unter `/etc/pve` eingebunden. Unser Postinstaller kann diese Konfiguration regelmäßig nach `/rpool/pveconf` sichern und mit ZFS-Autosnapshots historisieren.

[ ![Proxmox Konfiguration mit Rsync und ZFS Auto Snapshot sichern](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-12-28-52.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-12-28-52.jpg)
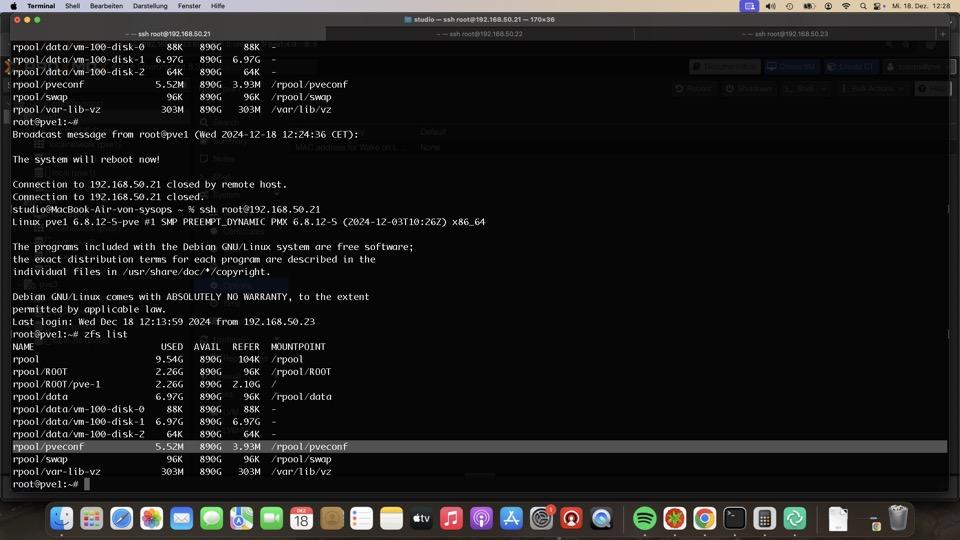
---

## Hochverfügbarkeit mit Proxmox HA

Die Proxmox HA-Engine sorgt dafür, dass VMs oder LXCs beim Ausfall eines Hosts auf einem anderen Host gestartet werden können.

Wichtig ist die Unterscheidung:

- **Ceph oder SAN:** Storage ist gemeinsam verfügbar
- **ZFS-Replikation:** es kann die Replikationslücke verloren gehen
- **HA mit ZFS:** gut für Dienste mit tolerierbarem Datenverlustfenster

Bei ZFS hängt das mögliche Datenverlustfenster vom Replikationsintervall ab. Daher eignet sich HA mit ZFS besonders für Systeme wie Firewalls, Telefonanlagen oder Dienste, bei denen ein kurzer Rückstand vertretbar ist.

[ ![Proxmox HA Gruppe mit Prioritäten konfigurieren](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-13-20-48.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-13-20-48.jpg)
[ ![Proxmox VM einer HA Gruppe zuweisen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-13-21-03.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-13-21-03.jpg)
> Wird ein Node regulär neu gestartet, sollten VMs vorher bewusst migriert werden. Ein Reboot ersetzt keine geplante Wartung.

---

## Snapshots manuell und automatisch nutzen

Manuelle Snapshots über die Proxmox GUI oder API werden abhängig vom darunterliegenden Storage erzeugt – beispielsweise auf ZFS, Ceph oder anderen Storage-Backends.

Bei ZFS werden Snapshot-Zustände mitrepliziert und in der VM-Konfiguration sichtbar.

[ ![Manuellen Snapshot in Proxmox VE erstellen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-13-36-44.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-13-36-44.jpg)
[ ![ZFS Snapshot einer Proxmox VM](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-13-37-17.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-13-37-17.jpg)
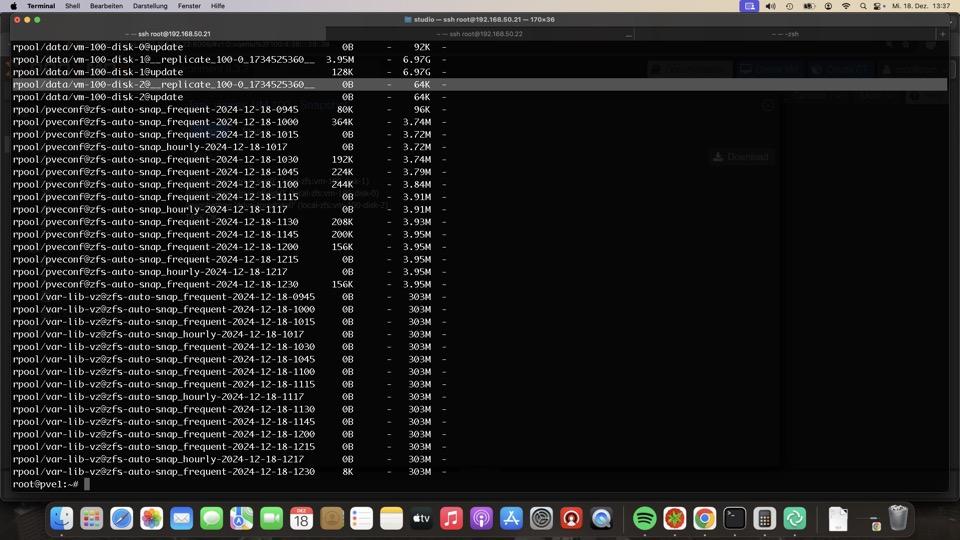
---

## CV4PVE-Admin für Snapshots, Monitoring und Replikationen

CV4PVE-Admin kann eine sinnvolle Ergänzung zu Proxmox VE sein. Es bietet bessere Übersicht über Replikationen, Snapshots und bestimmte Monitoring-Funktionen.

[ ![CV4PVE Admin für Proxmox VE Monitoring und Snapshots](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-13-38-57.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-13-38-57.jpg)
[ ![CV4PVE Admin Übersicht aller Proxmox Replikationen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-13-47-36.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-13-47-36.jpg)
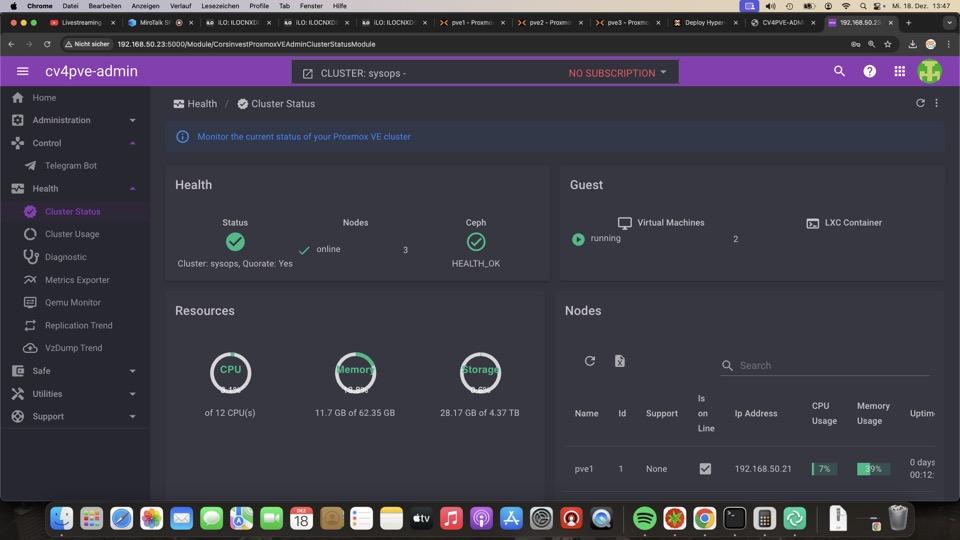
Automatische Snapshots können dort definiert werden. Wichtig ist, dass das System zuverlässig läuft und überwacht wird.

[ ![Automatische Snapshots mit CV4PVE Admin konfigurieren](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-13-51-18.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-13-51-18.jpg)
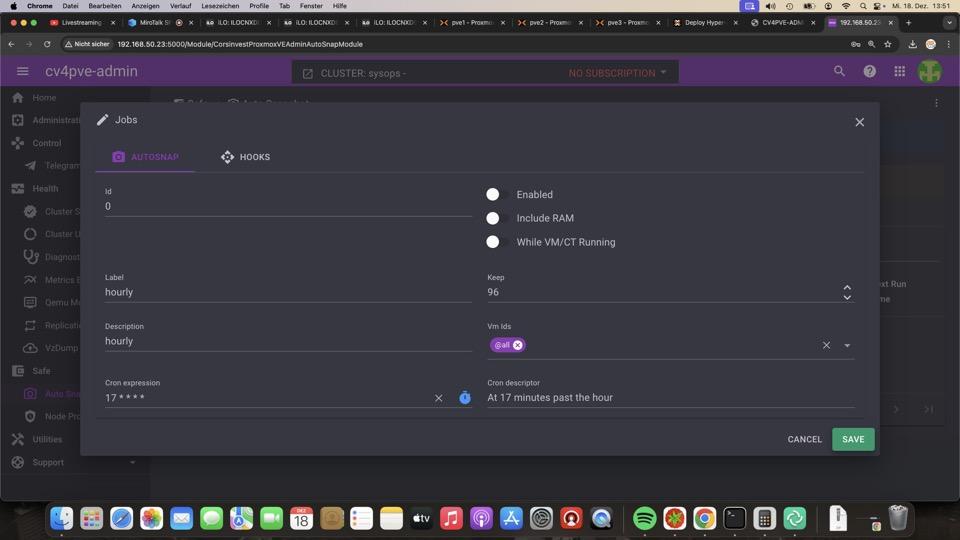
---

## Proxmox Backup Server einrichten

Proxmox VE kann klassische Backups erstellen. Der **Proxmox Backup Server** ergänzt inkrementelle, deduplizierte Backups, zentrale Verwaltung, Verify Jobs, Prune Jobs und Garbage Collection.

PBS kann auf eigener Hardware, in einer VM oder in bestimmten Szenarien auch als LXC betrieben werden. Für produktive Backups ist ein dediziertes, abgesichertes System vorzuziehen.

[ ![Proxmox Backup Server Installation](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-03-19.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-03-19.jpg)
[ ![Proxmox Backup Server Weboberfläche Port 8007](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-09-48.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-09-48.jpg)
Für den Datastore empfehlen sich lokale Dateisysteme oder geeignete Storage-Anbindungen. SMB verursacht in vielen Umgebungen zusätzlichen Overhead und ist für PBS meist nicht die beste Wahl.

---

## Backup-Benutzer, Token und Rechte

Für Backups sollte ein eigener Backup-Benutzer mit Token verwendet werden. Root-Zugänge und Backup-Zugänge sollten mit Zwei-Faktor-Authentifizierung abgesichert werden.

Der Benutzer oder Token benötigt die Berechtigung **Datastore Backup**.

[ ![Proxmox Backup Server Benutzer mit Zwei Faktor Authentifizierung](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-24-09.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-24-09.jpg)
[ ![Proxmox Backup Server API Token für Backup Benutzer erstellen](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-24-45.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-24-45.jpg)
[ ![Proxmox Backup Server Rechte Datastore Backup vergeben](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-25-28.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-25-28.jpg)
---

## Proxmox Backup Server in Proxmox VE einbinden

Für die Einbindung des Proxmox Backup Servers in Proxmox VE werden mehrere Angaben benötigt:

- Name des Datastores in Proxmox VE
- Serveradresse des PBS
- Datastore-Name im PBS
- Benutzer oder Token
- Token Secret
- Fingerprint des PBS-Zertifikats

[ ![Proxmox VE Backup Storage mit Proxmox Backup Server verbinden](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-26-11.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-26-11.jpg)
[ ![Proxmox Backup Storage in allen PVE Nodes verfügbar](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-27-49.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-27-49.jpg)
> Das lokale Bootvolume von Proxmox VE sollte nicht als Backup-Ziel verwendet werden.

---

## Backups, Prune, Garbage Collection und Verify

Das erste Backup einer VM ist in der Regel ein vollständiger Durchlauf. Danach werden mit Dirty Bitmap und Deduplizierung nur noch geänderte Daten effizient übertragen und gespeichert.

Nach einem Stop der VM oder Reboot des Hosts kann wieder ein vollständiger Scan notwendig werden. Durch Chunk-Deduplizierung werden jedoch nur neue oder geänderte Chunks gespeichert.

[ ![Erstes manuelles Backup mit Proxmox Backup Server](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-29-02.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-29-02.jpg)
[ ![Inkrementelles Backup mit Proxmox Backup Server](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-30-40.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-30-40.jpg)
### Prune Jobs

Prune Jobs definieren Aufbewahrungszeiten. Der Proxmox-Simulator hilft bei der Prüfung der Regeln.

[ ![Proxmox Backup Server Prune Job konfigurieren](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-37-41.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-37-41.jpg)
### Garbage Collection

Die Garbage Collection räumt nicht mehr benötigte Chunks auf. Dieser Vorgang kann Last erzeugen und sollte sinnvoll geplant werden.

[ ![Proxmox Backup Server Garbage Collection starten](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-39-20.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-39-20.jpg)
### Verify Jobs

Verify Jobs prüfen regelmäßig die Integrität der Backups. Der Erfolg wird sowohl im PBS als auch in Proxmox VE angezeigt.

[ ![Proxmox Backup Server Verify Job zur Integritätsprüfung](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-41-35.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-41-35.jpg)
---

## Optional: Replikationskontrolle mit checkzfs

Mit **checkzfs** vom Bashclub können ZFS-Replikationen zusätzlich kontrolliert werden. Da nicht immer sofort erkennbar ist, welcher Host welche VM aktiv betreibt, kann ein Vergleich der Datastores hilfreich sein.

Der Check sollte nicht während laufender Replikationen ausgeführt werden, da dies zu Fehlmeldungen führen kann.

[ ![checkzfs Replikationskontrolle für Proxmox ZFS Cluster](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-14-59-16.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-14-59-16.jpg)
[ ![CV4PVE als Alternative zur Replikationskontrolle in Proxmox](https://aow.de/uploads/images/gallery/2024-12/scaled-1680-/bildschirmfoto-2024-12-18-um-15-17-28.jpg) ](https://aow.de/uploads/images/gallery/2024-12/bildschirmfoto-2024-12-18-um-15-17-28.jpg)
---

## Fazit: Proxmox Cluster mit ZFS bewusst planen

Für viele kleine und mittlere Umgebungen ist ein Proxmox-Cluster mit ZFS, Replikation, Proxmox Backup Server und gutem Monitoring eine sehr leistungsfähige und wirtschaftliche Lösung.

Ceph ist besonders interessant, wenn echter verteilter Storage, hohe Skalierung und passende Hardware vorhanden sind. Für kleinere Installationen ist ZFS jedoch häufig einfacher zu verstehen, schneller einzurichten und leichter zuverlässig zu betreiben.

- ZFS für kleine und mittlere Cluster bevorzugt prüfen
- Ceph nur mit passender Hardware und Erfahrung produktiv einsetzen
- Backups nie durch Snapshots ersetzen
- Replikationen regelmäßig kontrollieren
- Monitoring zwingend einplanen
- 2FA und SSH-Hardening aktivieren
- Proxmox Backup Server sauber absichern

---

## Ressourcen

- [Aktueller sysops Prospekt](https://aow.de/books/ubersicht-des-projekts/page/prospekt)
- [aow.de – Linkliste zu allen Projekten](https://aow.de)
- [cloudistboese.de – Schulungsportal für Proxmox, ZFS und Open Source](https://cloudistboese.de)
- [sysops.tv auf YouTube](http://youtube.com/sysopstv)
- [Bashclub Proxmox ZFS Postinstaller auf GitHub](https://github.com/bashclub/proxmox-zfs-postinstall)

---

## Proxmox Schulung oder Beratung anfragen

Sie möchten Proxmox VE mit ZFS, Replikation, Backup und Monitoring professionell einsetzen? Die sysops GmbH unterstützt bei Planung, Installation, Migration, Schulung und Betrieb.

📧 [info@sysops.de](mailto:info@sysops.de?subject=Proxmox%20Cluster%20Beratung)  
📞 +49 (0) 6021 2125-0

Vielen Dank für Ihre Aufmerksamkeit.  
**Christian-Peter Zengel – sysops.tv**

---

## Update: Ceph-Vernetzung mit Proxmox VE 9 und Network Fabrics

Seit **Proxmox VE 9** lässt sich die Ceph-Vernetzung deutlich einfacher abbilden. Mit den neuen **SDN Network Fabrics** können geroutete Underlay-Netzwerke direkt über die Proxmox-Oberfläche erstellt werden.

Damit werden insbesondere **Full-Mesh-Netzwerke für Ceph** übersichtlicher und wartbarer. Proxmox beschreibt selbst, dass Fabrics ab PVE 9 über den SDN-Stack in der GUI erstellt werden können und sich für Full-Mesh-Ceph-Setups eignen. \[oai\_citation:0‡Proxmox VE\](https://pve.proxmox.com/wiki/Full\_Mesh\_Network\_for\_Ceph\_Server?utm\_source=chatgpt.com)

Für neue Ceph-Installationen sollte daher geprüft werden, ob die Vernetzung über **Datacenter → SDN → Fabrics** sinnvoller ist als eine manuelle statische Netzwerkkonfiguration.

# ZFS Grundlagen am Beispiel Proxmox VE(Stand Dezember 2025)

# ZFS Grundlagen mit Proxmox VE – Praxiswissen für sichere Server, Backups und Storage-Systeme

## Erfahrung aus rund 150 produktiven Proxmox- und ZFS-Systemen

Der Verfasser dieser Dokumentation, **Christian-Peter Zengel**, verfügt über rund **18 Jahre Praxiserfahrung mit ZFS und Proxmox** und betreibt aktuell etwa **150 Systeme mit Proxmox VE und ZFS**.

Die hier beschriebenen Erfahrungen stammen aus realen Installationen – von einzelnen Standalone-Servern bis zu Proxmox-Clustern mit bis zu zehn Hosts.

Der Fokus liegt auf **ZFS als robuste, sichere und wirtschaftliche Storage-Grundlage** für kleine und mittlere IT-Umgebungen.

---

## Warum ZFS für Proxmox, TrueNAS und Linux-Server?

ZFS ist eine ideale Grundlage für Systeme, bei denen Datenintegrität, Snapshots, Replikation und schnelle Wiederherstellung entscheidend sind. Gerade bei Proxmox VE, TrueNAS, Backup-Servern und Fileservern bietet ZFS erhebliche Vorteile gegenüber klassischen RAID-Controllern oder einfachen Dateisystemen.

- Hohe Datensicherheit durch Prüfsummen
- Snapshots in Sekunden
- Rollbacks bei Fehlern oder Updates
- Replikation auf andere Systeme
- Schutz vor Bedienfehlern
- Bessere Wiederherstellung nach Ausfällen
- Sehr gute Grundlage gegen Ransomware-Schäden
- Flexible Storage-Konzepte ohne klassischen RAID-Controller

**In der Praxis zeigt sich ZFS für viele kleine und mittlere Systeme einfacher, vielseitiger, schneller und günstiger als Ceph.** Eine produktive Ceph-Expertise wird hier bewusst nicht behauptet; intern wird jedoch intensiv an passenden Hauslösungen gearbeitet.

---

## ZFS Onlinekurs und Schulung

Diese Dokumentation basiert auf einem Onlinekurs von **cloudistboese.de**. Die ZFS-Grundlagenkurse werden regelmäßig angeboten und vermitteln die wichtigsten Konzepte für den sicheren Einsatz von ZFS mit Proxmox VE, TrueNAS und vergleichbaren Systemen.

[ ![ZFS Grundlagen Onlinekurs von cloudistboese.de für Proxmox VE, TrueNAS und Linux Storage](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/cib-zfs.png) ](https://aow.de/uploads/images/gallery/2025-12/cib-zfs.png)
[ **Aktuelle ZFS-Kurse und weitere Open-Source-Schulungen auf cloudistboese.de ansehen** ](https://cloudistboese.de)

Die Wiederholung der Onlinekurse sowie der Zugriff auf Aufzeichnungen sind für Kursteilnehmer kostenlos.

---

## Inhalte des ZFS-Grundlagenkurses

ZFS ist die perfekte Grundlage, um kleine und mittlere Systeme gegen Ausfälle, Fehlbedienung und Verschlüsselungstrojaner besser abzusichern.

Der Kurs vermittelt Grundkenntnisse für den praktischen Einsatz mit:

- Proxmox VE
- TrueNAS
- Linux-Servern
- Backup-Systemen
- Fileservern
- kleinen und mittleren Virtualisierungsumgebungen

### Themen im Überblick

- Grundbegriffe und Überblick über ZFS
- Aufbau von RAID-Konzepten mit `zpool`
- ZFS-Basisfunktionen am Beispiel von Proxmox VE
- Snapshots und Rollbacks
- Replikation in der Praxis
- Prüfung von Replikationen
- Datasets, ZVOLs und Storage-Struktur
- Cache, Logdevice und Special Device
- Typische Fehlentscheidungen vermeiden

**Nach diesem Kurs sind Sie bei Ausfällen, Bedienfehlern und Datenverlust deutlich besser vorbereitet und können viele Systeme innerhalb weniger Minuten wieder produktiv machen.**

---

## ZFS RAID mit zpool erstellen

### So erstellt Proxmox VE einen ZFS Mirror

```bash
zpool create -f -o cachefile=none -o ashift=12 rpool mirror disk1 disk2
```

Die wichtigsten Parameter:

- `-f` erzwingt das destruktive Anlegen des Pools
- `-o cachefile=none` verhindert automatischen Import beim Start
- `ashift=12` ist die übliche Wahl für moderne 4K-Sektoren
- `rpool` ist der Name des Pools
- `mirror` definiert den RAID-Level
- Disks sollten eindeutig über `/dev/disk/by-id` angesprochen werden

Mögliche RAID-Varianten sind unter anderem:

- Stripe
- Mirror
- Striped Mirror / RAID10
- RAIDZ1
- RAIDZ2
- RAIDZ3

---

## Praxisumgebung im Kurs

Im Kurs wird ein älterer Supermicro-Server mit 24 Einschüben sowie zwei NVMe-Datenträgern verwendet. Damit lassen sich verschiedene ZFS-Szenarien realistisch abbilden.

Die Verwendung gebrauchter und teilweise ungetesteter Datenträger zeigt sehr schnell, warum ZFS in der Praxis so wertvoll ist.

**Empfehlung: Für produktive Systeme immer Enterprise-NVMe und ECC-RAM verwenden.**

[ ![Supermicro Server mit vielen Laufwerkseinschüben für ZFS und Proxmox VE Schulung](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/image.png) ](https://aow.de/uploads/images/gallery/2025-12/image.png)
Bereits verwendete Datenträger können in Proxmox VE über die Wipe-Funktion bereinigt werden. Bei alten LVM- oder Ceph-Installationen empfiehlt sich jedoch häufig eine vorherige vollständige Löschung, beispielsweise mit `nwipe`.

[ ![Proxmox VE Wipe Funktion zum Löschen alter Datenträger vor ZFS Nutzung](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/kw2image.png) ](https://aow.de/uploads/images/gallery/2025-12/kw2image.png)
---

## Proxmox VE Bootlayout mit ZFS verstehen

Proxmox VE nutzt bei ZFS-Installationen ein spezielles Bootlayout. Wichtig ist, dass immer ausreichend bootfähige Datenträger mit passendem Partitionslayout vorhanden sind.

Typischerweise gibt es:

- eine kleine Partition für BIOS/GRUB
- eine EFI-Systempartition für `proxmox-boot-tool`
- eine ZFS-Partition für den eigentlichen Pool

Wird später unbedacht mit ganzen Disks gearbeitet, kann es passieren, dass keine geeignete Bootstruktur mehr vorhanden ist.

[ ![Proxmox VE ZFS Bootlayout mit proxmox-boot-tool und Partitionen](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/bildschirmfoto-2025-12-15-um-09-53-30.png) ](https://aow.de/uploads/images/gallery/2025-12/bildschirmfoto-2025-12-15-um-09-53-30.png)
---

## Laufwerke unter Linux eindeutig ermitteln

Vor dem Erstellen eines ZFS-Pools müssen die Laufwerke eindeutig identifiziert werden. Dafür eignen sich unter Linux mehrere Werkzeuge.

```bash
apt install lshw iotop

# Detaillierte Übersicht aller Laufwerke
lshw -class disk

# Liveansicht beim Einschieben von Festplatten
dmesg -Tw

# Eindeutige Laufwerksnamen über by-id anzeigen
ls -althr /dev/disk/by-id
```

### Beispiel: lshw

[ ![Linux lshw Ausgabe zur Ermittlung von Festplatten für ZFS](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/9OVimage.png) ](https://aow.de/uploads/images/gallery/2025-12/9OVimage.png)

### Beispiel: /dev/disk/by-id

[ ![Linux Verzeichnis /dev/disk/by-id mit eindeutigen Festplattennamen für ZFS](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/p8Himage.png) ](https://aow.de/uploads/images/gallery/2025-12/p8Himage.png)

---

## Wichtige Entscheidungen beim Anlegen eines ZFS-Pools

Die wichtigsten Entscheidungen beim Anlegen eines ZFS-Pools sind:

- RAID-Level
- `ashift`
- Kompression
- Volblocksize
- Dataset-Struktur
- Cache- und Log-Konzept

Fehler an dieser Stelle lassen sich später häufig nur mit erheblichem Aufwand korrigieren.

### RAID-Level: Mirror, RAID10 oder RAIDZ?

#### Mirror und Striped Mirror

Mirror und Striped Mirror sind für Proxmox VE meist die unproblematischste Wahl. Sie kosten zwar 50 % der Rohkapazität, bieten aber hohe Performance, einfache Erweiterbarkeit und sehr gute Wiederherstellbarkeit.

- **Vorteile:** schnell, einfach, robust
- **Nachteile:** 50 % Kapazitätsverlust
- **Ideal für:** VMs, LXCs, produktive Proxmox-Hosts

#### RAIDZ1, RAIDZ2 und RAIDZ3

RAIDZ bietet mehr nutzbare Kapazität, ist aber für VMs und LXCs auf drehenden Festplatten nur eingeschränkt geeignet.

- **Vorteile:** mehr nutzbarer Speicherplatz
- **Nachteile:** schlechter für viele kleine synchrone Schreibzugriffe
- **Ideal für:** Fileserver, Archivspeicher, Backup-Ziele

**Virtuelle Maschinen sollten im Normalfall nicht auf drehenden Festplatten mit RAIDZ betrieben werden.** Als Kompromiss kann RAIDZ mit NVMe Cache und Logdevice eingesetzt werden.

---

## Ashift richtig wählen

Bei ZFS bezeichnet `ashift` die interne Sektorgröße eines VDEVs. Früher wurde häufig mit `ashift=9` für 512-Byte-Sektoren gearbeitet. Für heutige Datenträger ist `ashift=12` praktisch immer die richtige Wahl.

**Empfehlung: Aktuell immer `ashift=12` verwenden.**

Eine falsche Einstellung kann zu massiven Leistungseinbußen und erheblicher Platzverschwendung führen.

[ Technischer Hintergrund zu ZFS ashift ](https://aow.de/books/zfs/page/zfs-ashift)

---

## Kompression mit ZFS

ZFS-Kompression kann erheblich Speicherplatz sparen, insbesondere bei Datenbanken, Logs, Textdateien, VM-Images und vielen Serverdaten.

Unsere heutige Empfehlung:

```bash
zfs set compression=on poolname/dataset
```

Früher wurde häufig explizit `compression=lz4` gesetzt. In vielen aktuellen Umgebungen ist `compression=on` sinnvoll und ausreichend.

In der Praxis sparen wir damit häufig ein Drittel oder mehr Speicherplatz – ohne spürbare Geschwindigkeitseinbußen.

---

## ZFS Dataset-Struktur für Proxmox VE

Nach dem Erstellen eines Pools sollte nicht einfach der Pool selbst als Proxmox Storage verwendet werden. Besser ist eine saubere Struktur mit getrennten Datasets.

```bash
zfs create mirror500g/data
zfs create mirror500g/clone
zfs create -o com.sun:auto-snapshot=false mirror500g/repl
```

Danach kann der Storage in Proxmox VE sauber als beispielsweise `mirror500g-data` eingebunden werden.

[ ![Proxmox VE ZFS Storage Dataset Struktur für VMs und Container](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/7mtimage.png) ](https://aow.de/uploads/images/gallery/2025-12/7mtimage.png)
---

## Praxisbeispiele: zpool create

### Stripe / RAID0

Nur für Testsysteme oder Daten ohne Schutz sinnvoll.

```bash
zpool create -f test \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2c \
wwn-0x5000cca01a83a61c
```

### Mirror / RAID1

```bash
zpool create -f test mirror \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2c
```

### Striped Mirror / RAID10

```bash
zpool create -f test \
mirror wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c \
mirror wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 \
mirror wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8
```

### RAIDZ1

```bash
zpool create test raidz \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2c \
wwn-0x5000cca01a83a61c \
wwn-0x5000cca01a832d24 \
wwn-0x5000cca01a83331c \
wwn-0x5000cca01a7495b8
```

### RAIDZ2

```bash
zpool create test raidz2 \
wwn-0x5000cca01a72ded4 \
wwn-0x5000cca01a7b1e2c \
wwn-0x5000cca01a83a61c \
wwn-0x5000cca01a832d24 \
wwn-0x5000cca01a83331c \
wwn-0x5000cca01a7495b8
```

### RAIDZ mit mehreren VDEVs

```bash
zpool create test \
raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c \
raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8
```

### Dry-Run vor dem Anlegen

Vor destruktiven Aktionen immer prüfen:

```bash
zpool create -n test mirror disk1 disk2
```

---

## ZFS Cache, ARC, L2ARC und Logdevice

### ARC – Cache im RAM

Der ARC ist der First-Level-Cache von ZFS und nutzt RAM. Als grobe Praxisregel kann man etwa 1 GB RAM pro 1 TB Netto-Daten ansetzen. Entscheidend ist jedoch immer der konkrete Einsatzzweck.

```bash
arcstat 1
```

[ ![arcstat Ausgabe zur Analyse des ZFS ARC Cache](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-15-59.jpg) ](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-15-59.jpg)
### L2ARC – zusätzlicher Lesecache

Ein L2ARC kann als schneller Lesecache auf SSD oder NVMe eingesetzt werden. Er ist besonders interessant, wenn der Arbeitsspeicher nicht ausreicht und viele wiederkehrende Lesezugriffe auftreten.

```bash
zpool add test cache /dev/disk/by-id/nvme-cache-device
```

### SLOG / Logdevice

Ein Logdevice kann synchrone Schreibzugriffe beschleunigen, muss aber zwingend zuverlässig und im produktiven Einsatz gespiegelt sein.

```bash
zpool add test log mirror /dev/disk/by-id/nvme-log-1 /dev/disk/by-id/nvme-log-2
zfs set sync=always test
```

[ ![ZFS HDD RAID10 mit Cache und gespiegeltem Logdevice](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/zvLimage.png) ](https://aow.de/uploads/images/gallery/2025-12/zvLimage.png)
---

## ZFS Special Device

Ein Special Device kann Metadaten und kleine Blöcke auf schnelle SSDs oder NVMes auslagern. Es muss zwingend redundant, also mindestens gespiegelt, aufgebaut werden.

Sinnvoll wird ein Special Device erst mit einer passenden Definition der Blockgröße, beispielsweise für kleine Blöcke bis etwa 64K.

In unseren Tests zeigte ein Special Device vor allem bei Fileservern und LXC-Workloads Vorteile. Im klassischen VM-Betrieb war der Nutzen deutlich geringer.

[ ![ZFS Special Device als Mirror für Metadaten und kleine Blöcke](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/2oIimage.png) ](https://aow.de/uploads/images/gallery/2025-12/2oIimage.png)
[ ![ZFS Special Small Blocks Konfiguration für Fileserver und LXC](https://aow.de/uploads/images/gallery/2025-12/scaled-1680-/lySimage.png) ](https://aow.de/uploads/images/gallery/2025-12/lySimage.png)

---

## ZFS Pool importieren und entfernen

ZFS-Pools können importiert werden, ohne sie zu löschen. Besonders sinnvoll ist der Import über `/dev/disk/by-id`, damit später im Status eindeutige Laufwerksnamen angezeigt werden.

```bash
zpool import

zpool import poolname

zpool import -d /dev/disk/by-id poolname
```

[ ![ZFS Pool Import über Kommandozeile mit zpool import](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-12-48.jpg) ](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-12-48.jpg)
---

## Datasets und ZVOLs verstehen

### Datasets

Datasets werden wie Dateisysteme gemountet und eignen sich für:

- LXC-Container
- Backupdateien
- Vorlagen
- Serverdateien
- Fileserver-Daten

### ZVOLs

ZVOLs verhalten sich wie virtuelle Blockgeräte. Sie werden unter `/dev/zd...` und mit sprechenden Namen unter `/dev/zvol/poolname/...` bereitgestellt.

Sie eignen sich insbesondere für virtuelle Festplatten von VMs.

[ ![Anlage eines ZFS ZVOL für virtuelle Maschinen unter Proxmox VE](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-27-43.jpg) ](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-27-43.jpg)
[ ![ZFS Datasets und ZVOLs unter Linux und Proxmox VE](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-28-41.jpg) ](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-28-41.jpg)
---

## Thin- und Thick-Provisioning mit ZFS

Proxmox VE erzeugt virtuelle Festplatten auf ZFS typischerweise als ZVOLs. Thin Provisioning spart zunächst Speicherplatz, muss aber sorgfältig überwacht werden.

### Beispiel: Thin Provisioning für eine VM

```bash
zfs create -s -b 16k -V 33554432k rpool/data/vm-301-disk-4
```

### Beispiel: Dataset für LXC

```bash
zfs create -o acltype=posixacl -o xattr=sa -o refquota=33554432k rpool/data/subvol-106-disk-1
```

Bei LXC-Containern ist die Dimensionierung besonders wichtig, da Snapshots und Aufbewahrungszeiten den effektiv nutzbaren Platz beeinflussen.

Virtuelle Diskimages wie QCOW2, VMDK oder RAW-Dateien sollten normalerweise nicht innerhalb eines ZFS-Datasets abgelegt werden, außer bei speziellen NFS- oder iSCSI-Szenarien.

---

## ZFS Pool Features aktualisieren

Wenn `zpool status` neue ZFS-Funktionen meldet, können diese grundsätzlich aktualisiert werden:

```bash
zpool upgrade -a
```

**Wichtig:** Vor einem Upgrade sollte geprüft werden, ob vorhandene Notfall-ISOs, Rettungssysteme und andere Hosts die neuen ZFS-Features bereits unterstützen.

[ ![ZFS zpool status Hinweis auf neue Pool Features](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-59-16.jpg) ](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-59-16.jpg)
[ ![ZFS Pool Feature Upgrade mit zpool upgrade](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-59-26.jpg) ](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-59-26.jpg)
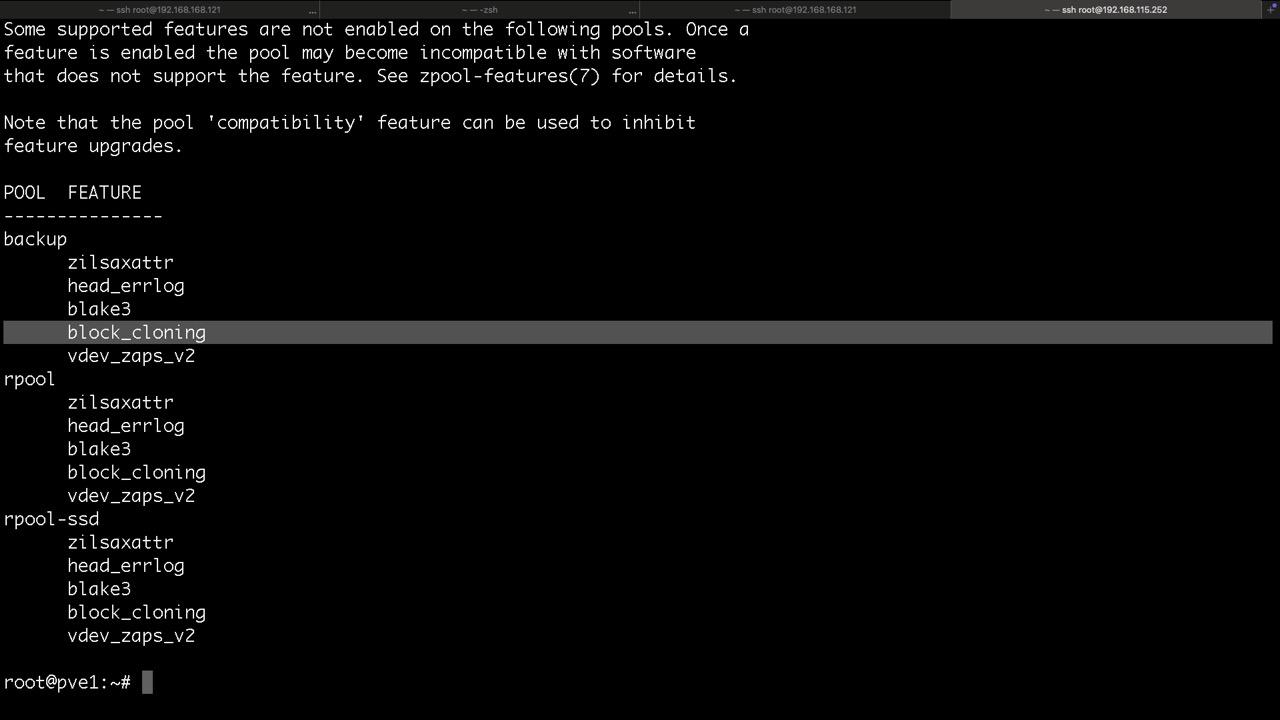
---

## ZFS Parameter auslesen

Für Pools, Datasets, Volumes und Snapshots können Eigenschaften mit `zfs get` ausgelesen werden.

```bash
zfs get all poolname
zfs get compression poolname/dataset
zfs get used,available,referenced poolname/dataset
```

[ ![ZFS get Ausgabe zum Auslesen von Pool und Dataset Eigenschaften](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-00-49.jpg) ](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-00-49.jpg)
---

## Fazit: ZFS als stabile Basis für Proxmox VE

ZFS ist für viele Proxmox-Umgebungen die beste Grundlage, wenn Datensicherheit, Snapshots, Replikation und Wiederherstellbarkeit im Vordergrund stehen.

Für produktive Systeme sind besonders wichtig:

- saubere Planung des RAID-Layouts
- `ashift=12`
- passende Volblocksize
- Kompression aktivieren
- Enterprise-Datenträger verwenden
- ECC-RAM einsetzen
- Snapshots und Replikation regelmäßig prüfen
- Backups und Wiederherstellung testen

Diese Dokumentation wird fortlaufend erweitert.

---

## ZFS Schulung oder Beratung anfragen

Sie möchten ZFS mit Proxmox VE produktiv einsetzen, bestehende Systeme prüfen oder ein sicheres Storage- und Backup-Konzept entwickeln?

Die sysops GmbH unterstützt bei Planung, Migration, Betrieb, Monitoring und Schulung rund um Proxmox VE, ZFS, Backup und Open Source Infrastruktur.

📧 [info@sysops.de](mailto:info@sysops.de?subject=ZFS%20und%20Proxmox%20Beratung)  
📞 +49 (0) 6021 2125-0

# Das Ende von Hetzner DNS Robot und ACME API - Stand Januar 2026

# Hetzner DNS Robot Abschaltung 2026 – wichtige Hinweise zu ACME, OPNsense und Proxmox

## Wichtige Information für Kursteilnehmer und Kunden

Hallo liebe Kursteilnehmer,

zunächst wünschen wir euch ein **frohes neues Jahr** 🎉

Bitte schaut euch ergänzend die Sendung **„Welche unnötigen Arbeiten müssen dieses Jahr erledigt werden?“ – Live vom 05.01.2026** an. Dort besprechen wir die anstehenden Änderungen, typische Stolperfallen und mögliche Lösungswege rund um DNS, Zertifikate und Automatisierungen.

---

## Hetzner stellt den alten DNS Robot Service im Mai 2026 ein

Wir nutzen den **Hetzner Robot DNS Service** seit fast 20 Jahren. Dieser Dienst wird von Hetzner im Mai 2026 eingestellt. Bestehende DNS-Zonen müssen in die neue Verwaltung innerhalb der **Hetzner Console** migriert werden.

Hetzner nennt als Enddatum den **27.05.2026**. Neue DNS-Zonen können in der alten DNS Console bereits nicht mehr angelegt werden. Auch bestehende Automatisierungen müssen rechtzeitig geprüft und angepasst werden.

**Offizielle Statusmeldung von Hetzner:**  
[ Shutdown of DNS Console (dns.hetzner.com) in May 2026 ](https://status.hetzner.com/incident/c2146c42-6dd2-4454-916a-19f07e0e5a44)

**Neue Hetzner Console:**  
[ https://console.hetzner.com/projects ](https://console.hetzner.com/projects)

---

## Warum ist die Umstellung wichtig?

Viele Systeme erzeugen und verlängern TLS-Zertifikate automatisch per **ACME DNS-01 Challenge**. Wird dabei noch die alte Hetzner DNS API verwendet, funktionieren diese Automatisierungen spätestens nach der Abschaltung nicht mehr zuverlässig.

Betroffen sein können unter anderem:

- OPNsense Firewalls
- Proxmox VE Hosts
- Proxmox Backup Server
- Proxmox Mail Gateway
- Reverse Proxies
- Mailserver
- Monitoring-Systeme
- Automatisierte Zertifikatsverlängerungen mit acme.sh oder ähnlichen Tools

**Wichtig:** Prüft frühzeitig, ob eure Systeme noch den alten Hetzner DNS-Service verwenden. Ab Mai 2026 kann eine nicht angepasste Konfiguration dazu führen, dass Zertifikate nicht mehr verlängert werden.

---

## ACME und Zertifikate – aktueller Stand

Die technische Situation unterscheidet sich je nach eingesetztem System und Version. Bitte prüft deshalb jedes System einzeln und verlasst euch nicht darauf, dass eine funktionierende Konfiguration automatisch zukunftssicher ist.

### OPNsense Community Edition

In der **OPNsense Community Edition** funktioniert die Umstellung nach aktuellem Stand mit dem ACME-Plugin **os-acme-client 4.11** und der neuen Hetzner Cloud Console.

Das grundsätzliche Vorgehen:

- DNS-Zone in die neue Hetzner Console migrieren
- Neuen API-Token in der Hetzner Console erstellen
- Neue ACME DNS-Challenge in OPNsense anlegen
- DNS-Service auf die neue Hetzner-Cloud-Variante umstellen
- Zertifikate entsprechend anpassen
- Testausstellung oder Erneuerung durchführen

### OPNsense Business Edition

Bei der **OPNsense Business Edition** ist besondere Vorsicht geboten. Dort kann je nach Release noch eine ältere Version des ACME-Plugins enthalten sein, die die neue Hetzner API noch nicht korrekt unterstützt.

Wenn eure OPNsense Business Edition noch **os-acme-client 4.10** verwendet, sollte die ACME-Funktion vor der Umstellung sorgfältig geprüft werden.

#### Workaround auf eigenes Risiko

Der folgende Workaround funktionierte bei uns im Test. Bitte nur verwenden, wenn ihr wisst, was ihr tut, vorher ein Backup erstellt habt und das Risiko einschätzen könnt.

```
pkg add -f https://pkg.opnsense.org/FreeBSD:14:amd64/25.7/latest/All/acme.sh-3.1.2.pkg
pkg add -f https://pkg.opnsense.org/FreeBSD:14:amd64/25.7/latest/All/os-acme-client-4.11.pkg
```

Nach der Installation sollte die ACME-Konfiguration geprüft, die Challenge neu angelegt und eine Testausstellung durchgeführt werden.

---

## Proxmox VE, Proxmox Backup Server und Proxmox Mail Gateway

Auch bei **Proxmox VE**, **Proxmox Backup Server** und **Proxmox Mail Gateway** müssen ACME-Konfigurationen geprüft werden. Entscheidend ist, ob bereits ein DNS-Plugin für die neue Hetzner Cloud DNS API vorhanden ist oder ob noch die alte Hetzner DNS API genutzt wird.

### Mögliche Lösungswege

- Umstellung auf HTTP-Challenge, sofern technisch möglich
- Umstellung auf die neue Hetzner Cloud DNS API
- Verwendung eines gekauften Zertifikats
- Zentrale Zertifikatserstellung über OPNsense
- Automatisierter Zertifikats-Upload auf PVE oder PBS
- Manuelle oder halbautomatische Zertifikatsverteilung

**Hinweis:** Proxmox VE und Proxmox Backup Server lassen sich in vielen Szenarien über API oder Zertifikatsupload automatisieren. Beim Proxmox Mail Gateway ist die Situation schwieriger, da hierfür keine vergleichbare API für alle notwendigen Schritte zur Verfügung steht.

### PMG: Zwei getrennte Automationen notwendig

Für Proxmox Mail Gateway können zwei getrennte Schritte erforderlich sein:

1. Zertifikat und Schlüssel auf das PMG übertragen
2. Zertifikat für API und SMTP aktivieren

Beispiel für die Aktivierung auf einem Proxmox Mail Gateway:

```
sleep 90
pmgconfig cert set api /root/-.sysopservice.net/fullchain.pem /root/-.sysopservice.net/key.pem --force --restart 1
pmgconfig cert set smtp /root/-.sysopservice.net/fullchain.pem /root/-.sysopservice.net/key.pem --force --restart 1
```

Die Pfade müssen selbstverständlich an die jeweilige Umgebung angepasst werden.

---

## Empfohlene Vorgehensweise

Wir empfehlen, die Umstellung nicht bis Mai 2026 aufzuschieben. Zertifikatsprobleme fallen häufig erst dann auf, wenn eine Erneuerung fehlschlägt und Dienste bereits Warnungen anzeigen oder ausfallen.

- Alle DNS-Zonen in der alten Hetzner DNS Console identifizieren
- Migration in die neue Hetzner Console planen
- Neue API-Tokens erstellen
- OPNsense, Proxmox, PMG, PBS und weitere Systeme prüfen
- ACME-Challenges neu anlegen oder anpassen
- Zertifikatserneuerung aktiv testen
- Monitoring für Zertifikatslaufzeiten kontrollieren
- Dokumentation der neuen Zugangsdaten und Tokens aktualisieren

---

## Support durch die sysops GmbH

Die sysops GmbH unterstützt Kunden, Kursteilnehmer und Partner bei der Umstellung von Hetzner DNS, ACME, OPNsense, Proxmox VE, Proxmox Backup Server und Proxmox Mail Gateway.

Wenn ihr Unterstützung benötigt, meldet euch bitte über unser Ticketsystem.

📧 [ticket@sysops.de](mailto:ticket@sysops.de?subject=Hetzner%20DNS%20Migration%20ACME)

---

## Neue Kurse und Workshops

Der neue Kursplan wird auf unserem Schulungsportal veröffentlicht. Dort findet ihr aktuelle Workshops zu Proxmox, ZFS, OPNsense, Monitoring, Mailservern, Open Source und modernen IT-Infrastrukturen.

[ **Aktuelle Kurse auf cloudistboese.de ansehen** ](https://cloudistboese.de/)

Liebe Grüße  
**Chriz**

# Information zur Sicherung und Wiederherstellung von Windows 10/11-Systemen

### Information zur Sicherung und Wiederherstellung von Windows 10/11-Systemen

Bitte nehmt zur Kenntnis, dass die Sicherung und der Ersatz (z. B. Austausch der Hardware) eines Windows 10- oder Windows 11-PCs inzwischen sehr problematisch sein kann.

#### Hintergrund

Neue Windows 11-Systeme verschlüsseln die Festplatte standardmäßig.  
Der Verschlüsselungsschlüssel ist dabei an die Hardware (Trusted Platform Module, TPM) gebunden.

Das bedeutet:

- Beim Umbau der Festplatte oder bei einer Wiederherstellung auf einem neuen PC (z. B. über URBackup) **kann das System nicht entschlüsselt werden**.
- Diese Basisverschlüsselung ist **ohne die ursprüngliche Hardware nicht aufhebbar** (Stand heute).

---

### Mögliche Vorgehensweisen

#### 1. Kein Bedarf an Verschlüsselung (z. B. PC steht in verschlossenen Räumen)

- **Prüfen**, ob eine Verschlüsselung aktiv ist:
    
    <div class="contain-inline-size rounded-2xl relative bg-token-sidebar-surface-primary"><div class="sticky top-9"><div class="absolute end-0 bottom-0 flex h-9 items-center pe-2"><div class="bg-token-bg-elevated-secondary text-token-text-secondary flex items-center gap-4 rounded-sm px-2 font-sans text-xs">  
    </div></div></div><div class="overflow-y-auto p-4" dir="ltr">`manage-bde -<span class="hljs-built_in">status</span>`</div></div>
- **Deaktivieren** der Verschlüsselung:
    
    <div class="contain-inline-size rounded-2xl relative bg-token-sidebar-surface-primary"><div class="sticky top-9"><div class="absolute end-0 bottom-0 flex h-9 items-center pe-2"><div class="bg-token-bg-elevated-secondary text-token-text-secondary flex items-center gap-4 rounded-sm px-2 font-sans text-xs">  
    </div></div></div><div class="overflow-y-auto p-4" dir="ltr">`manage-bde -<span class="hljs-keyword">off</span> C:`</div></div>
- **Alternative:** Falls Verschlüsselung gewünscht ist → BitLocker über *Einstellungen → System → Speicher → BitLocker* aktivieren und den Wiederherstellungsschlüssel **sicher aufbewahren**.

---

#### 2. Bedarf an Verschlüsselung (z. B. bei mobilen Geräten)

- **Prüfung** wie oben:
    
    <div class="contain-inline-size rounded-2xl relative bg-token-sidebar-surface-primary"><div class="sticky top-9"><div class="absolute end-0 bottom-0 flex h-9 items-center pe-2"><div class="bg-token-bg-elevated-secondary text-token-text-secondary flex items-center gap-4 rounded-sm px-2 font-sans text-xs">  
    </div></div></div><div class="overflow-y-auto p-4" dir="ltr">`manage-bde -<span class="hljs-built_in">status</span>`</div></div>
- Diese Verschlüsselung ist **an die jeweilige Hardware gebunden**.
- **Empfehlung:** BitLocker aktivieren und den Wiederherstellungsschlüssel **unbedingt sichern**.  
    → Nur mit diesem Schlüssel ist eine vollständige Wiederherstellung möglich.

---

### 3. Zentrale Sicherung der BitLocker-Schlüssel über Gruppenrichtlinie (GPO)

In einer Active-Directory-Umgebung können BitLocker-Wiederherstellungsschlüssel **automatisch im AD gespeichert** werden.  
Dies ermöglicht eine zentrale Verwaltung und Wiederherstellung der Schlüssel, auch wenn ein Benutzer den lokalen Key verliert.

**Einrichtung (Kurzfassung):**

1. GPO öffnen →  
    `Computerkonfiguration → Administrative Vorlagen → Windows-Komponenten → BitLocker-Laufwerkverschlüsselung`
2. Unter *Betriebssystemlaufwerke* Richtlinie aktivieren:  
    **„Wiederherstellungsinformationen in Active Directory Domain Services speichern“**
3. Optional: Speicherung erzwingen, bevor Verschlüsselung beginnt.
4. Anwendung prüfen mit `gpupdate /force`.

**Hinweis:** In Azure AD-Umgebungen werden die Schlüssel standardmäßig im Benutzerkonto im Azure-Portal hinterlegt.

---

### Hinweise zur Datensicherung

- **Plattensicherung (Image-Backup):** Wiederherstellung nur mit vorhandenem Schlüssel möglich.
- **Dateisicherung:** z. B. mit URBackup oder ähnlichen Tools.
- **Proxmox Backup Server:** Rücksicherung ist nur komplett möglich, da einzelne Dateien aus verschlüsselten Systemen nicht direkt extrahiert werden können.

<div id="bkmrk-hier-der-technische-"><div>  
</div><div>**Hier der technische Nachweis**</div></div><div id="bkmrk--4">  
</div><div id="bkmrk-zugriff-auf-die-fris">Zugriff auf die frisch mit Windows 11 24H2 installierte Festplatte.</div><div id="bkmrk--5">  
</div><div id="bkmrk-root%40pve250%3A%7E%23-mount">root@PVE250:~# mount /dev/zvol/rpool/data/vm-101-disk-1-part3 /mnt/restore/</div><div id="bkmrk-mount%3A-%2Fmnt%2Frestore%3A">**mount: /mnt/restore: unknown filesystem type ‚BitLocker‘.**</div><div id="bkmrk--6"></div>[![image.png](https://aow.de/uploads/images/gallery/2025-10/scaled-1680-/image.png)](https://aow.de/uploads/images/gallery/2025-10/image.png)

[![image.png](https://aow.de/uploads/images/gallery/2025-10/scaled-1680-/NV8image.png)](https://aow.de/uploads/images/gallery/2025-10/NV8image.png)
# Stand der Technik nach DSGVO am Beispiel Kopano - Was sagt ChatGPT?

> Auf Nachfrage interessierte mich die Meinung von ChatGPT zum Thema Übergangsfristen für abgelaufene Software, wie z. B. Kopano u. Ä. Nicht immer schafft man rechtzeitig die Migration auf aktuelle Systeme, meist wegen der Absprachen und Termin- und Kostengespräche mit Kunden

Nach der Datenschutz-Grundverordnung (DSGVO) gibt es **keine ausdrücklichen Übergangsfristen** für die Pflicht, Serversoftware auf dem *Stand der Technik* zu halten. Die Verordnung trat am 25. Mai 2018 in Kraft und gilt seither unmittelbar in allen EU-Mitgliedstaaten.

### Was bedeutet "Stand der Technik" laut DSGVO?

Die DSGVO verlangt in **Art. 32 Abs. 1** von Verantwortlichen und Auftragsverarbeitern geeignete technische und organisatorische Maßnahmen, um ein dem Risiko angemessenes Schutzniveau zu gewährleisten. Dabei ist **„der Stand der Technik“** ein zentrales Kriterium.

Das bedeutet konkret:

- Sicherheitslücken in Server- oder Anwendungssoftware **müssen zeitnah** geschlossen werden.
- Der Einsatz **nicht mehr unterstützter oder veralteter Software** (z. B. alte PHP-Versionen, Windows 7, EOL-Linux-Distributionen) ist **nicht zulässig**, wenn dadurch Sicherheitsrisiken entstehen.

### Gibt es trotzdem Spielräume oder Fristen?

Zwar gibt es **keine festen Fristen in der DSGVO**, aber:

- In der Praxis **kann** bei Updates oder Umstellungen ein **kurzer Zeitraum** zur Umsetzung toleriert werden – **solange ein Risikoanalyse- und Migrationsplan dokumentiert ist**.
- Bei Audits oder Vorfällen ist entscheidend, ob du als Verantwortlicher:
    
    
    - Risiken erkannt hast,
    - Maßnahmen geplant und priorisiert hast,
    - dokumentieren kannst, warum du etwas wie schnell umgesetzt hast.

### Beispiele:

<div class="_tableContainer_80l1q_1" id="bkmrk-software-stand-der-t"><div class="_tableWrapper_80l1q_14 group flex w-fit flex-col-reverse" tabindex="-1"><table class="w-fit min-w-(--thread-content-width)"><thead><tr><th>Software</th><th>Stand der Technik?</th><th>Kommentar</th></tr></thead><tbody><tr><td>Ubuntu 20.04</td><td>Ja (bis 2025)</td><td>Unterstützt, wenn regelmäßig aktualisiert</td></tr><tr><td>Windows Server 2012 R2</td><td>Nein (EOL)</td><td>Nicht mehr sicher, nicht DSGVO-konform</td></tr><tr><td>Apache 2.2</td><td>Nein</td><td>Veraltet, seit Jahren nicht mehr unterstützt</td></tr><tr><td>Nextcloud (aktuelle LTS-Version)</td><td>Ja</td><td>Regelmäßige Updates, DSGVO-konform</td></tr></tbody></table>

<div class="sticky end-(--thread-content-margin) h-0 self-end select-none"><div class="absolute end-0 flex items-end"><span></span></div></div></div></div>### Fazit:

- **Keine Übergangsfristen** – aber Planung und dokumentierte Risikobewertung sind wichtig.
- Veraltete Software = hohes Bußgeldrisiko bei Datenschutzverstößen.
- IT-Sicherheitsrichtlinien (z. B. vom BSI oder ISO 27001) helfen bei der Definition des „Stands der Technik“.

Wenn du willst, kann ich dir eine Checkliste zur DSGVO-konformen Server-Softwarepflege erstellen.

> Das Problem mit **Kopano Groupware unter Univention Corporate Server (UCS) 5.0** liegt **mittelfristig vor allem beim Thema "Stand der Technik"** im Sinne der DSGVO – insbesondere in Bezug auf:

---

### 🔧 1. **Veraltete Softwarebasis von Kopano**

- **Kopano Core** (insbesondere `kopano-server`, `kopano-webapp`, `kopano-spooler` usw.) wird **seit längerer Zeit kaum weiterentwickelt**.
- Sicherheits- und Bugfix-Updates erscheinen **selten oder gar nicht mehr regelmäßig**.
- Einige Komponenten (z. B. `kopano-webmeetings`, `kopano-dagent`, `kopano-z-push`) sind teilweise **nicht mehr kompatibel mit aktuellen PHP-Versionen**, was ein Sicherheitsrisiko darstellt.

➡️ **Risiko**: Wenn Sicherheitslücken bekannt werden und keine Updates folgen, ist der „Stand der Technik“ **nicht mehr gegeben**.

---

### 📦 2. **Eingeschränkte oder fehlende Wartung im UCS App Center**

- Kopano war lange im UCS App Center verfügbar, wurde aber teilweise **nicht mehr aktiv gepflegt**.
- Mit der Umstellung auf UCS 5.0 wurden viele Altpakete nicht migriert oder sind nur mit manuellem Aufwand nutzbar.
- **Kopano4UCS**, ein Community-Projekt, hat zwar Lösungen bereitgestellt, diese gelten **nicht als offizieller Supportpfad**.

➡️ **Risiko**: Kein garantierter Support, keine klare Roadmap, und Integration in UCS nur noch teilweise gepflegt.

---

### 🔒 3. **Unklare Sicherheitsgarantie &amp; Datenschutzfolgeabschätzung**

- Nach DSGVO musst du jederzeit **nachweisen können**, dass deine Systeme sicher sind.
- Bei Kopano ist eine fundierte **Datenschutzfolgeabschätzung (DSFA)** kaum möglich, wenn:
    
    
    - keine Sicherheitsupdates veröffentlicht werden,
    - unklar ist, wie Daten verschlüsselt übertragen oder gespeichert werden,
    - keine aktuellen Dokumentationen verfügbar sind.

➡️ **Risiko**: Du trägst die volle Haftung bei Datenpannen – auch wenn die Ursache eine nicht gewartete Drittsoftware ist.

---

### 📆 4. **Abhängigkeit von veralteten Komponenten**

- PHP, MariaDB/MySQL, Apache-Versionen, auf die Kopano setzt, sind oft nicht mehr im Mainstream-Support.
- Anpassungen an moderne Umgebungen (z. B. systemd, PHP 8.2+, OpenLDAP unter UCS 5.0) erfolgen **nicht zuverlässig**.

➡️ **Risiko**: Du bleibst auf alten Softwareständen – was DSGVO-widrig ist.

---

### ✅ Fazit: Wo ist mittelfristig das Problem?

<div class="_tableContainer_80l1q_1" id="bkmrk-bereich-risiko-dsgvo"><div class="_tableWrapper_80l1q_14 group flex w-fit flex-col-reverse" tabindex="-1"><table class="w-fit min-w-(--thread-content-width)"><thead><tr><th>Bereich</th><th>Risiko</th><th>DSGVO-Auswirkung</th></tr></thead><tbody><tr><td>Sicherheitspatches fehlen</td><td>Hoch</td><td>Kein „Stand der Technik“</td></tr><tr><td>Keine Updates über App Center</td><td>Mittel</td><td>Wartung erschwert</td></tr><tr><td>Keine klare Produkt-Roadmap</td><td>Hoch</td><td>Planbarkeit &amp; DSFA unmöglich</td></tr><tr><td>Technische Abhängigkeiten</td><td>Mittel bis hoch</td><td>Zunehmende Inkompatibilität</td></tr></tbody></table>

<div class="sticky end-(--thread-content-margin) h-0 self-end select-none"><div class="absolute end-0 flex items-end"><span></span></div></div></div></div>---

### 🔄 Empfehlung

Wenn du Kopano (noch) nutzt:

- Erstelle eine **Risikoanalyse** und dokumentiere die Abhängigkeit.
- Plane **mittelfristig die Migration** (z. B. auf Open-Xchange, EGroupware, Nextcloud Groupware + Mailcow).
- Prüfe Alternativen mit aktivem Hersteller-Support und Sicherheitszertifizierungen.

Wenn du möchtest, kann ich dir eine **Migrations-Checkliste** oder Alternativen zu Kopano unter UCS zusammenstellen.

# Virtuelle Maschine mit Windows 10 Bios auf Proxmox zu Windows 11 mit UEFI umstellen

#### Windows 11 Migration Bios zu UEFI

> Win11 Upgrade BIOS -&gt; UEFI ist keine einfache Aufgabe  
> Auch wenn es Workarounds gibt, möchten wir für virtuelle Windows 11 Maschinen die maximale Lebensspanne an Upgrades. Daher passen wir das System im Bereich Partitionstabelle, TPM und virtuelle Hardware an

# Systemplatte erweitern

In Proxmox großzügig die Platte, wenn Thin Provisioning aktiviert ist, erweitern.

Danach die Partition in Windows vergrößern, da wir am Ende Platz für eine EFI Partition benötigen!

# BCD neu schreiben

```
bcdboot c:\windows /s c: /f all
```

# Win Part als aktiv markieren

```
diskpart
select disk 0
select part 2
active
```

# Disk zu GPT konvertieren

```
mbr2gpt.exe /convert /allowFullOS /disk:0
```

# VM Shutdown und neu konfigurieren

[![image.png](https://aow.de/uploads/images/gallery/2025-06/scaled-1680-/image.png)](https://aow.de/uploads/images/gallery/2025-06/image.png)

<div id="bkmrk-bios-ovm-%28uefi%29-%23-be">- BIOS OVM (UEFI) # Bei VM Start mit ESC in die Einstellungen gehen und Secure Boot deaktivieren!
- TPM 2.0 State hinzufügen
- EFI Disk hinzufügen
- Optional vorm ersten Boot alle Disks mit detach entfernen und mit IDE wieder hinzufügen, danach Bootreihenfolge nicht vergessen
- Optional und empfohlen: virtio-iso mounten für aktuelle Treiber CD

</div># VM einschalten

<div id="bkmrk-bei-vm-start-mit-esc">- Bei VM Start mit ESC in die Einstellungen gehen und Secure Boot deaktivieren!
- Wenn Inaccessible Boot Device, dann booten mit F8 unsignierten Treibern aktivieren

</div># Shutdown

<div id="bkmrk-disks-wieder-auf-scs">- Disks wieder auf SCSI stellen, wie oben beschrieben

</div># VM Starten

<div id="bkmrk-windows-11-iso-einle">- Windows 11 ISO einlegen
- Windows 11 Upgrade starten

</div>

# ZFS Grundlagen am Beispiel Proxmox VE(Stand Januar 2025)

Der Verfasser des Artikels, Christian-Peter Zengel, hat zum Zeitpunkt des Artikels ca **15 Jahre Erfahrung mit ZFS und Proxmox. Er betreibt aktuell ca 150 Systeme mit Proxmox und ZFS**

Das Einsatzgebiet geht von Standaloneinstallation bis zu ca 10 Hosts im Cluster. **Es ist keine Ceph Expertise vorhanden!**

> Dieser Dokumentation basiert auf diesem online Kurse von cloudistboese.de
> 
> #### [21. + 23.01.2025 (13.00 Uhr bis 17.00 Uhr) - ZFS Grundlagen](https://cloudistboese.de/course/view.php?id=79)

**ZFS ist die perfekte Grundlage für kleine und mittlere Systeme um gegen Ausfälle, Dummheit anderer und Erpressungstrojanern ideal aufgestellt zu sein. In diesem Kurs erhalten sie Grundkenntnisse für Systeme wie Proxmox, TrueNAS oder ähnliche Systeme.**

**Der Fokus liegt auf der Technologie und der permanenten Sicherheit im Umgang mit Daten, Linux und dem Terminal.**   
**Themen:**

- Begrifflichkeiten und Überblick
- Basisfunktionen von Proxmox und TrueNAS per GUI
- Erklärung und Beispiele Snapshots und Rollbacks
- Praxisbeispiele Replikation
- Prüfung der Replikationen
- Weitere Features die das Leben massiv erleichtern

Nach diesem Kurs bist Du bei Ausfällen und Datenverlust vor dem Schlimmsten geschützt und in Minuten wieder produktiv!

> [https://de.wikipedia.org/wiki/ZFS\_(Dateisystem)](https://de.wikipedia.org/wiki/ZFS_(Dateisystem))
> 
> [https://www.proxmox.com/de/](https://www.proxmox.com/de/)
> 
> [https://cloudistboese.de](https://cloudistboese.de)

#### So erstellt Proxmox VE seinen ZFS Raid

> zpool create -f -o cachefile=none -o ashift=12 rpool mirror disk1 disk2
> 
> Destruktives Anlegen (-f), kein automatisches Importieren beim Start (-o cachefile=none)  
> -o ashift=12 ist für 4k Festplatten, ashit=9 für 512e Disks, wobei man mit 12 nichts verkehrt macht  
> rpool ist der Name vom künftigen Pool, mirror der Raidlevel und die Disks wurden zweifelsfrei über Ihre ID definiert
> 
> Optionen für Raidlevel wären noch: ohne als Stripe, raidz, raidz2 oder raidz3, also Raid Level 5-7

 [![Bildschirmfoto 2025-01-21 um 13.41.23.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-13-41-23.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-13-41-23.jpg)
> Die ersten Zpool Manöver und die endlose Aktionsliste sieht man mit
> 
> zpool history

[![Bildschirmfoto 2025-01-21 um 13.44.20.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-13-44-20.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-13-44-20.jpg)
> Manuelles Trimmen der SSDs um gelöscht Blöcke schner überschreiben zu können findet man unter /etc/cron.d  
> Ebenso wird nach diesem Zeitplan der sog. **zpool scrub** durchgeführt, der die Konsistenz der Redundanz prüft und ggf. korrigiert. Gefundene Fehler findet man dann mit **zpool status**

[![Bildschirmfoto 2025-01-21 um 13.47.45.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-13-47-45.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-13-47-45.jpg)
> Zum identifizieren der Platten bieten sich neben der PVE GUI noch folgende Befehle an. Es wird dringend empfohlen bereits genutzte Platten via PVE GUI zu wipen
> 
> <p class="callout success">dmesg -Tw (live)  
> lsblk  
> ls -althr /dev/disk/by-id</p>

[![Bildschirmfoto 2025-01-21 um 13.50.01.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/Omgbildschirmfoto-2025-01-21-um-13-50-01.jpg)](https://aow.de/uploads/images/gallery/2025-01/Omgbildschirmfoto-2025-01-21-um-13-50-01.jpg)

#### Erstellen verschiedener Raidlevel und Ihrer Vorzüge

> Mit ls -althr /dev/disk/by-id haben wir folgende Festplatten anhand ihrer aufgedruckten WWN Kennung identifiziert. Es ist dringend empfohlen bei HBAs sich die Slots und die Seriennummern beim Einbau zu notieren und in die Dokumentation aufzunehmen

<p class="callout success">wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 wwn-0x5000cca01a8417fc </p>

##### Stripe, also Raid0

<p class="callout info">zpool create -f test wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8  
</p>

<div id="bkmrk-test-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0" style="text-align:justify;"><div>test ONLINE</div><div> wwn-0x5000cca01a72ded4 ONLINE</div><div> wwn-0x5000cca01a7b1e2c ONLINE</div><div> wwn-0x5000cca01a83a61c ONLINE</div><div> wwn-0x5000cca01a832d24 ONLINE</div><div> wwn-0x5000cca01a83331c ONLINE</div><div> wwn-0x5000cca01a7495b8 ONLINE</div><div> wwn-0x5000cca01a8417fc ONLINE</div></div>##### Mirror, also Raid1

<p class="callout info">zpool create -f test mirror wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c</p>

<div id="bkmrk-test">test</div><div id="bkmrk-%C2%A0mirror"> mirror</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7"> wwn-0x5000cca01a72ded4</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-1"> wwn-0x5000cca01a7b1e2c</div>##### Striped Mirror, also Raid10

<p class="callout info">zpool create -f test mirror wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c mirror wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 mirror wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8</p>

<div id="bkmrk-test-%C2%A0mirror-%C2%A0-%C2%A0wwn-"><div>test</div><div> mirror</div><div> wwn-0x5000cca01a72ded4</div><div> wwn-0x5000cca01a7b1e2c</div><div> mirror</div><div> wwn-0x5000cca01a83a61c</div><div> wwn-0x5000cca01a832d24</div><div> mirror</div><div> wwn-0x5000cca01a83331c</div><div> wwn-0x5000cca01a7495b8</div></div>##### RaidZ, also Raid 5, Nettoplatz x-1

<p class="callout info">zpool create test raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 wwn-0x5000cca01a8417fc   
</p>

<div id="bkmrk-test-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-1"><div>test ONLINE 0 0 0</div><div> raidz1-0 ONLINE 0 0 0</div><div> wwn-0x5000cca01a72ded4 ONLINE 0 0 0</div><div> wwn-0x5000cca01a7b1e2c ONLINE 0 0 0</div><div> wwn-0x5000cca01a83a61c ONLINE 0 0 0</div><div> wwn-0x5000cca01a832d24 ONLINE 0 0 0</div><div> wwn-0x5000cca01a83331c ONLINE 0 0 0</div><div> wwn-0x5000cca01a7495b8 ONLINE 0 0 0</div><div> wwn-0x5000cca01a8417fc ONLINE 0 0 0</div></div><div id="bkmrk--3"></div>##### RaidZ2, also Raid 6, Nettoplatz x-2

<p class="callout info">zpool create test raidz2 wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 wwn-0x5000cca01a8417fc   
</p>

<div id="bkmrk-%C2%A0raidz2-0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-"><div><div> raidz2-0 ONLINE 0 0 0</div><div> wwn-0x5000cca01a72ded4 ONLINE 0 0 0</div><div> wwn-0x5000cca01a7b1e2c ONLINE 0 0 0</div><div> wwn-0x5000cca01a83a61c ONLINE 0 0 0</div><div> wwn-0x5000cca01a832d24 ONLINE 0 0 0</div><div> wwn-0x5000cca01a83331c ONLINE 0 0 0</div><div> wwn-0x5000cca01a7495b8 ONLINE 0 0 0</div><div> wwn-0x5000cca01a8417fc ONLINE 0 0 0</div><div>  
</div></div></div>##### RaidZ-0, also Raid 5-0, Nettoplatz x-2, in diesem Beispiel

<p class="callout info">zpool create test raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8   
</p>

<div id="bkmrk-%C2%A0-test-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0"><div><div>test ONLINE 0 0 0</div><div> raidz1-0 ONLINE 0 0 0</div><div> wwn-0x5000cca01a72ded4 ONLINE 0 0 0</div><div> wwn-0x5000cca01a7b1e2c ONLINE 0 0 0</div><div> wwn-0x5000cca01a83a61c ONLINE 0 0 0</div><div> raidz1-1 ONLINE 0 0 0</div><div> wwn-0x5000cca01a832d24 ONLINE 0 0 0</div><div> wwn-0x5000cca01a83331c ONLINE 0 0 0</div><div> wwn-0x5000cca01a7495b8 ONLINE 0 0 0</div><div> wwn-0x5000cca01a8417fc ONLINE 0 0 0</div></div></div><div id="bkmrk--4">  
</div>> oder mit Spare, wenn Du davon nicht booten musst

<p class="callout info">zpool create test raidz wwn-0x5000cca01a72ded4 wwn-0x5000cca01a7b1e2c wwn-0x5000cca01a83a61c raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8 **spare** wwn-0x5000cca01a8417fc</p>

#### Erweiterung eines RaidZ zum RaidZ-0

<div id="bkmrk-test-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-2">test ONLINE 0 0 0</div><div id="bkmrk-%C2%A0raidz1-0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-%C2%A0-"> raidz1-0 ONLINE 0 0 0</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-2"> wwn-0x5000cca01a72ded4 ONLINE 0 0 0</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-3"> wwn-0x5000cca01a7b1e2c ONLINE 0 0 0</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8"> wwn-0x5000cca01a83a61c ONLINE 0 0 0</div><div id="bkmrk--5"></div><p class="callout info">zpool add -n test raidz wwn-0x5000cca01a832d24 wwn-0x5000cca01a83331c wwn-0x5000cca01a7495b8  
</p>

<div id="bkmrk-test-1">test</div><div id="bkmrk-%C2%A0raidz1-0"> raidz1-0</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-4"> wwn-0x5000cca01a72ded4</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-5"> wwn-0x5000cca01a7b1e2c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-1"> wwn-0x5000cca01a83a61c</div><div id="bkmrk-%C2%A0raidz1"> raidz1</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-2"> wwn-0x5000cca01a832d24</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-3"> wwn-0x5000cca01a83331c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-6"> wwn-0x5000cca01a7495b8</div><div id="bkmrk--6"></div>#### Erweiterung eines Raid durch Ersetzen mit größeren Platten

> Die Platten müssen die Gleiche Geometrie hanben, also 4k zu 4k oder 512e zu 512e
> 
> Bei Raid 1 und 10 reicht es zwei Disks zu tauschen, bei RaidZx müssen alle Disks getauscht werden
> 
> Replace Vorgänge können auch laufen ohne die Redundanz zu brechen, wenn weitere Slots frei sind
> 
> Bei Erweiterung durch Austausch von großen und vor allem älteren Raid 10 prüfen ob in einem Mirror ggf. neue Platten getauscht wurden, diese sollten weiter im Betrieb bleiben, während ältere Paare getauscht werden können

<div id="bkmrk-rpool-hdd">rpool-hdd</div><div id="bkmrk-%C2%A0mirror-0"> mirror-0</div><div id="bkmrk-%C2%A0-2024-8t-%28vorher-di"> **2024-8T (vorher Disk aus 2014)**</div><div id="bkmrk-%C2%A0-2024-8t-%28vorher-di-1"> **2024-8T (vorher Disk aus 2014)**</div><div id="bkmrk-%C2%A0mirror-1"> mirror-1</div><div id="bkmrk-%C2%A0-2014-2t"> 2014-2T</div><div id="bkmrk-%C2%A0-2021-2t"> 2021-2T</div><div id="bkmrk-%C2%A0mirror-2"> mirror-2</div><div id="bkmrk-%C2%A0-2022-2t"> 2022-2T</div><div id="bkmrk-%C2%A0-2014-2t-1"> 2014-2T</div><div id="bkmrk--7"></div>#### Caches und Logdevices

> Vorsichtig formuloiert, Lese- und Schreibcache
> 
> First Level Cache, sog. ARC kommt aus dem RAM und bekommt idealerweise ca. 1GB für 1TB Nettodaten
> 
> Second Level Cache wird als Cachedevice als Partition auf einer schnelleren Disk als der Pool hat bereitgestellt, z. B. am idealsten mit NVMe

<p class="callout info">zpool add test -n cache sdl  
</p>

<div id="bkmrk-test-2">test</div><div id="bkmrk-%C2%A0raidz2-0"> raidz2-0</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-7"> wwn-0x5000cca01a72ded4</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-8"> wwn-0x5000cca01a7b1e2c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-4"> wwn-0x5000cca01a83a61c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-5"> wwn-0x5000cca01a832d24</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-6"> wwn-0x5000cca01a83331c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-9"> wwn-0x5000cca01a7495b8</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-7"> wwn-0x5000cca01a8417fc</div><div id="bkmrk-cache">**cache**</div><div id="bkmrk-%C2%A0sdl"> **sdl**</div><div id="bkmrk--8"></div>> <div>Logdevice (Writecache muss gespiegelt werden)  
> </div><div>Damit der Log auch genutzt wird muss man noch mit zfs set sync den cache aktivieren</div>

<div id="bkmrk--9"></div><p class="callout info">zpool add test -n log mirror sdl </p>

<p class="callout info">zfs set sync=always test</p>

<div id="bkmrk-test-3">test</div><div id="bkmrk-%C2%A0raidz2-0-1"> raidz2-0</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-10"> wwn-0x5000cca01a72ded4</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-11"> wwn-0x5000cca01a7b1e2c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-8"> wwn-0x5000cca01a83a61c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-9"> wwn-0x5000cca01a832d24</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-10"> wwn-0x5000cca01a83331c</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a7-12"> wwn-0x5000cca01a7495b8</div><div id="bkmrk-%C2%A0-%C2%A0wwn-0x5000cca01a8-11"> wwn-0x5000cca01a8417fc</div><div id="bkmrk-logs">**logs**</div><div id="bkmrk-%C2%A0mirror-3"> **mirror**</div><div id="bkmrk-%C2%A0-%C2%A0sdl"> **sdl**</div><div id="bkmrk-%C2%A0-%C2%A0sdk"> **sdk**</div><div id="bkmrk--10"></div>> <div>**Arc wird mit "arcstat 1" ausgelesen, er wird bei der Installation festgelegt oder später unter /etc/modprobe.d/zfs.conf geändert. update-initramfs -u macht das dann persistent und aktiviert die Änderungen beim nächsten reboot.** </div><div>**Zur Laufzeit ändert man den Firstlevelcahce mit** </div><div>**Cache- und Logdevices mit zpool iostat 1**</div>

<p class="callout info">echo 2147483648 &gt; /sys/module/zfs/parameters/zfs\_arc\_max  
echo 1073741824 &gt; /sys/module/zfs/parameters/zfs\_arc\_min  
free -h &amp;&amp; sync &amp;&amp; echo 3 &gt; /proc/sys/vm/drop\_caches &amp;&amp; free -h</p>

<p class="callout info">arcstat 1</p>

[![Bildschirmfoto 2025-01-21 um 15.15.59.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-15-59.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-15-59.jpg)

#### Test der Leistung eines Pools

<p class="callout info">zfs create -o compression=off test/speed  
cd /test/speed  
dd if=/dev/zero of=dd.tmp bs=256k count=16384 status=progress  
dd if=/dev/zero of=dd.tmp bs=2M count=16384 status=progress</p>

[![Bildschirmfoto 2025-01-21 um 15.30.20.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-30-20.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-30-20.jpg)

[![Bildschirmfoto 2025-01-21 um 15.31.09.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-31-09.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-31-09.jpg)
#### Erweiterung der Funktionen des Pools

> zpool status meldet neue Funktionen im ZFS und kann leicht und schnell mit
> 
> <p class="callout info">zpool upgrade -a</p>
> 
> erledigt werden
> 
> Jedoch würde ich in jedem Fall empfehlen zu prüfen ob meine Notfall ISO diese Funktionen bereits unterstützt!

[![Bildschirmfoto 2025-01-21 um 15.59.16.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-59-16.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-59-16.jpg)

[![Bildschirmfoto 2025-01-21 um 15.59.26.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-15-59-26.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-15-59-26.jpg)

> Für das Auslesen der Parameter von Pools, Volumes, Datasets und Snapshots gibt es den Parameter **get**

[![Bildschirmfoto 2025-01-21 um 16.00.49.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-00-49.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-00-49.jpg)

#### Bereitstellen und entfernen von Pools ohne löschen

> zpool import #zeigt was es zum importieren, also bereitstellen gibt
> 
> zpool import poolname oder -a für alle importiert den Pool oder alle verfügbaren Pools
> 
> Am elegantesten importiert man den Pool über
> 
> **zpool import -d /dev/disk/by-id**
> 
> damit man hinterher nicht sda, sdb, sondern die Bezeichner im Status sieht

[![Bildschirmfoto 2025-01-21 um 16.12.48.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-12-48.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-12-48.jpg)

Nach der Bereitstellung würde man hier lediglich einen Mountpoint /test finden, bei TrueNAS /mnt/test. Dazu noch die Systemdatasets vom Proxmox selbst. Danach legen wir gleich mal ein Dataset namens dateisystem und ein Volume namens volume an.

[![Bildschirmfoto 2025-01-21 um 16.27.43.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-27-43.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-27-43.jpg)

> Datasets werden als Ordner gemountet und / oder /mnt
> 
> Volumes findet man unter /dev/zd... und zusätzlich mit vernünftigen Namen unter /dev/zvol/tankname/....

[![Bildschirmfoto 2025-01-21 um 16.28.41.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-28-41.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-28-41.jpg)

> Datasets werden mit Linuxcontainern, Backupfiles, Vorlagen oder Serverdateien bespielt
> 
> Volumes verhalten sich wie eingebaute Datenträger, jedoch virtuell. Sie stehen nach dem Import des Pools bereit und können in einer VM genutzt werden. Manipulationen an Volumes zur Vorbereitung oder Datenrettung können jedoch ebenso auf dem PVE Host vorgenommen werden

<p class="callout danger">Diese Schritte übernimmt üblicherweise der Installer in der VM und sollen nur aufzeigen wie diese ZVOLs genutzt werden</p>

[![Bildschirmfoto 2025-01-21 um 16.42.58.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-42-58.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-42-58.jpg)

[![Bildschirmfoto 2025-01-21 um 16.43.33.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-43-33.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-43-33.jpg)
[![Bildschirmfoto 2025-01-21 um 16.48.11.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-48-11.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-48-11.jpg)
[![Bildschirmfoto 2025-01-21 um 16.48.19.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-48-19.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-48-19.jpg)
Proxmox legt seine Datasets für LXC so ab

[![Bildschirmfoto 2025-01-21 um 16.52.46.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-52-46.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-52-46.jpg)
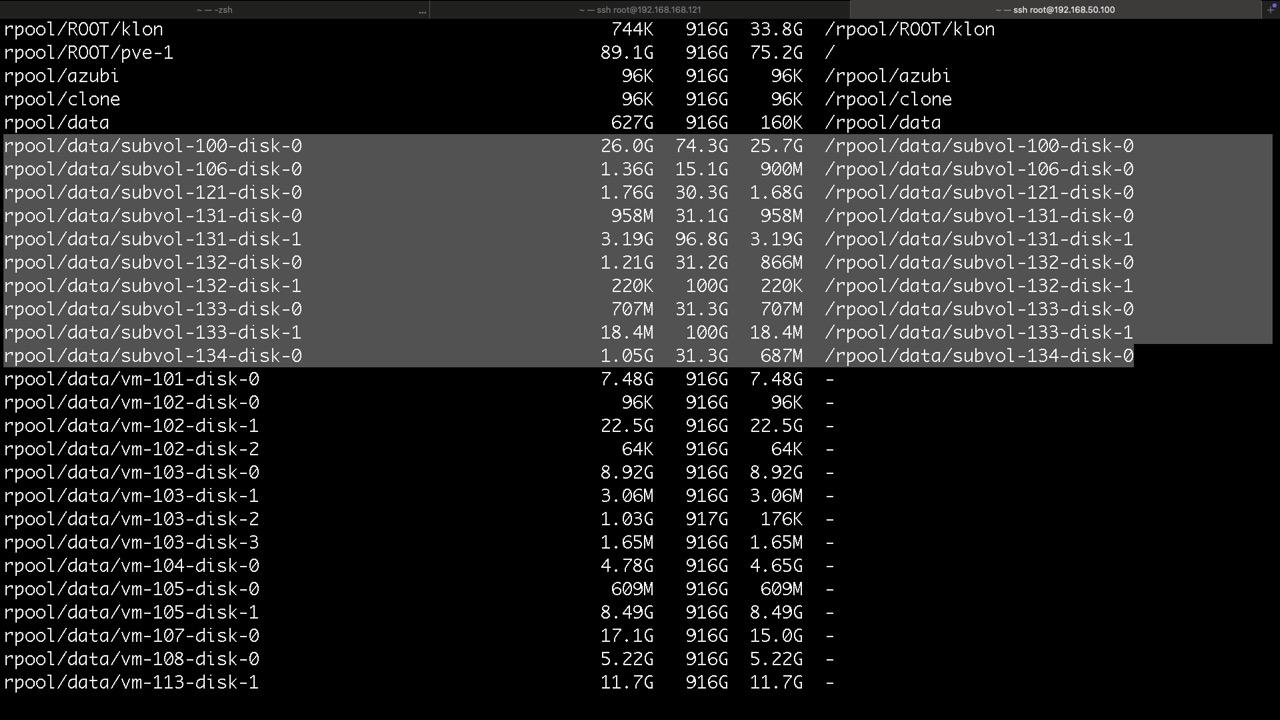
und so die ZVOLs für VMs mit KVM, hier findet man die virtuellen Disk und /dev/zvol...

[![Bildschirmfoto 2025-01-21 um 16.51.58.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-21-um-16-51-58.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-21-um-16-51-58.jpg)
#### Thin- und Thickprovisioning für Datasets und Volumes

> Am Beispiel von Proxmox VE via GUI wird hier eine Thinprovision Festplatte für VM 301 mit 32GB und einer Standardblockgröße von 16k erzeugt. 8k sind nur bei Raid1 und 10 möglich. Hakt man den Thinprovision Haken nicht an, wird beim Erzeugen noch die Option -o refreservation=32G ergänzt. Diese macht bei ZFS mit Autosnapshots aber keinen Sinn

<p class="callout info">zfs create -s -b 16k -V 33554432k rpool/data/vm-301-disk-4</p>

<p class="callout success">rpool/data/vm-301-disk-4<span class="Apple-converted-space"> </span>56K<span class="Apple-converted-space"> </span>1.17T<span class="Apple-converted-space"> </span>56K<span class="Apple-converted-space"> </span>- **\#hier kein Mount sonder unter /dev/zvol/...**</p>

> Bei LXC werden Datasets genutzt und der Platz via Reservierung genutzt, wobei bei der genutzten Refquota auch die Snapshotaufhebezeiten den Nettoplatz verkleinern, daher größer dimensionieren, gerne mal doppelt so groß

<p class="callout info"><span class="Apple-converted-space"> </span>zfs create -o acltype=posixacl -o xattr=sa -o refquota=33554432k rpool/data/subvol-106-disk-1</p>

<p class="callout success">rpool/data/subvol-106-disk-1<span class="Apple-converted-space"> </span>96K<span class="Apple-converted-space"> </span>32.0G<span class="Apple-converted-space"> </span>96K<span class="Apple-converted-space"> </span>**/rpool/data/subvol-106-disk-1 #hostzugriff möglich**</p>

> Virtuelle Diskimages wie QCOW2, VMDK oder RAW-Dateien legt man üblicherweise nicht in Datasets, bestenfalls für NFS oder iSCSI Server

#### Snapshots

> Snapshots können jederzeit erstellt oder gelöscht werden. Die Datasets und Volumes befinden sich immer in einem Livezustand der sich durch die Vektorkette der eventuell vorhandenen Snapshots ergibt. Entfernt man einen Snapshot, so verändert sich der Weg der Vektoren. Das Ganze geschieht fast ohne Last!
> 
> ZFS selbst bringt weder Workflows für Snapshotting, noch Replikationen mit. Es stellt nur die Werkzeuge bereit
> 
> Snapshots generiert man bei Proxmox offiziell mit der GUI manuell oder für Replikationen, jedoch leistet dieser Workflow nicht genug.
> 
> Daher nutzen wir...

<p class="callout info">apt install zfs-auto-snapshot -y</p>

> ZFS-AUTO-SNAPSHOT legt seine Verknüpfungen in alle Cronordner. Proxmox VE weiß erst mal nichts davon. Zu berücksichtigen ist hier lediglich daß wir den Pool nicht über 80% befüllen wollen. Gehen wir darüber hinaus, müssen wir in den Cronordnern die Verknüpfungen anpassen um die Aufhebezeiten zu reduzieren.

<p class="callout info">nano /etc/crontab<span class="Apple-converted-space"> #kann angepasst werden, die viertelstündlichen finden sich unter cron.d!</span></p>

\# .---------------- minute (0 - 59)  
\# |<span class="Apple-converted-space"> </span>.------------- hour (0 - 23)  
\# |<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>.---------- day of month (1 - 31)  
\# |<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>.------- month (1 - 12) OR jan,feb,mar,apr ...  
\# |<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>.---- day of week (0 - 6) (Sunday=0 or 7) OR sun,mon,tue,wed,thu,fri,sat  
\# |<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>|<span class="Apple-converted-space"> </span>|  
\# \*<span class="Apple-converted-space"> </span>\*<span class="Apple-converted-space"> </span>\*<span class="Apple-converted-space"> </span>\*<span class="Apple-converted-space"> </span>\* user-name command to be executed  
17 \* \* \* \* root cd / &amp;&amp; run-parts --report /etc/**cron.hourly**  
25 6 \* \* \* root test -x /usr/sbin/anacron || { cd / &amp;&amp; run-parts --report /etc/**cron.daily**; }  
47 6 \* \* 7 root test -x /usr/sbin/anacron || { cd / &amp;&amp; run-parts --report /etc/**cron.weekly**; }  
52 6 1 \* \* root test -x /usr/sbin/anacron || { cd / &amp;&amp; run-parts --report /etc/**cron.monthly**; }

<p class="callout info">cat /etc/cron.hourly/zfs-auto-snapshot<span class="Apple-converted-space"> </span></p>

<p class="callout success">exec zfs-auto-snapshot --quiet --syslog --label=hourly **--keep=96** // #also in dem Fall 96 Stunden</p>

> Wir empfehlen für den Start folgende Settings: Drei Monate, sechs Wochen, zehn Tage, 96h und 12 Viertelstunden
> 
> Damit kommt man auf ca. 2,5x- 3x so viele Daten wie belegt wären ohne Snapshots. Erfahrungswert.
> 
> Das wären pro virtueller Disk oder LXC Mountpoint etwa 127 Snaphots, bei 20 Disks über 2540.
> 
> Nicht davon abschrecken lassen, es geht auch easy fünfstellig, wenn die IO stimmt!
> 
> Die in PVE eingebaute Snapshotfunktion sollte nicht mit den Autosnapshots kombiniert werden.
> 
> Im Problemfall stoppen wir die VM, manipulieren was zu machen ist und starten sie wieder!
> 
> Der eigentliche Vorteil der Snapshots in der GUI ist die Notierung der VM Definition zur Zeit der Erstellung, was wir über ein Backup im hauseigenen Postinstaller kompensieren. Dort findet man die Historie der PVE Config

[![Bildschirmfoto 2025-01-23 um 14.29.16.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-23-um-14-29-16.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-23-um-14-29-16.jpg)
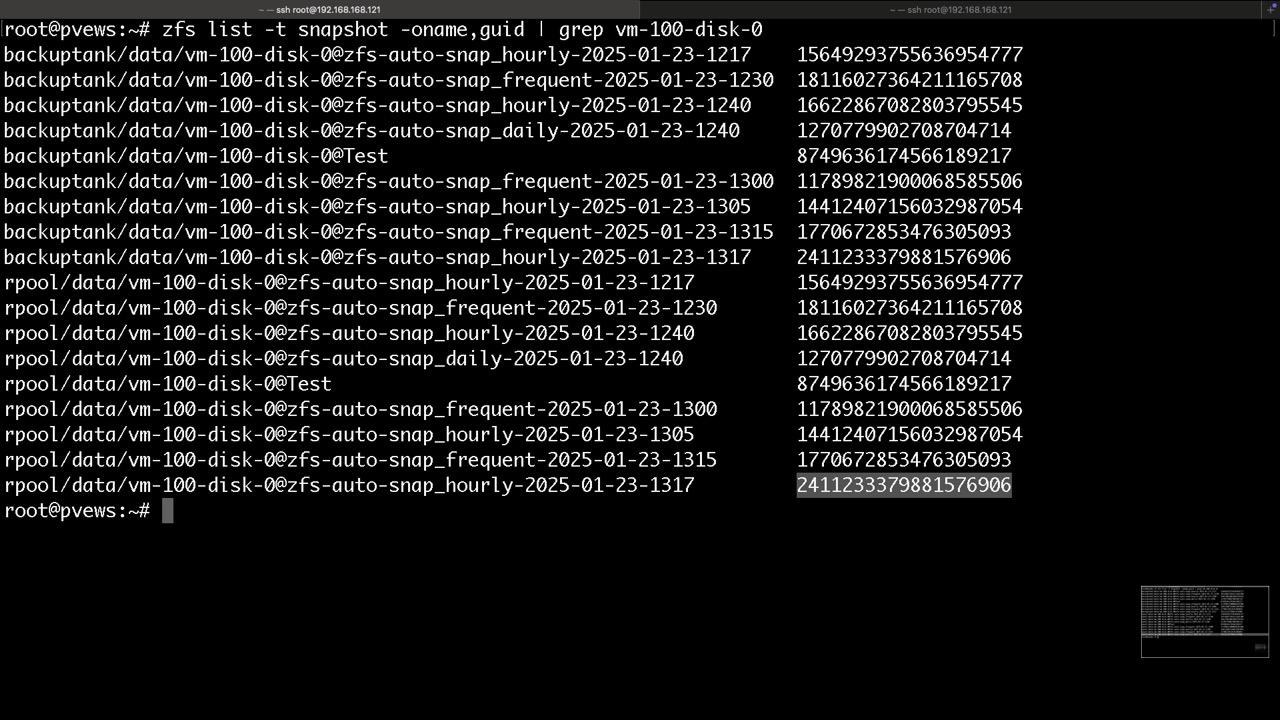
##### Kleines manuelles Beispiel, was für uns aber Z-A-S übernimmt

**Snapshot**

<p class="callout info">zfs snapshot tank/sub/datasetodervolume@snapshotname</p>

**Auflisten**

<p class="callout info">zfs list -t snapshot tank/sub/datasetodervolume</p>

**VM oder LXC ausmachen**

**Rollback**

<p class="callout info">zfs rollback -r rpool/data/vm-100-disk-0@Test #danach ist alles neuere weg! </p>

**VM oder LXC starten**

#### Dynamik von Snapshots

Wir unterscheiden zwei Sorten von Datennutzung

- Zunehmende Datennutzung wie bei einem NAS 
    - Es kommt nur was dazu und wird selten gelöscht
    - Viele Snapshots auf lange Zeit ändern nichts an der Gesamtnutzung des Pools
    - Replikation außer Haus kann in kleinen Schritten passieren, da die Gesamtübertragung gleich groß ist
- Rotierende Datennutzung wie bei einem Datenbankserver 
    - Daten verändern sich permanent, wenig Zuwachs
    - Viele Snapshots auf lange Zeit ändern **brachial viel** an der Gesamtnutzung des Pools
    - Replikation außer Haus sollte in einem Schritt, ohne Zwischensnapshots passieren, da die Gesamtübertragung sonst ein vielfaches größer sein kann
    - Nur essenzielle Wiederherstellungspunkte sollten aufgehoben werden um das System nicht unnötig zu befüllen

#### Dynamik von Snapshots

> Dank ZFS kann man langfristig Replikationen inkrementell vornehmen, jedoch dauert die erste Replikation natürlich länger, wenn schon Datenbestand da war

#### Übliche Vorgehensweise einer Datenübertragung

PC NTFS&gt;SMB&gt; Datei &gt; SAMBA Server BTRFS LVM &gt; EXT4 Datei = Konsistent? Bitrod?

<p class="callout danger">Zu viele Köche verderben die Köchin</p>

#### Funktion von Snapshotreplikation

##### Von ZFS zu Datei, was wenig Praxis findet

<p class="callout danger">zfs send tank/dataset@snapshot &gt; datei.zfs</p>

<p class="callout danger">zfs recv tank &lt; datei.zfs</p>

##### Von ZFS zu ZFS, was üblich ist

<p class="callout success">zfs send | zfs recv #laufen immer gleichzeitig  
</p>

<p class="callout info">zfs send rpool/data/vm-100-disk-0@Test | zfs recv -dvF backuptank   
**\#überträgt den Zustand Test auf ein lokalen weiteren Pool, wobei das zfs Tool immer doppelt läuft**  
</p>

##### Pushreplikation

<p class="callout info">zfs send -pvwRI rpool/data/vm-100-disk-0@Test rpool/data/vm-100-disk-0@zfs-auto-snap\_hourly-2025-01-23-1317 | zfs recv -dvF backuptank  **\#Fortschritt, Infos, Rohdaten plus Historie, ideal für verschlüsselte Volumes, erspart das De- und Komprimieren**</p>

#### Workflow

- Erzeugen eines Datasets oder Volumes
- Snapshot auf Dataset oder Volume ausführen
- Übertragung des Snapshotzustands auf Ziel, optional mit Zwischenständen

<p class="callout warning">Trojanerproblem: Wer auf Quelle sitzt kann Pushziele löschen</p>

<p class="callout success">Lösung: Pullreplikation, ähnlich Backupsoftware, Transport SSH, Daten ZFS  
Quelle |&gt; Pullserver  
  
</p>

<p class="callout success">zfs **recv** | ssh root@quelle zfs **send** #Pull Replikation via SSH  
</p>

##### Von PVE zu PVE, was uns zu wenig ist

[![Bildschirmfoto 2025-01-23 um 16.26.18.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-23-um-16-26-18.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-23-um-16-26-18.jpg)
[![Bildschirmfoto 2025-01-23 um 16.26.33.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-23-um-16-26-33.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-23-um-16-26-33.jpg)
[![Bildschirmfoto 2025-01-23 um 16.26.37.jpg](https://aow.de/uploads/images/gallery/2025-01/scaled-1680-/bildschirmfoto-2025-01-23-um-16-26-37.jpg)](https://aow.de/uploads/images/gallery/2025-01/bildschirmfoto-2025-01-23-um-16-26-37.jpg)
<p class="callout warning">Proxmox baut selbst keine Notfallpunkte auf und nutzt ZFS nur als Transport, nimmt jedoch manuelle und automatisierte Snapshots mit, auch von Z-A-S!</p>

<p class="callout warning">Weitere Kopien per ZFS sind nur per Pushverfahren möglich, was ideal für Angreifer ist wenn sie alles löschen möchten. Ein Backupserver ist hier unverzichtbar, bei Pullreplikation gehts ggf. auch ohne. Außer Haus ist es nicht möglich ein ZFS Replikat zu senden, da sich der Partner im lokalen Cluster befinden muss!</p>

#### Nondestruktiver Rollback nach Trojanerbefallt bei Forensikbedarf

# Proxmox

> **Die Dokumentation für "Proxmox Produktiv mit ZFS betreiben" basiert auf einem kostenpflichtigen Kurs und soll dessen Inhalte wiedergeben, kann aber nicht die Betreuung und Beantwortung von Fragen, wie sie der Besuch des Kurses bietet, ersetzen. Es soll das Wissen von den hauptberuflichen Sysops Admins an Interessierte weitergegeben werden, die es danach auf den von Ihnen betreuten Systemen umsetzen können.**
> 
> **[https://cloudistboese.de](https://cloudistboese.de) - Das Schulungsportal von sysops.tv**

# Proxmox VE - Alternative zu vSphere und Hyper-V mit Support aus Deutschland und Österreich

Was ist Proxmox VE
- Proxmox VE ist eine Gesamtlösung zur Virtualisierung
- Einsatzbereiche Standalone bis Cluster
- Es beinhaltet entscheidende Storagefunktionen mit ZFS und Ceph
- Umfangreiche Virtualisierung und Containering Lösung  
- Moderner Unterbau mit aktuellem Debian Linux
- Reichhaltige Funktionen die durch eigene Kommandozeilenlösungen erweitert werden

Wo sind die Grenzen von Proxmox VE
- Kaum bis keine Funktionen in der GUI für Storage Steuerung und Monitoring
- Viele Funktionen lassen sich nur per Kommandozeile ausführen
- Es gibt keine Möglichkeit ein defektes System per Installation zu reparieren, Reparaturkenntnisse müssen vorhanden sein
- Das Eigenmonitoring ist so gut wie nicht vorhanden. Defekte Replikationen, Raids oder Datenträger nur mühsam feststellbar

Weitere Funktionen, die eher weniger Sinn machen
- SAN mit iSCSI (keine GUI)
- SAN mit NFS (beste Option)
- Hardware Raid mit LVM (kein Vorteil zu ZFS / CEPH)
- Multipath nur per manueller Konfiguration

 Indikation für Einsatz
  - Kleinere Anzahl von PVE Systemen mit direkt angeschlossenen Datenträgern (kein Hardware Raid!)
  - Hoher Bedarf an Reparatur durch Snapshots (tausende Snapshots kein Problem)
  - Leichte Replikation der Daten auf zweites System und eventuelle weitere Ziele (mit Bashclub Tools und GUI möglich, Pull Replikation nur mit unseren Tools)
  - Hauseigene Datensicherungslösung auf Hypervisor Ebene
  - Eigenes Monitoring und Reporting bevorzugt - Zentrales Monitoring wie Check_MK ist zwingend notwendig

>** Bei Proxmox kommt alles aus den Kernel (ZFS, Ceph, LXC, KVM, uvm.) **

Linux Kommandos die man kennen sollte
- lsblk #zeigt Datenträger und Partitionen an
- ls -althr /dev/disk/by-id # zeigt Festplatten Aliase zum eindeutigen Zuweisen von Raids an
- ls -althr /sys/class/net #zeigt aktuelle Netzwerkkarten an
- ls -althr /dev/zvol/rpool/data # zeigt ZVOL Namenszuordnungen zu /dev/zdxxx an
- dmesg -Tw #zeigt Hardwareänderungen wie Diskwechsel oder Netzwerkkabel stecken live an
- systemctl --failed #zeigt hängende dienste an
- htop #zeigt load  an. hier sollten die drei Zahlen unter der Anzahl der logischen Kerne sein. Also 16 Kerne, Load unter 16. Erste Zahl letze Minute, zweite Zahl letze fünf Minuten, dritte für letzte Viertelstunde
- zpool list # hier muss der Wert Cap unter 80% liegen, sonst müssen Snapshots oder sogar produktive Daten gelöscht werden
- zpool status #Raid Status
- zfs list -t snapshot #z. B. mit -oname,written,creation rpool/data/vm-100-disk-1
- qm stop 100 && zfs rollback rpool/data/subvol-100-disk-0@zfs-auto-snap_hourly-2024-10-24-0217 && qm start 100 # Rollback ohne Widerkehr der Daten einer VM


# Proxmox Installation

Um Proxmox mit ZFS nutzen zu können, müssen die Platten direkt an Proxmox angebunden werden. Es sollte **kein RAID Controller mit RAID 0** genutzt werden, da dies früher oder später zu Problemen und Datenverlusten führen wird!
Damit auch eine Update von Promox 7.x auf 8.x gezeigt werden kann, wird im Kurs mit der Installation einer Proxmox Version 7.x begonnen und später auf 8 aktualisiert.
Das Postinstall Script aus dem Bashclub wird installiert, um auch alle benötigten Tools für die tägliche Arbeit und im Problemfall im Zugriff zu haben. (z.B. ohne ein Netzwerkverbindung kann nichts mehr nachinstalliert werden)

Spickzettel für Installation
- Kein RAID Controller
- Platten direkt an Proxmox geben, es müssen die Herstellerbezeichnung der Platten im Linux Betriebssystem sichtbar sein. (z.B. nvme-INTEL_... über das Kommando `ls /dev/disk/by-id`)
- ISO Installation mit Version 7.x
    - Install Proxmox starten
      - Die Standardauswahl im Installer würde LVM auf eine Disk installieren, was  nur für Hardware Raid Sinn machen würde
      - ZFS RAID 1 oder ZFS RAID 10 sind die empholenen Level für die Beste Leistung, haben jedoch einen Platzverlust von 50%, was in der Natur liegt
      - Advanced Options - ZFS Optionen können default gelassen werden, ashift=12 + compression=on passt für alle Platten über 2TB
      - Passwort muss sich in der HTML Console gut tippen lassen - HTML und JAVA Konsolen sind hier sehr schwierig mit deutsch Tastatur! Testen!
      - Die Installation mit sorgfältig gewählten Namen und IP Adressen durchführen

## Proxmox GUI Zugriff
- Im Browser: https://&lt;ip&gt;:8006  
    - Single PAM - ssh login # Benutzer auf Linux Ebene und PVE GUI
    - Proxmox VE - Weboberfläche Cluster User

- **Proxmox CLI** gegen root SSH Zugriff schützen (macht auch das SSH Hardening unseres Postinstallers)
- /etc/ssh/.sshd\_config
  - PermitRootLogin without-password
  - service sshd reload

  **Proxmox GUI**
- TOTP (time-based one-time password) kann über die Proxmox GUI gesetzt werden
  - Datacenter - Permissions - Two Factor
  - Selbst bei kompromitierem Passwort kann kein Dritter zugreifen!
  - Für PAM und PVE User möglich

# Update nach Proxmox 8.x - Für Einsteiger am einfachsten bei Erstinstallation zu üben

[Proxmox Update 7 to 8](https://pve.proxmox.com/wiki/Upgrade_from_7_to_8#In-place_upgrade)

Das Pre-Upgrade Check Script pve7to8 sollte ausgeführt werden, um mögliche Probleme vor dem Upgrade erkennen zu können. Erstmal ohne Parameter und anschließend mit Parameter (--full: alle Checks).

> ** Für das Upgrade muss entweder eine Subskription erorben werden. Alternativ kann man auch das Enterprise Repository deaktivieren und das No-Subkription Repository aktivieren. Nur so erhält man Proxmox Updates!!! **Ohne diese Auswahl kommen nur Debian Security Fixes!!!**

Hier der Stand Version 7 zu 8

- `pve7to8`

- `ve7to8 -- full`

> **Wir empfehlen die VMs und Container zu stoppen und einen zeitnahen Reboot - Der neue Kernel passend zur GUI kann nur so aktiviert werden**

  apt update
  apt dist-upgrade
  pveversion

> **Letzte Version PVE 7 sollte nun installiert sein, kein Reboot notwendig hier**


#  Upgradeprozedur bei Standardsystem
  
  
  sed -i 's/bullseye/bookworm/g' /etc/apt/sources.list # ändert alle Repositories von Bullseye (Debian 11) zu Bookworm (Debian 12)
  
  # Enterprise Repo anpassen
  echo "deb https://enterprise.proxmox.com/debian/pve bookworm pve-enterprise" > /etc/apt/sources.list.d/pve-enterprise.list
  
  # Debian update
  screen # falls etwas schief geht kann man mit screen -r zurück zur Sitzung
  apt update
  apt dist-upgrade #sollte hier mehrere hundert Aktualisierungen ankündigen
> **Während des Upgrades sollte man alles mit N beantworten und den Diensteneustarts zustimmen. Es kommt ggf. auch ein Textdokument was mit w zu verlassen ist**


> **Unser Postinstaller sorgt in kürzester Zeit für alle notwendigen Sicherheits- und Komforfunktionen für den Notfall**


Postinstall aus bashclub (proxmox-zfs-postinstall) auf github
  - [Bashclub Postinstaller Proxmox](https://github.com/bashclub/proxmox-zfs-postinstall)
    - ZFS L1ARC Size wird von PVE nur lieblos berechnet, empfohlen sind 1GB RAM für 1TB netto Datastore als first Level Cache
    - Swappiness auf 10 Prozent oder kleiner, damit PVE nicht zu früh auslagert, jedoch am besten nicht den RAM überprovisioneieren!
    - ZFS auto snapshots - die Werte können frei konfiguriert werden. Empfehlung für den Start (PVE weiß nichts davon!)
      - monthly: 3
      - weekly: 6
      - daily: 10
      - frequent: 12
      - hourly: 96 --\> wegen Weihnachten und Ostern  
    - Repo
      - No Subscription auswählen, falls keine Subskription vorhanden

> **Wir sichern extra die /etc Ordner nach rpool/pveconf, da der Ordner /etc/pve aus einer Datenbank live erstellt wird. Er wäre bei einer Reparatur via Boot ISO leer!!!**

Die ZFS auto Snapshots werden über die crontab ausgeführt. Dafür gibt es verschiedene Verzeichnisse:
- /etc/cron.hourly
- /etc/cron.daily
- /etc/cron.weekly
- /etc/cron.monthly
- /etc/cron.d (viertelstündlich)

In den Ordner liegt dann für jede "Aufgabe" ein eigene Datei (z.B. `zfs-auto-snapshot`), in welcher die auszuführen Kommandos enthalten sind. Dort ist auch hinterlegt wieviele auto snapshots aufgehoben werden sollenn. (`--keep=96`)

> **Die Zeitpunkte wann dieses ausgeführt werden sind in der Datei `/etc/crontab` definiert. z. B. könnte dort der tägliche Zeitpunkt angepasst werden**

> **Ebenfalls finden sich Skripte ab Werk unter /etc/cron.d für z. B. Scrubbing und Trimming am Sonntag. Nicht jedem taugt dieser Zeitpunkt!**

```
cat /etc/crontab 
# /etc/crontab: system-wide crontab
# Unlike any other crontab you don't have to run the `crontab'
# command to install the new version when you edit this file
# and files in /etc/cron.d. These files also have username fields,
# that none of the other crontabs do.

SHELL=/bin/sh
PATH=/usr/local/sbin:/usr/local/bin:/sbin:/bin:/usr/sbin:/usr/bin

# Example of job definition:
# .---------------- minute (0 - 59)
# |  .------------- hour (0 - 23)
# |  |  .---------- day of month (1 - 31)
# |  |  |  .------- month (1 - 12) OR jan,feb,mar,apr ...
# |  |  |  |  .---- day of week (0 - 6) (Sunday=0 or 7) OR sun,mon,tue,wed,thu,fri,sat
# |  |  |  |  |
# *  *  *  *  * user-name command to be executed
17 *	* * *	root	cd / && run-parts --report /etc/cron.hourly
25 6	* * *	root	test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.daily; }
47 6	* * 7	root	test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.weekly; }
52 6	1 * *	root	test -x /usr/sbin/anacron || { cd / && run-parts --report /etc/cron.monthly; }
#

```

Zusätzlich gibt es für jeden User (z.B. root) noch eine eigene crontab, diese liegen unter `cd /var/spool/cron/crontabs/`. Dort gibt es dann eine Datei `root` für den User root, falls diese erzeugt wurde. Diese Datei wird z.B. auf den Linux VMs genutzt, um das Trimming zeitgesteuert ausgeführen zu können.


# proxmox-boot-tool / ZFS Feature Upgrade / Trimming einschalten

> **Mit dem `promox-boot-tool` könnten Platten nach einen Hardwaretausch wieder bootfähig gemacht werden. Heute sollte nach Möglichkeit uefi Boot eingesetzt werden und nicht mehr legacy Boot, damit werden die Boot Platten automatisch erkannt und müssen nicht einzeln durch probiert werden, wie bei legacy boot.
Autotrim sollte auf den SSD ZFS Datasets eingeschaltet sein, damit gelöschte Blöcke wieder im Dateisystem schnell verfügbar gemacht werden.**

Optionale Funktionen zur ZFS Storage Optimierung

- zpool set autotrim=on rpool # für SSD Pools
- zpool set autoexpand=on rpool #vor Plattentausch auf größere Disks
- zpool upgrade #regelmäßig prüfen ob hier bei zpool status ein Hinweis ist. Der aktuelle PVE ISO Installer muss aber mit der Version bestückt sein, daher ggf. immer eine Version abwarten
- zpool trim rpool #test ob Trimming das System ausbremst
- zpool iostat -v 1 # Live Status

Einige wichtige Ordner vom Proxmox:

- Proxmox Konfiguration unter /etc/pve #Wie bereits oben erwähnt wird dieser Ordner nur zur Laufzeit von PVE aktiviert und ist bei einer Wiederherstellung per ISO leer! Daher unser Backup unter rpool/pveconf
- Template Ordner <span style="color: rgb(224, 62, 45);">**/var/lib/vz** </span>
- ISO Ablage Ordner **<span style="color: rgb(224, 62, 45);">/var/lib/vz/template/iso </span>**  - z.B. virtio-win.iso
- Cache <span style="color: rgb(224, 62, 45);">**/var/lib/vz/cache/** </span>z.B. \*.tar.gz Proxmox Mailgateway

# PVE startet noch, hat aber defekte Installation oder Konfiguration - Rollback vom Debian mit PVE

Wenn der Proxmox nicht mehr richtig funktioniert, werden die folgenden Schritte durchgeführt, um ihn wieder herzustellen zu können. Die erforderlichen ZFS snapshots werden durch die "Tools" des Postinstaller erzeugt.
Beim PVE Ordner (`/etc/pve`) handelt es sich um eine Datenbank (`/dev/fuse               128M   20K  128M   1% /etc/pve`), die **ohne den Postinstaller nicht gesichert würden** (`rpool/pveconf           884G  128K  884G   1% /rpool/pveconf`). 

> <span style="color: rgb(224, 62, 45);">**Daher sollte der Postinstaller aus dem Bashclub auf jeden Promox PVE installiert sein, damit die Konfigurationsverzeichnisse von Proxmox auf ZFS gesichert und mit Auto Snapshosts versehen werden !!!**</span>

- Proxmox CD bzw. ISO booten - Debug auswählen

- ```
  exit - damit nicht der Installer bootet
  zpool status zpool import # zeigt ob der Pool komplett und fehlerfrei ist, könnte ja ein Hardware Problem sein
  zpool import rpool # würde wegen letztem Zugriff durch Fremdsystem nicht reichen
  zpool import -f rpool
  zpool status
  zpool list
  zfs list -t snapshot rpool/ROOT/pve-1
  Dann z. B. auf funktionierenden Stand zurückrollen...
  zfs rollback -r rpool/ROOT/pve-1@zfs-auto-snap.hourly\_2023-09-26-1251 # entsprechender snapshot - boot und Proxmox geht wieder ```
  Reboot oder Reset Server
  ```
> **Sollte der Rollback Punkt z. B. auf einen Punkt von PVE 7 zeigen, so kann man beim Booten einen älteren Kernel auswählen

Nach erfolgreichem Neustart empfehle ich

- proxmox-boot-tool refresh
- apt update
- apt dist-upgrade
- reboot als Test 

    
# Installation Windows mit VirtIO Treiber

> ** Inzwischen installiert der Postinstaller einmalig eine aktuelle Virtio Treiber ISO als stabile Version - Für spätere Downloads...**
    
- VirtIO Treiber im Internet finden 
  - Proxmox Windows Driver im Browser suchen
    - [Proxmox VirtIO Drivers](https://pve.proxmox.com/wiki/Windows_VirtIO_Drivers)

- Auf Proxmox Seite nach Stable suchen  
    - Link kopieren
         - [Stable Download (Fedora) - Link von Proxmox Seite](https://fedorapeople.org/groups/virt/virtio-win/direct-downloads/stable-virtio/virtio-win.iso)
    - In ProxMox GUI
      - Download URL eintragen unter pvews - local (pvews) - ISO Images
        - Filename: VirtIO-win.iso  
        - ISO Ablage Ordner \*\*/var/lib/vz/\*\*template/iso


- Create VM
  - General
    - Node: pvews
    - VM ID: 101
    - Name: win
    - Start at boot: Haken
  - OS
    - Use CD/DVD disc image file (iso)
      - Storage: local
      - ISO Image: Win10_22H2_German_x64.iso 
  - System
    - Maschine q35 # nicht i440fx
    - BIOS: OVMF (UEFI)
    - Add EFI Disk: Haken
    - Emu Agent Haken
    - EFI Storage: local-zfs
    - SCSI Controller: VirtIO SCSI Single # Achtung bei Hotplug weiterer Platten muss im Geräte Manager der neue Controller gefunden werden oder Reboot!
  - Disks
    - Bus/Device: SCSI 0
      - VirtIO Block ist obsolet !!!
    - SCSI - VirtIO SCSI Single - steht auf der Seite davor - SCSI Contoller kann ein  Prozessorkern pro Festplatte exklusiv nutzen
    - Discard: Haken # für Trimming der VM
    - SSD emulation: # Haken für Trimming
    - Cache: - Default (no cache) - keine Cache einschalten !!!  
  - CPU
    - Socket: 1
    - Cores: 4 # relativer Wert zu anderen VMs
    - Type: Host (Standard: x64-64-v2-AES) # mit Host wird die CPU 1:1 abgebildet, AES und Co. reduzieren den Funktionsumfang der virtuellen CPU, erhöhen aber die Kompatibilität bei Migration zwischen nur ähnlichen PVE Hosts
  - Memory
    - Memory: 4096
  - Network
    - Bridge: vmbr0
    - Model VirtIO (paravirtualized) - kann mehr wie 1Gbit, 100Gbit möglich

> **Inzwischen kann man die geladene virtio.iso als zweites Laufwerk in die VM einklinken**
        
> **q35 Version 5.2 - weniger Probleme als mit Version 8.0 wegen deutschen Treibern - ist für US optimiert ... - Probleme mit Netzwerkkarten möglich**

> **EFI hat feste Bildschirmauflösung - kann nur im EFI der VM eingestellt werden (EFI BIOS) - Im Bootvorgang in der Console (Proxmox GUI) - ESC drücken**

Während der Installation am einfachsten nur die VIOSCSI Treiber installieren, da sonst keine Disks angeboten werden
Den Rest des Setups von der VIRTIO ISO kann nach der Installation erledigt werden.
Das spart die dummen Sicherheitsfragen und geht schneller.

Am Ende sollte auf der VM Statusseite die IP Adresse zu sehen sein, ansonsten noch prüfen ob der Haken bei Guest Agent an ist!

Für alle die von den APPS genervt sind etwas lustiges zum nachbasteln
```
Get-appxPackage | Remove-appxPackage # man verliert Taschenrechner - alle App werden entfernt - auch der Storage wird entfernt - Nach Feature Update wieder alles da

```

> **Windows installiert am Ende des Setups eine Wiederherstellungspartition. Diese ist eventuell zu entfernen, da ansonsten kein Resize möglich ist. Der Resize ist auf der Disk in PVE jederzeit möglich

> ** Windows ist inzwischen in der Lage freie Blöcke an ZFS zurückzugeben, für den Fall daß wie beschreiben SCSI Single + SSD Emulation plus Discard gewählt wurde**

Optional noch Hilbernation Mode aus
- ```
  attrib 
  powercfg -h off # evtl. darf es der User nicht - powershell als administrator starten  
  ```
> **Unser Datastore Swap kann genutzt werden um die Auslagerungsdatei auf eine eigene Disk zu legen. Das spart bei ramhungrigen Systemen viel Platz, da dort keine automatischen Snapshots ausgeführt werden. Die Platte muss nicht gesichert werden. Bei Linux bitte die Swap Disks mit Backup einmal sichern**

Trimming unter Linux
- Unter Linux wird nicht mehr benötigter Storage einer SDD wie folgt an ZFS freigeben
  - Linux<span style="color: rgb(224, 62, 45);">**`/sbin/fstrim -av` # für Linux VM, nicht LXC!**</span>

- Eine automatisierte Freigabe von nicht mehr benötigtem Storage, kann über die crontab in Linux gesteuert werden
  - crontab -e  # crontab für den User root
    - **5 * \* \* \* /sbin/fstrim -a** # Der crontab Eintrag bedeutet, daß jede fünfte Minute der vollen Stunde getrimmt wird


> **fstrim -av # muss eine Ausgabe bringen - sonst ist die VM falsch konfiguriert - VM Platten auf SSD und Discard umstellen**

# Festplatten Tausch bei Defekt oder S.M.A.R.T Fehler

- Artikel von ProMox - ist nicht ganz korrekt: [https://pve.proxmox.com/wiki/ZFS\_on\_Linux](https://pve.proxmox.com/wiki/ZFS_on_Linux)

> **Es reicht nicht mit zpool replace eine fehlende oder defekte Disk zu ersetzen. Sie könnte danach nicht booten. Wir benötigen ebenfalls zwei Partitionen mit dem Bootimage!**

Der Fall beschreibt den Tausch optional gleich gegen eine größere Festplatte oder SSD

**Erklärung zum Kommando `sgdisk ... -- R ...`**
- `sgdisk \<gutes boot device\> - R \<neue Platte\>` # Partitionen werden kopiert und die GUID wird beibehalten
- Soll eine neue GUID verwendet werden `sgdisk -G \<neue Platte\>`

```
dmesg -Tw
```

Platte einbauen und Output prüfen, sdf ist neue Disk

> **zpool set autoexpand=on rpool** # Erweiterung des Pools erfolgt am Ende automatisch!
> Bei Raid 10 reicht es zwei Disks zu Tauschen, bei RaidZx müssen allte getauscht werden um den Platz zu erweitern!

ls -althr /dev/disk/by-id | grep sdf (sdf wurde als neue Disk erkannt)

```
zpool status
```

Output zeigt aktive oder defekte Disks

```
	rpool                                                 ONLINE       0     0     0
	  mirror-0                                            ONLINE       0     0     0
	    ata-INTEL_SSDSC2KB019T8_PHYF951101ZS1P9DGN-part3  ONLINE       0     0     0
	    ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3  ONLINE       0     0     33
```

Wir tauschen nun die zweite Disk vorsorglich

> **-part3 zeigt deutlich daß es sich hier um die dritte Partion handelt die ersetzt werden muss, folglich sind Parition 1 und 2 zum booten!!!**

```
ls -althr /dev/disk/by-id | grep ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3 
```
lrwxrwxrwx 1 root root  10 Oct 15 17:38 ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3 -> ../../sdb3

Wir müssen also sdb3 ersetzen

Als erstes Paritionstabelle übernehmen und erweitern, falls größere Disk
```
sgdisk /dev/sdb -R /dev/sdf #sdb ist eine gute Disk, sdf die neue Disk
sgdisk -G /dev/sdf # neue GUID damit EFI die Disk unterscheiden kann
proxmox-boot-tool format /dev/sdf2 #format mit fat32
proxmox-boot-tool init /dev/sdf2 #kopiert Bootimage und notiert die Disk für künftige Updates
```
Optional

```cfdisk /dev/sda # Partition vergrößern```

> ** Beim nächsten sgdisk der Paritionstabelle einfach die große Disk als Vorlage nehmen

Jetzt den eigentlichen Datenbestand ersetzen

```
ls -althr /dev/disk/by-id | grep sdf | grep part3
zpool replace rpool ata-INTEL_SSDSC2KB019T8_PHYF951102271P9DGN-part3 ata-INTEL_SSDSC2KB019T8_PHYF95111111PXXX-part3
```

> ** Kontrolle des Erfolgs mit

```
zpool status # da soll dann die alte Disk raus sein und keine Fehler
zpool list # eventuell mehr freier Speicher nach Austausch von zwei Disks oder mehr
proxmox-boot-tool status #sollte zwei Treffer und einen Fehler melden, wegen gezogener defekter Disk
proxmox-boot-tool clean entfernt tote Bootdatenträger
```

# Windows kaputt machen - Trojanersimulation

- Netwerkkarte disablen durch Trojaner  
- VM herunterfahren  
- Entwicklung der Größe der snapshot‘s - als Indikator
  - Trojaner verursacht eine größere Änderung in den snapshots
- Rollback snapshot über Cockpit oder über command Line

# ZFS Cache

- Parameter -n: dry-run
  - erstmal anschauen, was das Kommando machen würde

```
zpool add -n rpool cache ata-intense..
zpool add -nf rpool cache ata-intense.. # wenn schon Daten auf der Platte
zpool add -f rpool cache ata-intense..
zpool iostat -v 3
zpool iostat -v 1 # 1 sec

```

Das Wort **"cache"** im Kommando ist sehr wichtig, da sonst die Platte evt. als einzel Mirror an den stehenden Mirror angehängt wird und das wollen wir nicht, daher immer mit -n testen !!! 

# Proxmox Cluster  
- GUI - Cluster - create cluster
- pvecm create „clustername“
- GUI - Cluster - „add Cluster“
- pvecm add clusterserver1


- Kein Cluster mehr
  - [https://pve.proxmox.com/wiki/Cluster\_Manager#\_remove\_a\_cluster\_node](https://pve.proxmox.com/wiki/Cluster_Manager#_remove_a_cluster_node)

  - **Auf der Seite zu den folgendem Punkt springen:** First, stop the corosync and pve-cluster services on the node:◦

```
cd /etc/pve
```
- storage.cfg

- qemu-server/\*.conf
- lxc/\*.conf
- nodes/... # Ordner mit den Cluster Member
- ```
    top 
    ps aux 
    ps aux | grep qm # Herstellung aller Maschinen anhand dieser Ausgabe 
    
  ```
- Login in den Cluster funktioniert nach dem Fehlschlag nicht mehr


```
service pveproxy restart

```

- Neues Zertifikat - zwei Faktor Authentification der lokal User fliegt heraus

```
cd /rpool/pveconf 
zfs list -t snapshot rpool/ROOT/pve-1 

```
- PVE Config zurück rollen

```
zfs rollback -r rpool/ROOT/pve-1@zfs-auto-snap_hourly-2023-09-28-1017 # panic Variante und Stromkabel nach 2 s

```

- besser von cd booten, rollback wie oben
- Ordner .zfs unter /rpool/pveconf
- ```
      cd snapshot # dieser Ordner nur in datasets vorhanden
      # Snapshot Order auswählen 
      cd zfs-auto-snap_hourly-2023-09-28-0717
      cd etc/pve/nodes/pvews
      cd lxc
      ls 
      cp 100.conf /etc/pve/lxc
      cd ..
      cd qemu-server
      cp 101.conf /etc/pve/qemu-server
      # evtl. Alternativ cp 101.conf /etc/pve/nodes/pvews/qemu-server
      vi /etc/pve/nodes/pvews/qemu-server/101.conf # Anpassung von Namen 
    
    ```

- Boot Partitionen löschen

  - Über dd

```
dd if=/dev/zero of=/dev/sda2 bs=1M count=511 
dd if=/dev/zero of=/dev/sdd2 bs=1M count=511 
proxmox-boot-tool status 

```

- Boot über CD/DVD - Advanced - debug mode console

- Type exit - damit Installer nicht startet  
- [https://pve.proxmox.com/wiki/ZFS:\_Switch\_Legacy-Boot\_to\_Proxmox\_Boot\_Tool](https://pve.proxmox.com/wiki/ZFS:_Switch_Legacy-Boot_to_Proxmox_Boot_Tool)

- **Aus der Webseite:**
  - Repairing a System Stuck in the GRUB Rescue Shell    
    - If you end up with a system stuck in the grub rescue&gt; shell, the following steps should make it bootable again:  
    - Boot using a Proxmox VE version 6.4 or newer ISO  
    - Select Install Proxmox VE (Debug Mode)  
    - Exit the first debug shell by typing **Ctrl + D** or `exit`  
    - The second debug shell contains all the necessary binaries for the following steps
    - Import the root pool (usually named rpool) with an alternative mountpoint of /mnt:
    - ```
      zpool import -f -R /mnt rpool
      zfs list 
      ```
    - Find the partition to use for proxmox-boot-tool, following the instructions from Finding potential ESPs  
    - Bind-mount all virtual filesystems needed for running proxmox-boot-tool: 

    - **mount -o rbind /proc /mnt/proc**
    - **mount -o rbind /sys /mnt/sys** 
    - **mount -o rbind /dev /mnt/dev**
    - **mount -o rbind /run /mnt/run**
    - ls /mnt  
    - change root into /mnt  
    - **chroot /mnt /bin/bash**

- cat /etc/network/interfaces
  - Zeigt die Netzwerk Interface Einstellungen
    
- ```
  proxmox-boot-tool status 
  lsblk 
  proxmox-boot-tool format /dev/sdb2 
  proxmox-boot-tool format /dev/sdc2 
  proxmox-boot-tool init /dev/sdb2 
  proxmox-boot-tool init /dev/sdc2 
  proxmox-boot-tool status 
  proxmox-boot-tool clean 
  zpool export rpool # Falls der `zpool export` vergessen wurde, nach dem reboot `zpool import -f rpool`
    
  ```
  
- &lt;CTRL&gt; &lt;ALT&gt; &lt;ENF&gt; # reboot auslösen
- 
- ```
    zpool import -f rpool # letzter Besitzer war CD
    exit # erneuter reboot
    zpool status
  ```
- **Wichtige Dateien:**  
    - /etc/network/interfaces
    - storage.cfg  
    - qemu-server/\*.conf  
    - lxc/\*.conf

- Boot Partitionen löschen
  - cfdisk /dev/sdb
    - Partition 1 und Partition 2 löschen ◦
  - fdisk /dev/sdc
    - Partition 1 in Partition 2 löschen
  - reboot

- Proxmox **neu installieren auf cache SSD ohne ZFS**
  - Boot von CD
  - Install Proxmox **ohne ZFS** auf SSD
    - Würde mit ZFS installiert, hätten wir wieder ein rpool und müssten den original Pool rpool in z.B. rpool1 umbenennen und local-zfs anpassen !!!!
    - **Profi Tipp:** Alle anderen Platten ziehen, damit auf keiner falschen Platten installiert wird
    - Installation mit ext4 mit lvm
    - **Neues Zertifikat**
    - **Passwort neu**
    - ssh meckert wegen known\_hosts # Neu Installation

    - ```
      zfs list # zeigt leere Liste
      zpool import -fa # alle importieren 
      zfs list # rpool ist wieder da 
      cd /rpool/pveconf 
      cd etc 
      cd pve 
      ls 
      cp storage.cfg /etc/pve 
      cd qemu-server 
      cp 101.conf /etc/pve/qemu-server # Produktiv System cp *.conf /etc/pve/qemu- 
      server 
      cd .. 
      cd lxc 
      cp 100.conf /etc/pve/lxc # Produktiv System cp *.conf /etc/pve/lxc 
    
      ```
      
  - ISO‘s als DVD heraus werfen, da vermutlich nicht gesichert
  - zpool remove rpool \<cache ssd\> # cache ssd entfernen # atach und detach nur mirror - alles andere wird removed
  - Am Abend wieder ganz machen
    - Booten von CD/DVD
    - Advanced Mode - Debug mode  
      - Partitionstabelle wiederherstellen

        - Anderen Proxmox anschauen

          - [https://pve.proxmox.com/wiki/ZFS:_Switch_Legacy-Boot_to_Proxmox_Boot_Tool](https://pve.proxmox.com/wiki/ZFS:_Switch_Legacy-Boot_to_Proxmox_Boot_Tool)

            - Repairing a System Stuck in the GRUB Rescue Shell

            - ```
              zpool import -f -R /mnt rpool
              zfs list

              ```

            - Find the partition to use for proxmox-boot-tool, following the instructions from Finding potential ESPs  
            - Bind-mount all virtual filesystems needed for running proxmox-boot-tool:

            - ```
              mount -o rbind /proc /mnt/proc
              mount -o rbind /sys /mnt/sys
              mount -o rbind /dev /mnt/dev
              mount -o rbind /run /mnt/run
              chroot /mnt /bin/bash
              # Partitionstabelle eines anderen ProxMox Systems anschauen 
              sgdisk /dev/sdd -R /dev/sdb # muss resized werden
              cfdisk /dev/sdb

              ```

            - Partition 3 wieder vergrößern # Werte überprüfen mit Foto falls vorhanden

            - ```
              sgdisk /dev/sdb -R /dev/sdc
              sgdisk -G /dev/sdb
              sgdisk -G /dev/sdc

              ```

            - Änderungen haben nicht gegriffen - reboot erforderlich # alternativ parted - partprobe bekommt das im laufenden Betrieb hin

            - Reboot  
            - Evtl. mit `proxmox-boot-tool` Partitionen wieder herstellen, zuvor muss die Proxmox Umgebung über die chroot Umgebung gebaut werden ...

            - ```
              reboot
              zpool import -fa
              exit # reboot vom ProxMox 
              zpool status
              proxmox-boot-tool status

              ```

  - Variante für das Arbeiten  
    - Externe SSD - True NAS installieren - **geht aber nur für VM‘s** - VM‘s per SCSI freigeben

# Backup Proxmox Datenbank - Wie funktioniert das ?

  - **`cat /etc/cron.d/pve-conf-backup`**

    - **`rsync. -va --delete /etc /rpool/pveconf` # alle 15 min - ab 3. Minute**
    - 
- Import Daten

  - vmdk vhdx raw qcow2 &gt; mounten vom original (VM aus!) /mnt/pve/nfsstore oder smbshare
  - zvol / lvm / usb / hdd /ssd  
  - `qm importdisk 100 /mnt/hypervfreigabe/dc.vhdx local-zfs` # (via samba)  
  - `qm importdisk 100 /mnt/pve/nfsstore/vmfs/id/dc/dc.vmdk local-zfs #` (via NFS oder SSHFS)
    
  - Echte Systeme (physikalische Server)

  - Clonezilla  
    - [https://pve.proxmox.com/wiki/Migration\_of\_servers\_to\_Proxmox\_VE](https://pve.proxmox.com/wiki/Migration_of_servers_to_Proxmox_VE)

      - Clonezilla Live CDs  
    - Disks erscheinen erst mal unused - mit Doppelklick hinzufügen und booten

# Backup und Monitoring

- Backup Dataset dürfen keine auto snapshots machen
  - **`zfs set com.sun:auto-snapshot=false backup`** # siehe Codeblock

```
zfs list # Ziel Backup Disk - Pool Backup
zfs create backup/repl -o com.sun:auto-snapshot=false 
zfs set com.sun:auto-snapshot=false backup 
bash-club-zfs-push-pull # auf Ziel ausführen

```
- **bashclub zfs-push-pull installieren**

``` 
git clone https://github.com/bashclub/bashclub-zfs-push-pull.git
cd bashclub-zfs-push-pull
chmod +x 02pull
bashclub-zfs
cp bashclub-zfs /usr/bin

vi 02pull # Anpassen - In for Schleife ein echo zum Testen
bashclub-zfs # Parameter I und R - alte Snapshot und Zwischen-snapshots mitnehmen # Prinzipiell pull !!! - Quelle kommt nicht auf das Ziel, sondern nur Ziel kommt auf Quelle
cp 02pull /etc/cron.hourly
```

> Für Trojaner sicher immer die "pull Methode" anwenden. Nur Ziel kommt auf die Quelle und nicht umgekehrt. 


## Monitoring 

- ID: backup-repl
- ZFS Pool: backup/repl
- Thin provision: Haken
- Block Size: 16k
- [https://github.com/bashclub/check-zfs-replication](https://github.com/bashclub/check-zfs-replication)

```
wget -O /usr/local/bin/checkzfs https://raw.githubusercontent.com/bashclub/check-zfs-replication/main/checkzfs.py  
chmod +x /usr/local/bin/checkzfs 
checkzfs --sourceonly 
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90 
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90 --columns +message 

```

- `wget -O /usr/local/bin/checkzfs https://raw.githubusercontent.com/bashclub/check-zfs-replication/main/checkzfs.py`
  - Keep: Hours 96, dayly 14
  - ProxMox GUI  
    - Storage - Add ZFS
  - ```
          cd /etc/pve/qemu-server 
          cp 101.conf 9101.conf 
          vi 9101.conf 
        
    ```
  - Kommando im vi ausführen - local-zfs durch backup-repl ersetzen
    - :%s/local-zfs/backup-repl/g # vi command 

  - Swap entfernen  
  - DVD Laufwerke entfernen
  - Name am Anfang repl- anfügen
- GUI der VM 9101  
    - Netzwerkkarte deaktivieren # Befehl kann man nachher in der conf nachschauen
    - Autostart disablen
  - VM 9101 starten # aber Replikationszeit beachten - cron.hourly
  - LXC Container kann mittlerweile die Netzwerkkarte deaktivieren - alternativ in anderen vswitch

```
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90 --columns +message --output checkmk
# Datei generieren und auf anderen Server kopieren - über scp 
zfs mount -a 
ls /backup/repl/subvol-100-disk-0/etc/pmg 
mkdir /mnt/restore 

mount /dev/zvol/backup/repl/vm-101-disk-1-part3 /mnt/restore 
ls /mnt/restore # Damit kann man Daten aus dem Windows zurückspielen 
umount /mnt/restore 

zfs create backup/klon -o com.sun:auto-snapshot=false 
zfs list -t snapshot backup/repl/vm-101-disk-1 
zfs clone backup/repl/vm-101-disk1@bashclub-zfs_2023-09-28_16:21:30 backup/klon/vm-101-disk-1 

mount /dev/zvol/backup/klon/vm-101-disk-1-part3 /mnt/restore 
ls /mnt/restore 
vi /etc/pve/qemu-server/9101.conf # Anpassung das der Klon verwendet wird 
    
```
- VM aus Klon booten und sich anschauen ...
```
umount /mnt/restore 
zfs get guid 
zfs get guid | grep bashclub-zfs_2023-09-28_16:46:50 
zfs get creation rpool/data/subvol-100-disk-0@bashclub-zfs_2023-09-28_16:46:50
```


- **zfs Replication für arme**

- **backup/repl # pull** - Trojaner sicher

```
zfs snapshot rpool/data/vm-100-disk-0@snap1 # snapshot auslösen 
zfs send rpool/data/vm-100-disk-0@snap1 | zfs recv -dvF backup/repl # local 
zfs send rpool/data/vm-100-disk-0@snap1 | ssh rot@zielip zfs recv -dvF # anderes System

```

- **backup/repl # push** - Quelle kommt auf Ziel !!! (Risiko Securtiy)

```
ssh root@sourceip zfs send rpool/data/vm-100-disk-0@snap1 | zfs recv -dvF backup/repl # pull

```

- checkzfs mit Mail - dafür muss Mail konfiguriert sein

```
checkzfs --filter rpool/data/ --replicafilter backup/repl --threshold 75,90 --columns+message --output mail

```

# Verschlüsselung mit Proxmox, ZFS und Debian / Windows

> ##### Hier mal zur Überlegung was für einen Sinn macht

<div id="bkmrk-">  
</div>##### Physischer PC

- Festplatte 
    - Partition mit FS 
        - Mount / c:\\


##### Proxmox LXC

<div id="bkmrk--2">  
</div>- Festplatte+Festplatte als Raid 
    - Dataset 
        - Mountpoint /rpool/data/subvol-100-disk-0

<div id="bkmrk--3">  
</div>##### Proxmox LXC ZFS verschlüsselt

<div id="bkmrk--4">  
</div>- Festplatte+Festplatte als Raid 
    - Dataset entsperrt 
        - Mountpoint /rpool/data/subvol-100-disk-0

> zfs create rpool/encrypted -o keylocation=prompt -o keyformat=passphrase -o encryption=on
> 
> \#Datastore im PVE anlegen auf rpool/encrypted
> 
> nach Reboot zfs load-key #Passphrase eingeben, dann pct start xxx
> 
> Alternativ kann man das auch von außen alle Stunde auf Verdacht oder nach Prüfung per SSH auslösen

##### Proxmox VM

<div id="bkmrk--5">  
</div>- Festplatte+Festplatte als Raid 
    - ZVOL 
        - Gast Partition mit FS 
            - Mount / c:\\

<div id="bkmrk--6">  
</div><div id="bkmrk--7">  
</div>##### Proxmox VM ZFS verschlüsselt

<div id="bkmrk--8">  
</div>- Festplatte+Festplatte als Raid 
    - ZVOL **entsperrt**
        - Gast Partition mit FS 
            - Mount / c:\\

> zfs create rpool/encrypted -o keylocation=prompt -o keyformat=passphrase -o encryption=on
> 
> \#Datastore im PVE anlegen auf rpool/encrypted
> 
> nach Reboot zfs load-key #Passphrase eingeben, dann qm start xxx
> 
> Alternativ kann man das auch von außen alle Stunde auf Verdacht oder nach Prüfung per SSH auslösen

##### Proxmox VM Gast verschlüsselt

<div id="bkmrk--9">  
</div>- Festplatte+Festplatte als Raid 
    - ZVOL
    - Volumemanager 
        - LV mit **encrypted** FS 
            - **entsperrter** Mount / c:\\

> <div>Verschlüsselung wird bei der Installation vorgenommen. Nach jedem Reboot muss das Passwort in KVM Konsole von Proxmox eingegeben werden. Automatisierung nicht möglich</div>

> ##### Abschließend ist das Ziel zu prüfen. Verschlüsselung gegen Diebstahl ist die ZFS Lösung völlig ausreichend. Replikation geht mit Raw (send -w), Backup nur wenn entsperrt ist. Eine Sicherung einer intern verschlüsselten VM ist jederzeit, mit jeder Methode (PBS, ZFS) möglich, muss halt in jeder VM vorgenommen werden, LXCs lassen sich verschlüsselt nur gegen Diebstahl schützen, nicht gegen Einsicht.

<div id="bkmrk--10"></div>